
Tổng hợp câu hỏi phỏng vấn Java Collections (phần 1)
Tổng quan về Collections
Tổng quan Java Collections
Java Collections, còn gọi là container, chủ yếu được phát triển từ hai interface lớn: một là interface Collection, chủ yếu dùng để lưu trữ các phần tử đơn; một là interface Map, chủ yếu dùng để lưu trữ các cặp key-value. Bên dưới interface Collection còn có ba sub-interface chính: List, Set, Queue.
Java Collections Framework như hình dưới đây:
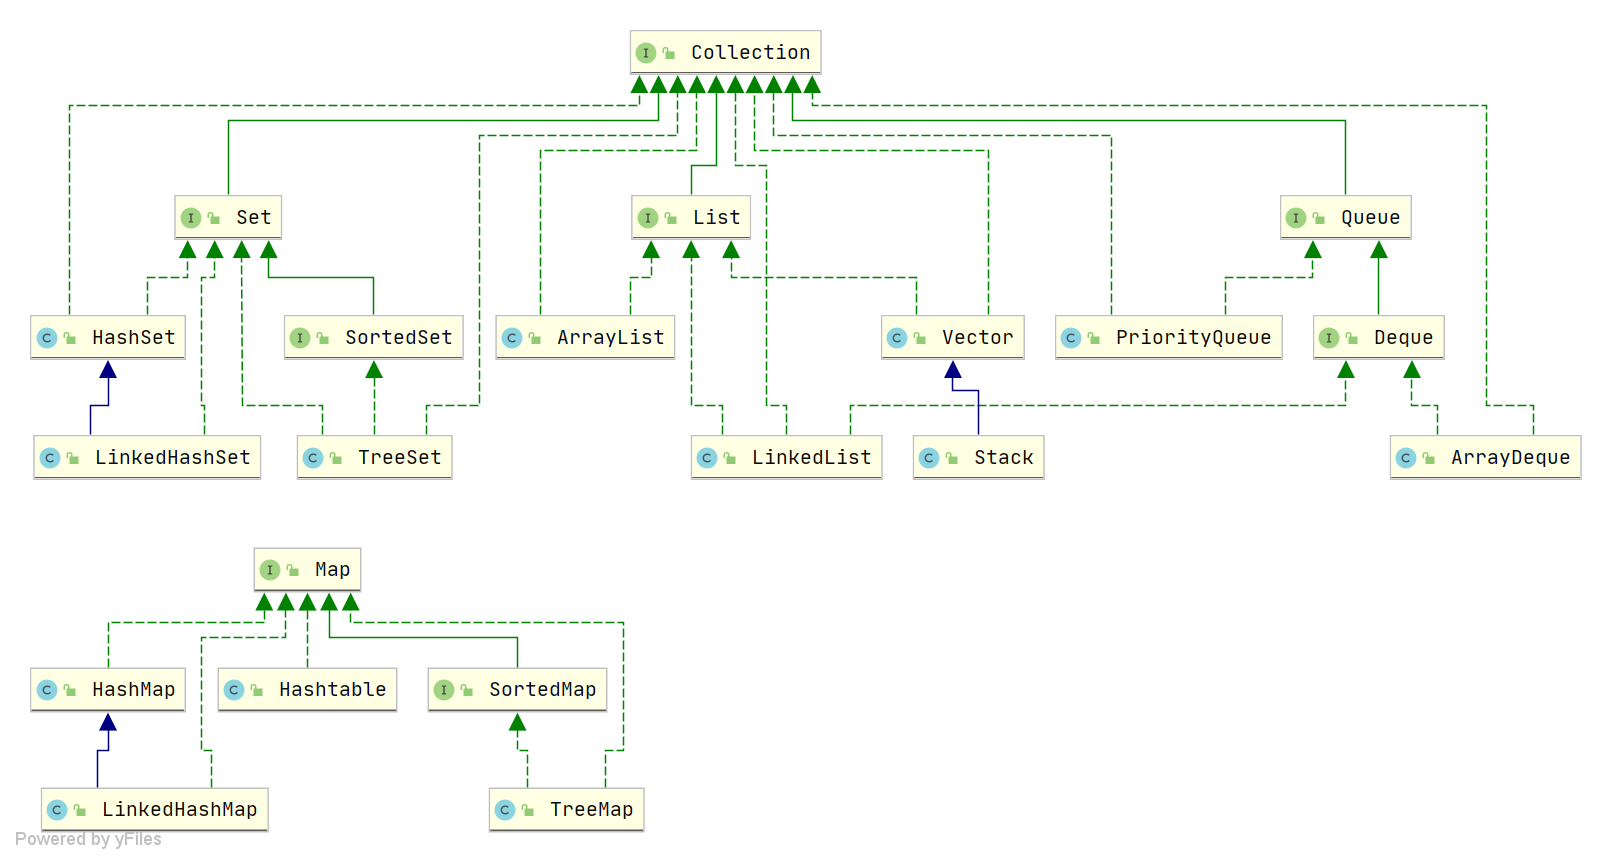
Lưu ý: Hình chỉ liệt kê các quan hệ kế thừa và phát triển chính, không liệt kê tất cả quan hệ. Chẳng hạn, hình đã lược bỏ các abstract class như AbstractList, NavigableSet và một số class hỗ trợ khác. Nếu muốn tìm hiểu sâu hơn, bạn có thể tự xem source code.
⭐️ Hãy nói về sự khác nhau giữa List, Set, Queue, Map?
List(trợ thủ đắc lực cho thứ tự): Các phần tử được lưu trữ có thứ tự và có thể trùng lặp.Set(chú trọng tính duy nhất): Các phần tử được lưu trữ không thể trùng lặp.Queue(máy phát số phục vụ xếp hàng): Thứ tự trước sau được xác định theo quy tắc xếp hàng cụ thể; các phần tử được lưu trữ có thứ tự và có thể trùng lặp.Map(chuyên gia tìm kiếm bằng key): Lưu trữ bằng cặp key-value, tương tự hàm toán học y=f(x), "x" đại diện cho key, "y" đại diện cho value; key không có thứ tự và không thể trùng lặp, value không có thứ tự và có thể trùng lặp, mỗi key nhiều nhất ánh xạ đến một value. Lưu ý, "không có thứ tự" ở đây chỉ các implementation nhưHashMap, trong đó các cặp key-value không có thứ tự liên kết rõ ràng. Các implementation nhưLinkedHashMapvàTreeMapcó thứ tự; chúng dùng data structure bổ sung (linked list hai chiều hoặc red-black tree) để duy trì thứ tự của các cặp key-value.
Tổng hợp data structure bên trong Collections Framework
Trước tiên hãy xem các collection bên dưới interface Collection.
List
ArrayList: arrayObject[]. Xem chi tiết tại: Phân tích source code ArrayList.Vector: arrayObject[].LinkedList: linked list hai chiều (trước JDK1.6 là linked list vòng, JDK1.7 đã bỏ tính vòng). Xem chi tiết tại: Phân tích source code LinkedList.
Set
HashSet(không có thứ tự, duy nhất): Được triển khai dựa trênHashMap, bên dưới dùngHashMapđể lưu trữ phần tử.LinkedHashSet:LinkedHashSetlà subclass củaHashSet, bên trong được triển khai bằngLinkedHashMap.TreeSet(có thứ tự, duy nhất): red-black tree (cây nhị phân sắp xếp tự cân bằng).
Queue
PriorityQueue: Dùng arrayObject[]để triển khai min-heap. Xem chi tiết tại: Phân tích source code PriorityQueue.DelayQueue:PriorityQueue. Xem chi tiết tại: Phân tích source code DelayQueue.ArrayDeque: dynamic array hai chiều có thể mở rộng.
Tiếp theo hãy xem các collection bên dưới interface Map.
Map
HashMap: Trước JDK1.8,HashMapgồm array + linked list; array là phần chính củaHashMap, còn linked list chủ yếu tồn tại để giải quyết hash collision (giải quyết collision bằng phương pháp chaining). Từ JDK1.8, cách giải quyết hash collision đã có thay đổi lớn: khi độ dài linked list lớn hơn ngưỡng (mặc định là 8) (trước khi chuyển linked list thành red-black tree sẽ kiểm tra, nếu độ dài array hiện tại nhỏ hơn 64 thì sẽ mở rộng array trước thay vì chuyển thành red-black tree), linked list được chuyển thành red-black tree để giảm thời gian tìm kiếm. Xem chi tiết tại: Phân tích source code HashMap; các khái niệm cơ bản có thể xem trước Tổng hợp câu hỏi phỏng vấn Hash Table.LinkedHashMap:LinkedHashMapkế thừaHashMap, nên bên dưới vẫn dựa trên cấu trúc hash dạng chaining, tức gồm array và linked list hoặc red-black tree. Ngoài ra, trên cơ sở cấu trúc trên,LinkedHashMapbổ sung một linked list hai chiều để cấu trúc trên có thể duy trì thứ tự chèn của các cặp key-value. Đồng thời, thông qua các thao tác tương ứng trên linked list, nó triển khai logic liên quan đến thứ tự truy cập. Xem chi tiết tại: Phân tích source code LinkedHashMap; bài tập tự viết LRU có thể xem tại Tổng hợp câu hỏi phỏng vấn LRU Cache.Hashtable: Gồm array + linked list; array là phần chính củaHashtable, còn linked list chủ yếu tồn tại để giải quyết hash collision.TreeMap: red-black tree (cây nhị phân sắp xếp tự cân bằng).
Chọn collection như thế nào?
Bạn chủ yếu chọn collection phù hợp dựa trên đặc điểm của từng collection. Ví dụ:
- Khi cần lấy value dựa trên key, chọn collection bên dưới interface
Map; khi cần sắp xếp thì chọnTreeMap, khi không cần sắp xếp thì chọnHashMap, khi cần đảm bảo thread-safe thì chọnConcurrentHashMap. - Khi chỉ cần lưu trữ value, chọn collection triển khai interface
Collection; khi cần đảm bảo phần tử duy nhất, chọn collection triển khai interfaceSetnhưTreeSethoặcHashSet; khi không cần đảm bảo tính duy nhất, chọn collection triển khai interfaceListnhưArrayListhoặcLinkedList, sau đó tiếp tục chọn dựa trên đặc điểm của collection triển khai các interface này.
Tại sao cần sử dụng Collections?
Khi cần lưu trữ một nhóm dữ liệu cùng kiểu, array là một trong những container thường dùng và cơ bản nhất. Tuy nhiên, việc dùng array để lưu trữ object có một số hạn chế, vì trong quá trình phát triển thực tế, kiểu dữ liệu và số lượng dữ liệu được lưu trữ rất đa dạng và không xác định. Lúc này Java Collections phát huy tác dụng. So với array, Java Collections cung cấp phương thức linh hoạt và hiệu quả hơn để lưu trữ nhiều object dữ liệu. Các collection class và interface khác nhau trong Java Collections Framework có thể lưu trữ object thuộc nhiều kiểu và số lượng khác nhau, đồng thời còn hỗ trợ nhiều cách thao tác đa dạng. So với array, ưu điểm của Java Collections là kích thước có thể thay đổi, hỗ trợ generic và có algorithm tích hợp sẵn. Nhìn chung, Java Collections tăng tính linh hoạt trong việc lưu trữ và xử lý dữ liệu, thích ứng tốt hơn với nhu cầu dữ liệu đa dạng trong phát triển software hiện đại và hỗ trợ viết code chất lượng cao.
List
⭐️ Sự khác nhau giữa ArrayList và Array (array)?
Bên trong ArrayList được triển khai dựa trên dynamic array, sử dụng linh hoạt hơn Array (static array):
ArrayListtự động mở rộng theo số phần tử thực tế được lưu trữ, cũng có thể chủ động thu nhỏ array bên dưới thông quatrimToSize(), cònArraykhông thể thay đổi độ dài sau khi được tạo.ArrayListcho phép dùng generic để đảm bảo type-safe, cònArraythì không.ArrayListchỉ có thể lưu trữ object. Với dữ liệu primitive type, cần dùng wrapper class tương ứng (như Integer, Double...).Arraycó thể trực tiếp lưu trữ dữ liệu primitive type hoặc object.ArrayListhỗ trợ các thao tác thường gặp như insert, delete, traverse, đồng thời cung cấp nhiều API method phong phú nhưadd(),remove().Arraychỉ là array có độ dài cố định, chỉ có thể truy cập phần tử theo index, không có khả năng thêm hoặc xóa phần tử động.- Khi tạo
ArrayListkhông cần chỉ định kích thước, còn khi tạoArraybắt buộc phải chỉ định kích thước.
Dưới đây là so sánh đơn giản khi sử dụng hai loại này:
Array:
 // Khởi tạo array kiểu String
 String[] stringArr = new String[]{"hello", "world", "!"};
 // Thay đổi value của phần tử trong array
 stringArr[0] = "goodbye";
 System.out.println(Arrays.toString(stringArr));// [goodbye, world, !]
 // Xóa phần tử trong array, cần tự di chuyển các phần tử phía sau
 for (int i = 0; i < stringArr.length - 1; i++) {
     stringArr[i] = stringArr[i + 1];
 }
 stringArr[stringArr.length - 1] = null;
System.out.println(Arrays.toString(stringArr));// [world, !, null]ArrayList:
// Khởi tạo ArrayList kiểu String
 ArrayList<String> stringList = new ArrayList<>(Arrays.asList("hello", "world", "!"));
// Thêm phần tử vào ArrayList
 stringList.add("goodbye");
 System.out.println(stringList);// [hello, world, !, goodbye]
 // Thay đổi phần tử trong ArrayList
 stringList.set(0, "hi");
 System.out.println(stringList);// [hi, world, !, goodbye]
 // Xóa phần tử trong ArrayList
 stringList.remove(0);
 System.out.println(stringList); // [world, !, goodbye]
Sự khác nhau giữa ArrayList và Vector? (Chỉ cần biết)
ArrayListlà implementation class chính củaList, bên dưới dùngObject[]để lưu trữ, phù hợp với thao tác tìm kiếm thường xuyên, không thread-safe.Vectorlà implementation class lâu đời củaList, bên dưới dùngObject[]để lưu trữ, thread-safe.
Sự khác nhau giữa Vector và Stack? (Chỉ cần biết)
VectorvàStackđều thread-safe, đều dùng keywordsynchronizedđể đồng bộ hóa.Stackkế thừaVector, là stack LIFO, cònVectorlà một list.
Cùng với sự phát triển của lập trình concurrency trong Java, Vector và Stack đã lỗi thời, nên dùng concurrent collection class (ví dụ ConcurrentHashMap, CopyOnWriteArrayList...) hoặc tự triển khai phương thức thread-safe để cung cấp khả năng thao tác multi-thread an toàn.
ArrayList có thể thêm giá trị null không?
ArrayList có thể lưu trữ object thuộc mọi kiểu, bao gồm cả giá trị null. Tuy nhiên, không nên thêm giá trị null vào ArrayList; giá trị null không có ý nghĩa, khiến code khó bảo trì, chẳng hạn quên xử lý null sẽ dẫn đến NullPointerException.
Ví dụ code:
ArrayList<String> listOfStrings = new ArrayList<>();
listOfStrings.add(null);
listOfStrings.add("java");
System.out.println(listOfStrings);
Output:
[null, java]⭐️ Độ phức tạp thời gian khi insert và delete phần tử trong ArrayList?
Với insert:
- Insert ở đầu: Vì cần lần lượt di chuyển tất cả phần tử về sau một vị trí, nên độ phức tạp thời gian là O(n).
- Insert ở cuối: Khi capacity của
ArrayListchưa đạt giới hạn, độ phức tạp thời gian khi thêm phần tử vào cuối list là O(1), vì chỉ cần thêm một phần tử ở cuối array; khi capacity đã đạt giới hạn và cần mở rộng, phải thực hiện một thao tác O(n) để copy array cũ sang array mới lớn hơn, sau đó thực hiện thao tác O(1) để thêm phần tử. - Insert tại vị trí chỉ định: Cần di chuyển tất cả phần tử phía sau vị trí mục tiêu về sau một vị trí, rồi đặt phần tử mới vào vị trí chỉ định. Quá trình này cần di chuyển trung bình n/2 phần tử, nên độ phức tạp thời gian là O(n).
Với delete:
- Delete ở đầu: Vì cần lần lượt di chuyển tất cả phần tử về trước một vị trí, nên độ phức tạp thời gian là O(n).
- Delete ở cuối: Khi phần tử bị xóa nằm ở cuối list, độ phức tạp thời gian là O(1).
- Delete tại vị trí chỉ định: Cần di chuyển tất cả phần tử phía sau phần tử mục tiêu về trước một vị trí để lấp khoảng trống do phần tử bị xóa để lại, nên cần di chuyển trung bình n/2 phần tử, độ phức tạp thời gian là O(n).
Dưới đây là một ví dụ đơn giản:
// Array bên dưới của ArrayList có kích thước 10, hiện đang lưu trữ 7 phần tử
+---+---+---+---+---+---+---+---+---+---+
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |   |   |   |
+---+---+---+---+---+---+---+---+---+---+
  0   1   2   3   4   5   6   7   8   9
// Insert một phần tử 8 tại index 1, tất cả phần tử phía sau phần tử đó phải di chuyển sang phải một vị trí
+---+---+---+---+---+---+---+---+---+---+
| 1 | 8 | 2 | 3 | 4 | 5 | 6 | 7 |   |   |
+---+---+---+---+---+---+---+---+---+---+
  0   1   2   3   4   5   6   7   8   9
// Xóa phần tử tại index 1, tất cả phần tử phía sau phần tử đó phải di chuyển sang trái một vị trí
+---+---+---+---+---+---+---+---+---+---+
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |   |   |   |
+---+---+---+---+---+---+---+---+---+---+
  0   1   2   3   4   5   6   7   8   9
⭐️ Độ phức tạp thời gian khi insert và delete phần tử trong LinkedList?
- Insert/delete ở đầu: Chỉ cần sửa pointer của head node là hoàn tất thao tác insert/delete, nên độ phức tạp thời gian là O(1).
- Insert/delete ở cuối: Chỉ cần sửa pointer của tail node là hoàn tất thao tác insert/delete, nên độ phức tạp thời gian là O(1).
- Insert/delete tại vị trí chỉ định: Cần di chuyển đến vị trí chỉ định trước, sau đó sửa pointer của node tương ứng để hoàn tất insert/delete. Tuy nhiên, vì có pointer đầu và cuối, có thể bắt đầu từ pointer gần hơn, nên trung bình cần traverse n/4 phần tử, độ phức tạp thời gian là O(n).
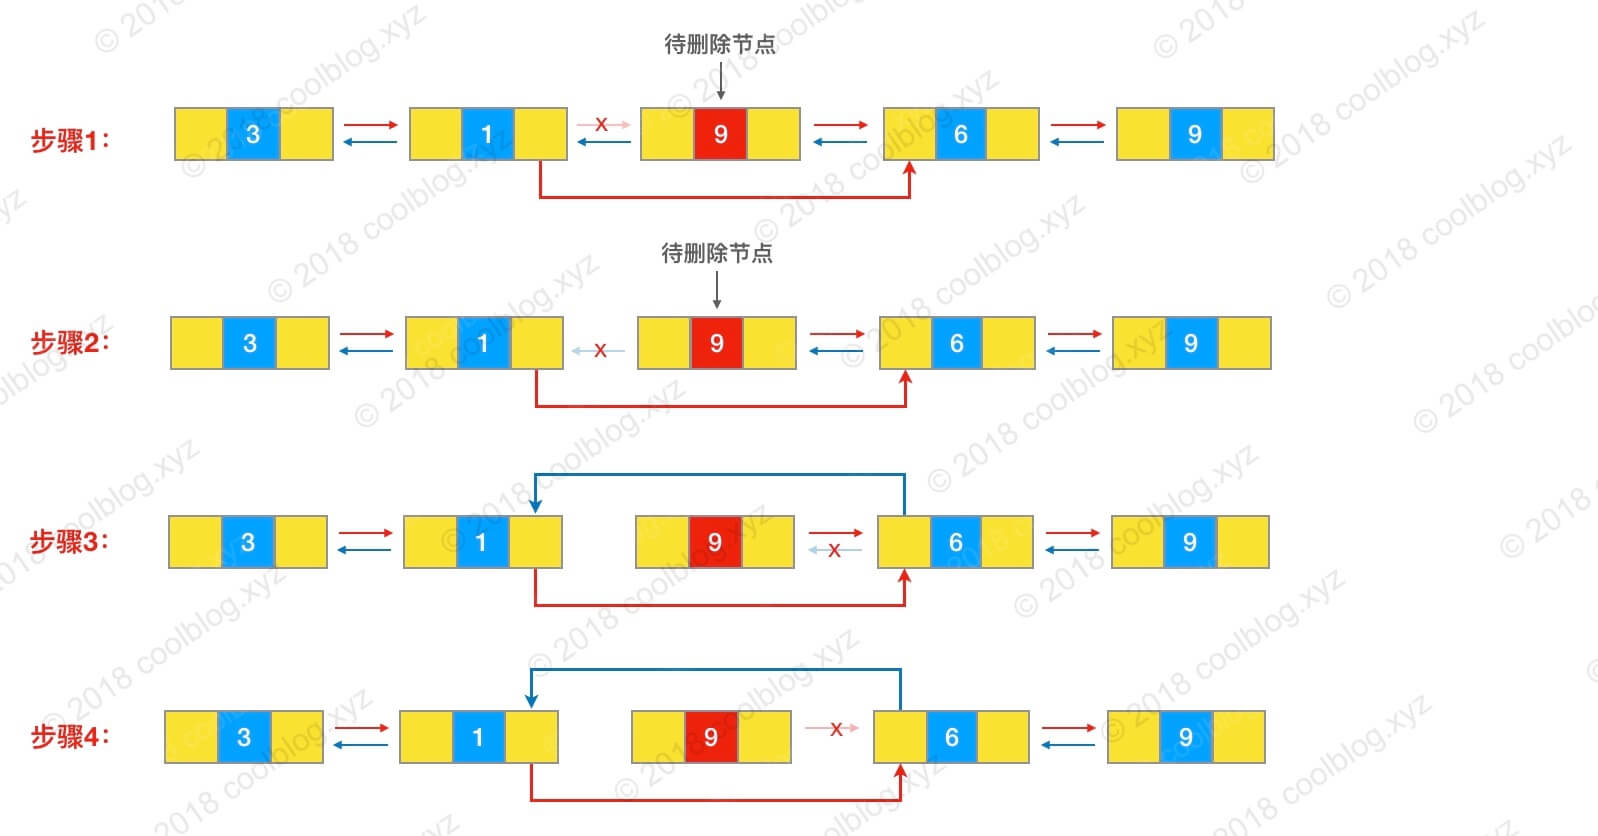
Dưới đây là một ví dụ đơn giản: giả sử cần xóa node 9, trước tiên cần traverse linked list để tìm node đó. Sau đó thay đổi liên kết của các node tương ứng. Xem source code cụ thể tại: Phân tích source code LinkedList.
Tại sao LinkedList không thể triển khai interface RandomAccess?
RandomAccess là một marker interface, dùng để cho biết class triển khai interface này hỗ trợ random access (tức có thể truy cập nhanh phần tử thông qua index). Vì data structure bên dưới của LinkedList là linked list, địa chỉ bộ nhớ không liên tiếp, chỉ có thể định vị thông qua pointer, không hỗ trợ random access nhanh, nên không thể triển khai interface RandomAccess.
⭐️ Sự khác nhau giữa ArrayList và LinkedList?
- Có đảm bảo thread-safe hay không:
ArrayListvàLinkedListđều không synchronized, tức không đảm bảo thread-safe. - Data structure bên dưới: Bên dưới
ArrayListdùng mảngObject; bên dướiLinkedListdùng data structure linked list hai chiều (trước JDK1.6 là linked list vòng, JDK1.7 đã bỏ tính vòng. Lưu ý sự khác nhau giữa linked list hai chiều và linked list hai chiều vòng được giới thiệu bên dưới!). - Insert và delete có bị ảnh hưởng bởi vị trí phần tử hay không:
ArrayListdùng array để lưu trữ, nên độ phức tạp thời gian của insert và delete bị ảnh hưởng bởi vị trí phần tử. Ví dụ khi thực hiện methodadd(E e),ArrayListmặc định nối phần tử chỉ định vào cuối list, trường hợp này có độ phức tạp thời gian là O(1). Nhưng nếu insert và delete phần tử tại vị trí chỉ định i (add(int index, E element)), độ phức tạp thời gian là O(n). Vì khi thực hiện các thao tác trên, phần tử thứ i và (n-i) phần tử phía sau trong collection đều phải di chuyển về sau hoặc về trước một vị trí.LinkedListdùng linked list để lưu trữ, nên insert hoặc delete ở đầu/cuối không bị ảnh hưởng bởi vị trí phần tử (add(E e),addFirst(E e),addLast(E e),removeFirst(),removeLast()), độ phức tạp thời gian là O(1). Nếu insert và delete phần tử tại vị trí chỉ địnhi(add(int index, E element),remove(Object o),remove(int index)), độ phức tạp thời gian là O(n), vì cần di chuyển đến vị trí chỉ định trước rồi mới insert và delete.
- Có hỗ trợ random access nhanh hay không:
LinkedListkhông hỗ trợ truy cập phần tử random hiệu quả, cònArrayList(triển khai interfaceRandomAccess) thì có. Random access nhanh là lấy nhanh object phần tử thông qua số thứ tự của phần tử (tương ứng methodget(int index)). - Mức sử dụng không gian bộ nhớ: Lãng phí không gian của
ArrayListchủ yếu nằm ở việc cuối list sẽ dự phòng một phần capacity; còn chi phí không gian củaLinkedListnằm ở việc mỗi phần tử cần nhiều không gian hơnArrayList(vì phải lưu successor trực tiếp, predecessor trực tiếp và dữ liệu).
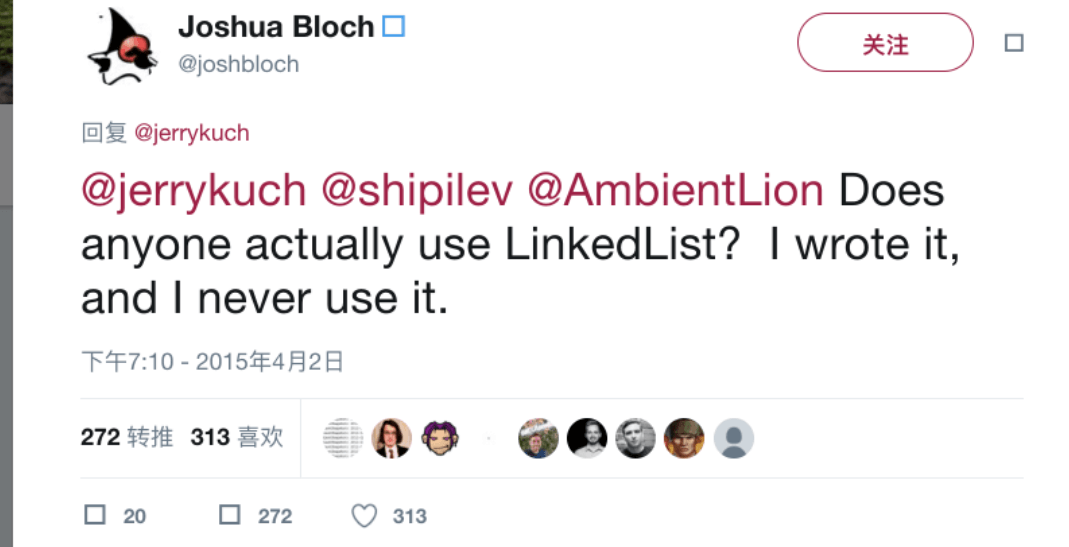
Thông thường chúng ta không dùng LinkedList trong project; hầu hết trường hợp cần LinkedList đều có thể dùng ArrayList thay thế, hơn nữa performance thường tốt hơn! Ngay cả Joshua Bloch (Josh Bloch), tác giả của LinkedList, cũng nói rằng bản thân ông chưa bao giờ dùng LinkedList.
Ngoài ra, đừng theo phản xạ cho rằng LinkedList là linked list nên phù hợp nhất với trường hợp insert/delete phần tử. Như đã nói ở trên, LinkedList chỉ có độ phức tạp thời gian gần O(1) khi insert hoặc delete ở đầu/cuối; trong các trường hợp khác, độ phức tạp thời gian trung bình của insert/delete phần tử đều là O(n).
Nội dung bổ sung: linked list hai chiều và linked list hai chiều vòng
Linked list hai chiều: Gồm hai pointer, một prev trỏ đến node trước, một next trỏ đến node sau.
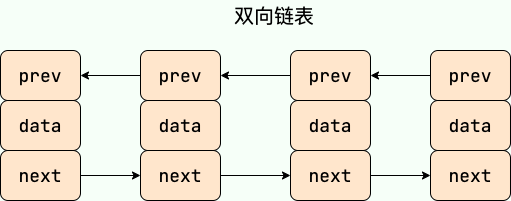
Linked list hai chiều vòng: next của node cuối trỏ đến head, còn prev của head trỏ đến node cuối, tạo thành một vòng.
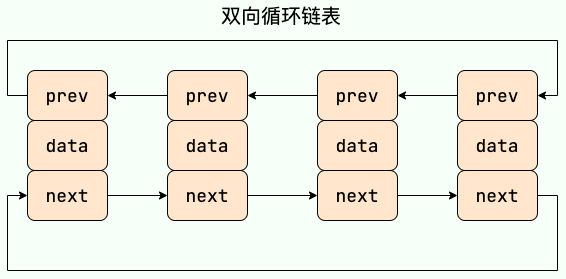
Nội dung bổ sung: interface RandomAccess
public interface RandomAccess {
}
Xem source code, có thể nhận thấy interface RandomAccess thực tế không định nghĩa gì cả. Vì vậy, theo tôi interface RandomAccess chỉ là một marker. Đánh dấu điều gì? Đánh dấu rằng class triển khai interface này có chức năng random access.
Trong method binarySearch(), method này kiểm tra list truyền vào có phải instance của RandomAccess hay không; nếu có thì gọi method indexedBinarySearch(), nếu không thì gọi method iteratorBinarySearch().
    public static <T>
    int binarySearch(List<? extends Comparable<? super T>> list, T key) {
        if (list instanceof RandomAccess || list.size()<BINARYSEARCH_THRESHOLD)
            return Collections.indexedBinarySearch(list, key);
        else
            return Collections.iteratorBinarySearch(list, key);
    }
ArrayList triển khai interface RandomAccess, còn LinkedList thì không. Tại sao? Tôi cho rằng vẫn liên quan đến data structure bên dưới! Bên dưới ArrayList là array, còn bên dưới LinkedList là linked list. Array vốn hỗ trợ random access, độ phức tạp thời gian là O(1), nên được gọi là random access nhanh. Linked list cần traverse đến vị trí cụ thể mới có thể truy cập phần tử tại vị trí đó, độ phức tạp thời gian là O(n), nên không hỗ trợ random access nhanh. ArrayList triển khai interface RandomAccess cho biết nó có chức năng random access nhanh. Interface RandomAccess chỉ là marker, không có nghĩa ArrayList chỉ có chức năng random access nhanh sau khi triển khai interface RandomAccess!
⭐️ Hãy nói về cơ chế mở rộng capacity của ArrayList
Xem chi tiết trong bài viết: Phân tích cơ chế mở rộng capacity của ArrayList.
fail-fast và fail-safe trong Collections là gì?
fail-fast (fail nhanh) và fail-safe (fail an toàn) là hai triết lý thiết kế và chiến lược xử lý lỗi hoàn toàn khác nhau của Java Collections Framework khi xử lý vấn đề concurrent modification.
Về fail-fast, dưới đây là cách một bài viết trên medium giải thích fail-fast và fail-safe:
Fail-fast systems are designed to immediately stop functioning upon encountering an unexpected condition. This immediate failure helps to catch errors early, making debugging more straightforward.
Tư tưởng fail nhanh là chủ động phát hiện và dừng hoạt động khi có thể xảy ra exception; phát hiện và dừng lỗi càng sớm thì càng giảm rủi ro hệ thống gặp lỗi lan truyền theo chuỗi.
Phần lớn collection trong package java.util (như ArrayList, HashMap) không thread-safe. Để sớm phát hiện rủi ro mất tính thread-safe do thao tác concurrent, cơ chế này duy trì một modCount để ghi lại số lần sửa đổi; trong quá trình iterator, nó đối chiếu expectedModCount với modCount để kiểm tra có thao tác concurrent hay không, từ đó triển khai fail nhanh và tránh thực thi code phức tạp không cần thiết khi xảy ra exception.
Ví dụ ArrayList (fail-fast):
     // Dùng ArrayList không thread-safe, đây là một collection fail-fast
      List<Integer> list = new ArrayList<>();
      CountDownLatch latch = new CountDownLatch(2);

      for (int i = 0; i < 5; i++) {
          list.add(i);
      }
      System.out.println("Initial list: " + list);

      Thread t1 = new Thread(() -> {
          try {
              for (Integer i : list) {
                  System.out.println("Iterator Thread (t1) sees: " + i);
                  Thread.sleep(100);
              }
          } catch (ConcurrentModificationException e) {
              System.err.println("!!! Iterator Thread (t1) caught ConcurrentModificationException as expected.");
          } catch (InterruptedException e) {
              e.printStackTrace();
          } finally {
              latch.countDown();
          }
      });

      Thread t2 = new Thread(() -> {
          try {
              Thread.sleep(50);
              System.out.println("-> Modifier Thread (t2) is removing element 1...");
              list.remove(Integer.valueOf(1));
              System.out.println("-> Modifier Thread (t2) finished removal.");
          } catch (InterruptedException e) {
              e.printStackTrace();
          } finally {
              latch.countDown();
          }
      });

      t1.start();
      t2.start();
      latch.await();

      System.out.println("Final list state: " + list);
Output:
Initial list: [0, 1, 2, 3, 4]
Iterator Thread (t1) sees: 0
-> Modifier Thread (t2) is removing element 1...
-> Modifier Thread (t2) finished removal.
!!! Iterator Thread (t1) caught ConcurrentModificationException as expected.
Final list state: [0, 2, 3, 4]
Sau khi thread t2 sửa list, thao tác iterator tiếp theo của thread t1 lập tức ném ConcurrentModificationException. Vì iterator của ArrayList sẽ kiểm tra modCount có bị thay đổi trong mỗi lần gọi next() hay không. Khi phát hiện collection bị sửa mà iterator không biết, nó lập tức fail nhanh để tránh tiếp tục thao tác trên dữ liệu không nhất quán và gây ra hậu quả không thể dự đoán.
Dưới đây là method next của iterator được gọi khi vòng for lấy phần tử tiếp theo. Có thể thấy checkForComodification bên trong chứa logic đối chiếu số lần sửa đổi:
 public E next() {
            // Kiểm tra có concurrent modification hay không
            checkForComodification();
            //......
            // Trả về phần tử tiếp theo
            return (E) elementData[lastRet = i];
        }

 final void checkForComodification() {
         // Khi số lần duyệt hiện tại và số lần sửa đổi dự kiến không nhất quán, sẽ ném ConcurrentModificationException
            if (modCount != expectedModCount)
                throw new ConcurrentModificationException();
        }
Còn fail-safe, tức fail an toàn, có nghĩa là ngay cả khi gặp tình huống bất ngờ vẫn có thể khôi phục và tiếp tục chạy, nên đặc biệt phù hợp với môi trường không chắc chắn hoặc không ổn định:
Fail-safe systems take a different approach, aiming to recover and continue even in the face of unexpected conditions. This makes them particularly suited for uncertain or volatile environments.
Tư tưởng này thường được dùng trong concurrent container. Implementation kinh điển nhất là CopyOnWriteArrayList, dùng tư tưởng copy-on-write để tạo một snapshot khi thực hiện thao tác sửa đổi; sau khi hoàn tất thao tác thêm hoặc xóa dựa trên snapshot này, reference array bên dưới của CopyOnWriteArrayList được trỏ đến array mới, từ đó tránh bị concurrent modification ảnh hưởng khi traverse. Tất nhiên cách này cũng có nhược điểm: khi traverse không thể nhận được kết quả theo thời gian thực:
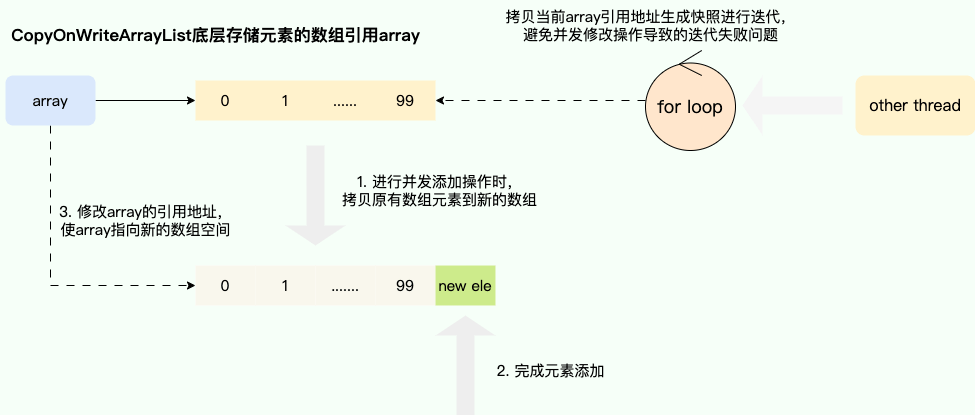
Tương ứng, dưới đây là code cốt lõi để CopyOnWriteArrayList triển khai fail-safe. Có thể thấy implementation của nó lấy reference của array thông qua getArray, sau đó dùng Arrays.copyOf để tạo snapshot của array; sau khi hoàn tất thao tác thêm dựa trên snapshot này, thay đổi địa chỉ tham chiếu mà biến array bên dưới trỏ đến, từ đó hoàn tất copy-on-write:
public boolean add(E e) {
        final ReentrantLock lock = this.lock;
        lock.lock();
        try {
            // Lấy array hiện có
            Object[] elements = getArray();
            int len = elements.length;
            // Copy snapshot bộ nhớ dựa trên array hiện có
            Object[] newElements = Arrays.copyOf(elements, len + 1);
            // Thực hiện thao tác thêm
            newElements[len] = e;
            // array trỏ đến array mới
            setArray(newElements);
            return true;
        } finally {
            lock.unlock();
        }
    }
Set
Sự khác nhau giữa Comparable và Comparator
Interface Comparable và interface Comparator đều là interface dùng để sắp xếp trong Java, đóng vai trò quan trọng trong việc so sánh kích thước và sắp xếp các object của implementation class:
- Interface
Comparablethực tế thuộc packagejava.lang, có methodcompareTo(Object obj)dùng để sắp xếp. - Interface
Comparatorthực tế thuộc packagejava.util, có methodcompare(Object obj1, Object obj2)dùng để sắp xếp.
Thông thường, khi cần custom sort một collection, có thể override method compareTo() hoặc compare(). Khi cần triển khai hai cách sort cho một collection, ví dụ tên bài hát và tên ca sĩ trong một object song lần lượt dùng một cách sort, có thể override method compareTo() và dùng Comparator tự tạo, hoặc dùng hai Comparator để triển khai sort tên bài hát và sort tên ca sĩ. Cách thứ hai nghĩa là chỉ có thể dùng phiên bản hai tham số của Collections.sort().
Custom sort bằng Comparator
ArrayList<Integer> arrayList = new ArrayList<Integer>();
arrayList.add(-1);
arrayList.add(3);
arrayList.add(3);
arrayList.add(-5);
arrayList.add(7);
arrayList.add(4);
arrayList.add(-9);
arrayList.add(-7);
System.out.println("Mảng ban đầu:");
System.out.println(arrayList);
// void reverse(List list): đảo ngược
Collections.reverse(arrayList);
System.out.println("Collections.reverse(arrayList):");
System.out.println(arrayList);

// void sort(List list), sắp xếp tăng dần theo thứ tự tự nhiên
Collections.sort(arrayList);
System.out.println("Collections.sort(arrayList):");
System.out.println(arrayList);
// Cách dùng custom sort
Collections.sort(arrayList, new Comparator<Integer>() {
    @Override
    public int compare(Integer o1, Integer o2) {
        return o2.compareTo(o1);
    }
});
System.out.println("Sau khi custom sort:");
System.out.println(arrayList);
Output:
Mảng ban đầu:
[-1, 3, 3, -5, 7, 4, -9, -7]
Collections.reverse(arrayList):
[-7, -9, 4, 7, -5, 3, 3, -1]
Collections.sort(arrayList):
[-9, -7, -5, -1, 3, 3, 4, 7]
Sau khi custom sort:
[7, 4, 3, 3, -1, -5, -7, -9]
Override method compareTo để sort theo tuổi
// Object person chưa triển khai interface Comparable nên bắt buộc phải triển khai, như vậy mới không xảy ra lỗi và dữ liệu trong treemap mới được sắp xếp theo thứ tự
// String của ví dụ trước đã mặc định triển khai interface Comparable. Xem chi tiết trong tài liệu API của class String; ngoài ra các class khác
// như class Integer cũng đã triển khai interface Comparable nên không cần triển khai thêm
public  class Person implements Comparable<Person> {
    private String name;
    private int age;

    public Person(String name, int age) {
        super();
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    /**
     * Override method compareTo để sort theo tuổi
     */
    @Override
    public int compareTo(Person o) {
        if (this.age > o.getAge()) {
            return 1;
        }
        if (this.age < o.getAge()) {
            return -1;
        }
        return 0;
    }
}
public static void main(String[] args) {
TreeMap<Person, String> pdata = new TreeMap<Person, String>();
pdata.put(new Person("Zhang San", 30), "zhangsan");
pdata.put(new Person("Li Si", 20), "lisi");
pdata.put(new Person("Wang Wu", 10), "wangwu");
pdata.put(new Person("Xiao Hong", 5), "xiaohong");
// Lấy value của key đồng thời lấy value tương ứng với key
Set<Person> keys = pdata.keySet();
for (Person key : keys) {
System.out.println(key.getAge() + "-" + key.getName());
}
}Output:
5-Xiao Hong
10-Wang Wu
20-Li Si
30-Zhang San
Tính không có thứ tự và không trùng lặp có ý nghĩa gì?
- Không có thứ tự không có nghĩa là ngẫu nhiên; không có thứ tự nghĩa là dữ liệu được lưu trữ trong array bên dưới không được thêm theo thứ tự của array index, mà được quyết định bởi hash value của dữ liệu.
- Không trùng lặp nghĩa là khi phần tử được thêm vào được đánh giá bằng
equals(), kết quả trả về là false; đồng thời cần override methodequals()và methodhashCode().
So sánh điểm giống và khác nhau giữa HashSet, LinkedHashSet và TreeSet
HashSet,LinkedHashSetvàTreeSetđều là implementation class của interfaceSet, đều đảm bảo phần tử duy nhất và đều không thread-safe.- Khác biệt chính giữa
HashSet,LinkedHashSetvàTreeSetnằm ở data structure bên dưới. Data structure bên dướiHashSetlà hash table (triển khai dựa trênHashMap). Data structure bên dướiLinkedHashSetlà linked list và hash table, thứ tự insert và lấy ra của phần tử tuân theo FIFO. Data structure bên dướiTreeSetlà red-black tree, các phần tử có thứ tự, cách sort gồm natural sort và custom sort. - Data structure bên dưới khác nhau cũng dẫn đến trường hợp sử dụng khác nhau.
HashSetdùng khi không cần đảm bảo thứ tự insert và lấy ra của phần tử;LinkedHashSetdùng khi cần đảm bảo thứ tự insert và lấy ra của phần tử tuân theo FIFO;TreeSetdùng khi cần hỗ trợ custom quy tắc sort phần tử.
Queue
Sự khác nhau giữa Queue và Deque
Queue là queue một đầu, chỉ có thể insert phần tử từ một đầu và delete phần tử ở đầu kia; implementation thường tuân theo quy tắc FIFO (first in, first out).
Queue mở rộng interface Collection, dựa trên cách xử lý khác nhau sau khi thao tác thất bại do vấn đề capacity có thể chia thành hai loại method: một loại ném exception sau khi thao tác thất bại, loại còn lại trả về special value.
Interface Queue | Ném exception | Trả về special value |
|---|---|---|
| Insert vào cuối queue | add(E e) | offer(E e) |
| Delete đầu queue | remove() | poll() |
| Truy vấn phần tử đầu queue | element() | peek() |
Deque là queue hai đầu, có thể insert hoặc delete phần tử ở cả hai đầu queue.
Deque mở rộng interface Queue, bổ sung các method insert và delete ở đầu và cuối queue; tương tự, dựa trên cách xử lý sau khi thất bại có thể chia thành hai loại:
Interface Deque | Ném exception | Trả về special value |
|---|---|---|
| Insert vào đầu queue | addFirst(E e) | offerFirst(E e) |
| Insert vào cuối queue | addLast(E e) | offerLast(E e) |
| Delete đầu queue | removeFirst() | pollFirst() |
| Delete cuối queue | removeLast() | pollLast() |
| Truy vấn phần tử đầu queue | getFirst() | peekFirst() |
| Truy vấn phần tử cuối queue | getLast() | peekLast() |
Trên thực tế, Deque còn cung cấp các method khác như push() và pop(), có thể dùng để mô phỏng stack.
Sự khác nhau giữa ArrayDeque và LinkedList
ArrayDeque và LinkedList đều triển khai interface Deque, cả hai đều có chức năng queue, nhưng khác nhau như thế nào?
ArrayDequeđược triển khai dựa trên array có độ dài thay đổi và hai pointer, cònLinkedListđược triển khai bằng linked list.ArrayDequekhông hỗ trợ lưu trữ dữ liệuNULL, cònLinkedListthì có.ArrayDequechỉ được giới thiệu từ JDK1.6, cònLinkedListđã tồn tại từ JDK1.2.Khi insert vào
ArrayDequecó thể xảy ra quá trình mở rộng capacity, nhưng sau khi tính amortized thì thao tác insert vẫn là O(1).LinkedListkhông cần mở rộng capacity, nhưng mỗi lần insert dữ liệu đều cần cấp phát heap space mới, nên performance amortized chậm hơn.
Xét về performance, chọn ArrayDeque để triển khai queue tốt hơn LinkedList. Ngoài ra, ArrayDeque cũng có thể dùng để triển khai stack.
Hãy nói về PriorityQueue
PriorityQueue được giới thiệu trong JDK1.5. Điểm khác biệt với Queue là thứ tự dequeue của phần tử liên quan đến priority, tức phần tử có priority cao nhất luôn được dequeue trước.
Dưới đây là một số điểm chính liên quan:
PriorityQueueđược triển khai bằng data structure binary heap, bên dưới dùng array có độ dài thay đổi để lưu trữ dữ liệu.PriorityQueuetriển khai insert phần tử và delete phần tử ở heap top trong độ phức tạp thời gian O(logn) thông qua thao tác heapify up và heapify down.PriorityQueuekhông thread-safe và không hỗ trợ lưu trữNULL. Nếu không cung cấpComparator, phần tử cần triển khaiComparable; nếu cung cấpComparator, các phần tử phải có thể được comparator đó so sánh với nhau.PriorityQueuemặc định là min-heap, nhưng có thể nhận mộtComparatorlàm constructor parameter để custom thứ tự priority của phần tử.
Trong phỏng vấn, PriorityQueue thường xuất hiện nhiều hơn khi tự viết algorithm, các bài điển hình gồm heap sort, tìm số lớn thứ K, traverse weighted graph..., nên cần thành thạo cách sử dụng.
Nếu muốn bổ sung trước template algorithm cho heap và Top K, có thể xem Giải thích chi tiết về heap và Tổng hợp câu hỏi phỏng vấn Top K.
BlockingQueue là gì?
BlockingQueue (blocking queue) là một interface kế thừa Queue. Nó cung cấp bốn cách xử lý riêng cho thao tác insert và remove: ném exception, trả về special value, block liên tục và chờ timeout. Trong đó, take() có thể block khi queue rỗng, còn put() có thể block khi queue bị giới hạn capacity đã đầy.
public interface BlockingQueue<E> extends Queue<E> {
  // ...
}
BlockingQueue thường được dùng trong mô hình producer-consumer: producer thread thêm data vào queue, consumer thread lấy data ra khỏi queue để xử lý.
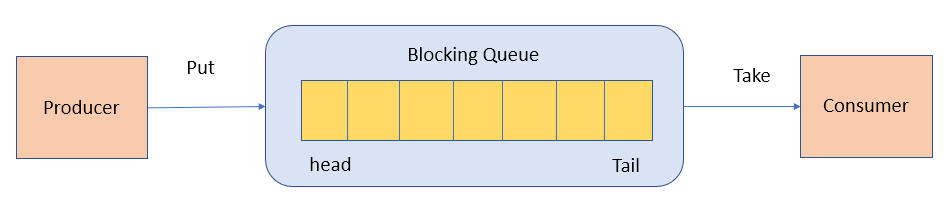
Các implementation class của BlockingQueue gồm những gì?
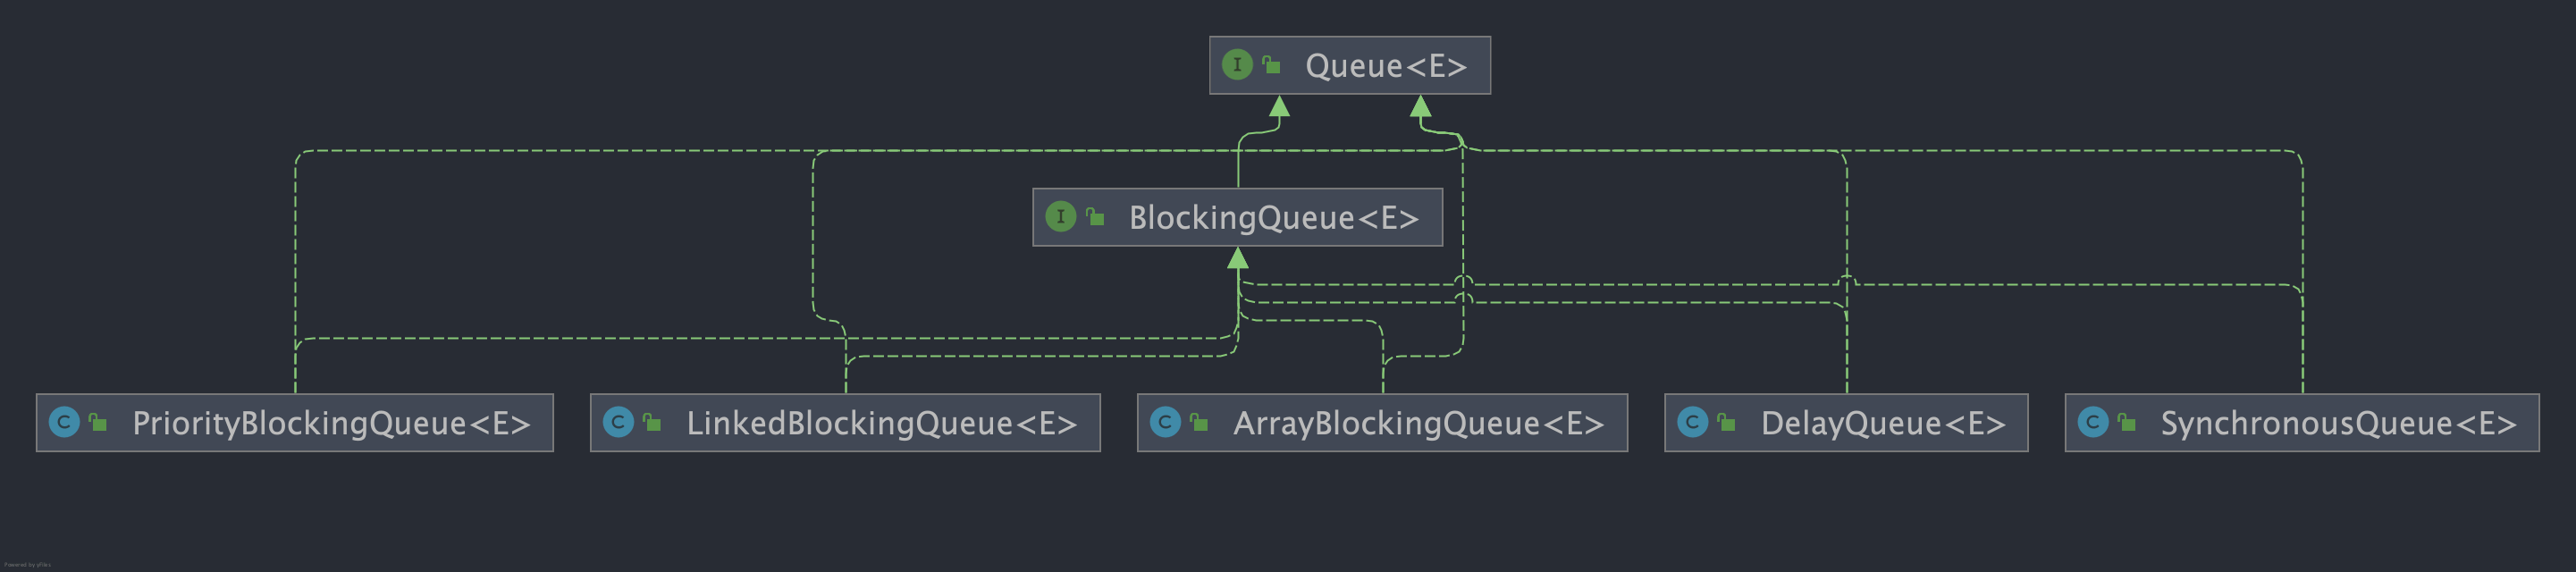
Các implementation class blocking queue thường dùng trong Java gồm:
ArrayBlockingQueue: bounded blocking queue được triển khai bằng array. Khi tạo cần chỉ định capacity, đồng thời hỗ trợ cơ chế lock access fair và unfair.LinkedBlockingQueue: blocking queue có thể bounded, được triển khai bằng singly linked list. Khi tạo có thể chỉ định capacity; nếu không chỉ định thì mặc định làInteger.MAX_VALUE. Khác vớiArrayBlockingQueue, nó chỉ hỗ trợ cơ chế lock access unfair.PriorityBlockingQueue: unbounded blocking queue hỗ trợ sort theo priority. Phần tử phải triển khai interfaceComparablehoặc truyền objectComparatorvào constructor, đồng thời không thể insert phần tử null.SynchronousQueue: synchronous queue, là một blocking queue không lưu trữ phần tử. Mỗi thao tác insert đều phải chờ thao tác delete tương ứng và ngược lại, thao tác delete cũng phải chờ thao tác insert. Vì vậy,SynchronousQueuethường dùng để truyền data trực tiếp giữa các thread.DelayQueue: delay queue, phần tử chỉ có thể dequeue sau khi đến thời gian delay được chỉ định.- ……
Trong phát triển hằng ngày, thực tế các queue này đều không được dùng nhiều, chỉ cần biết.
⭐️ Sự khác nhau giữa ArrayBlockingQueue và LinkedBlockingQueue?
ArrayBlockingQueue và LinkedBlockingQueue là hai implementation blocking queue thường dùng trong package concurrency của Java, cả hai đều thread-safe. Tuy nhiên, giữa chúng còn có những điểm khác nhau sau:
- Implementation bên dưới:
ArrayBlockingQueuedựa trên array, cònLinkedBlockingQueuedựa trên linked list. - Có bounded hay không:
ArrayBlockingQueuelà bounded queue, bắt buộc chỉ định capacity khi tạo. Khi tạoLinkedBlockingQueuecó thể không chỉ định capacity, mặc định làInteger.MAX_VALUE, tức unbounded. Tuy nhiên cũng có thể chỉ định queue size để trở thành bounded. - Lock có tách biệt hay không: Lock trong
ArrayBlockingQueuekhông tách biệt, producer và consumer dùng cùng một lock; lock trongLinkedBlockingQueueđược tách biệt, producer dùngputLock, consumer dùngtakeLock, từ đó tránh lock contention giữa producer thread và consumer thread. - Mức sử dụng bộ nhớ:
ArrayBlockingQueuecần cấp phát trước bộ nhớ array, cònLinkedBlockingQueuecấp phát động bộ nhớ cho linked list node. Điều này nghĩa làArrayBlockingQueuechiếm một lượng memory nhất định ngay khi tạo, hơn nữa memory được cấp phát thường lớn hơn memory thực tế sử dụng; cònLinkedBlockingQueuetăng dần mức chiếm dụng memory theo số phần tử.
Đọc thêm về Data Structure
Các câu hỏi phỏng vấn Java Collections thường hỏi sâu đến data structure bên dưới. Nên ôn tập kết hợp với một số bài viết dưới đây:
- Giải thích chi tiết về linear data structure: Hiểu quan hệ giữa array, linked list, stack, queue và
ArrayList,LinkedList,ArrayDeque. - Tổng hợp câu hỏi phỏng vấn Hash Table: Hiểu hash collision, mở rộng capacity và tư tưởng bên dưới của
HashMap. - Giải thích chi tiết về red-black tree: Hiểu red-black tree liên quan khi
TreeMap,TreeSetvàHashMaptreeify linked list. - Giải thích chi tiết về heap: Hiểu data structure bên dưới của
PriorityQueuevà dạng bài Top K.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.