
Phân tích source code của HashMap

Cảm ơn changfubai đã đóng góp cải tiến cho bài viết này!
Giới thiệu về HashMap
HashMap chủ yếu dùng để lưu trữ cặp key-value. Nó triển khai Map interface dựa trên hash table, là một trong các Java Collections thường dùng và không thread-safe.
HashMap có thể lưu key và value là null, nhưng null chỉ có thể làm key một lần, còn làm value thì có thể nhiều lần.
Trước JDK1.8, HashMap gồm array + linked list. Array là thành phần chính của HashMap, còn linked list chủ yếu tồn tại để giải quyết hash collision (giải quyết collision bằng "separate chaining"). Từ JDK1.8, HashMap có thay đổi lớn trong cách giải quyết hash collision. Khi độ dài linked list lớn hơn hoặc bằng ngưỡng (mặc định là 8) (trước khi chuyển linked list thành red-black tree, nó sẽ kiểm tra độ dài array hiện tại; nếu nhỏ hơn 64 thì sẽ ưu tiên resize array thay vì chuyển thành red-black tree), linked list được chuyển thành red-black tree để giảm thời gian tìm kiếm.
Kích thước khởi tạo mặc định của HashMap là 16. Sau đó, mỗi lần mở rộng, capacity tăng gấp đôi. Ngoài ra, HashMap luôn sử dụng lũy thừa của 2 làm kích thước hash table.
Phân tích cấu trúc dữ liệu bên trong
Trước JDK1.8
Trước JDK1.8, cấu trúc bên trong của HashMap kết hợp array và linked list, còn gọi là separate chaining.
HashMap lấy hashCode của key, xử lý qua hàm perturbation để nhận được hash value, sau đó dùng (n - 1) & hash để xác định vị trí lưu phần tử hiện tại (n ở đây là độ dài array). Nếu vị trí hiện tại đã có phần tử, nó sẽ kiểm tra hash value và key của phần tử đó có giống phần tử cần lưu hay không. Nếu giống thì ghi đè trực tiếp, nếu khác thì giải quyết collision bằng separate chaining.
Hàm perturbation chính là phương thức hash của HashMap. Sử dụng phương thức hash, tức hàm perturbation, nhằm hạn chế ảnh hưởng của một số hashCode() được triển khai kém; nói cách khác, dùng hàm perturbation có thể giảm collision.
Source code phương thức hash của HashMap trong JDK 1.8:
Phương thức hash của JDK 1.8 được đơn giản hóa hơn so với phương thức hash của JDK 1.7, nhưng nguyên lý không thay đổi.
    static final int hash(Object key) {
      int h;
      // key.hashCode(): trả về giá trị hash, tức hashcode
      // ^: phép XOR theo bit
      // >>>: dịch phải không dấu, bỏ qua bit dấu, các vị trí trống đều được điền bằng 0
      return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
  }
Hãy so sánh với source code phương thức hash của HashMap trong JDK1.7.
static int hash(int h) {
    // This function ensures that hashCodes that differ only by
    // constant multiples at each bit position have a bounded
    // number of collisions (approximately 8 at default load factor).

    h ^= (h >>> 20) ^ (h >>> 12);
    return h ^ (h >>> 7) ^ (h >>> 4);
}
So với phương thức hash của JDK1.8, hiệu năng phương thức hash của JDK 1.7 kém hơn một chút, vì nó thực hiện phép perturbation 4 lần.
Separate chaining là cách kết hợp linked list và array. Tức là tạo một array các linked list, mỗi ô trong array là một linked list. Khi gặp hash collision, chỉ cần thêm phần tử gây collision vào linked list.
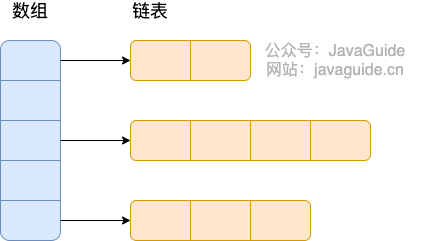
Từ JDK1.8
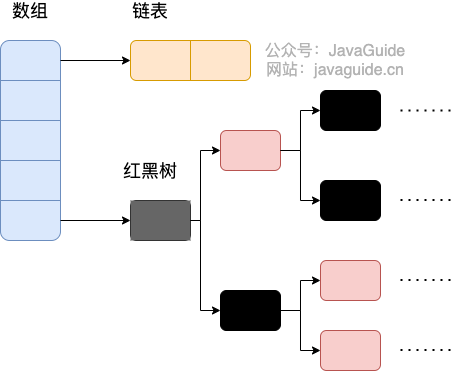
So với các phiên bản trước, từ JDK1.8 HashMap có thay đổi lớn trong cách giải quyết hash collision.
Khi độ dài linked list lớn hơn ngưỡng (mặc định là 8), trước hết phương thức treeifyBin() sẽ được gọi. Phương thức này quyết định có chuyển thành red-black tree hay không dựa trên array của HashMap. Chỉ khi độ dài array lớn hơn hoặc bằng 64 thì thao tác chuyển thành red-black tree mới được thực hiện để giảm thời gian tìm kiếm. Nếu không, chỉ thực hiện phương thức resize() để mở rộng array. Source code liên quan không được đưa vào đây, trọng tâm là phương thức treeifyBin()!
Các thuộc tính của class:
public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable {
    // serial number
    private static final long serialVersionUID = 362498820763181265L;
    // initial capacity mặc định là 16
    static final int DEFAULT_INITIAL_CAPACITY = 1 << 4;
    // capacity tối đa
    static final int MAXIMUM_CAPACITY = 1 << 30;
    // load factor mặc định
    static final float DEFAULT_LOAD_FACTOR = 0.75f;
    // Khi số node trên bucket lớn hơn hoặc bằng giá trị này thì chuyển thành red-black tree
    static final int TREEIFY_THRESHOLD = 8;
    // Khi số node trên bucket nhỏ hơn hoặc bằng giá trị này thì tree chuyển thành linked list
    static final int UNTREEIFY_THRESHOLD = 6;
    // capacity tối thiểu của table tương ứng với việc chuyển cấu trúc trong bucket thành red-black tree
    static final int MIN_TREEIFY_CAPACITY = 64;
    // array lưu trữ phần tử, luôn là lũy thừa của 2
    transient Node<k,v>[] table;
    // collection view chứa tất cả key-value trong mapping
    transient Set<map.entry<k,v>> entrySet;
    // số lượng phần tử, chú ý giá trị này không bằng độ dài array
    transient int size;
    // counter cho mỗi lần resize và thay đổi cấu trúc map
    transient int modCount;
    // threshold (capacity * load factor); khi kích thước thực tế vượt threshold thì sẽ resize
    int threshold;
    // load factor
    final float loadFactor;
}
loadFactor
loadFactor là tham số kiểm soát độ dày dữ liệu trong array. loadFactor càng gần 1 thì dữ liệu (entry) lưu trong array càng nhiều, càng dày, làm độ dài linked list tăng. loadFactor càng nhỏ, tức càng gần 0, thì dữ liệu (entry) lưu trong array càng ít và càng thưa.
loadFactor quá lớn làm hiệu quả tìm kiếm phần tử thấp; quá nhỏ làm hiệu suất sử dụng array thấp và dữ liệu lưu trữ bị phân tán. Giá trị mặc định 0.75f của loadFactor là một giá trị tới hạn khá tốt do official đưa ra.
Với capacity mặc định là 16 và load factor là 0.75, Map liên tục thêm dữ liệu trong quá trình sử dụng. Khi số lượng vượt quá 16 * 0.75 = 12, capacity hiện tại là 16 cần được mở rộng. Quá trình mở rộng cần tạo array mới và di chuyển node, nên tiêu tốn rất nhiều performance.
threshold
threshold = capacity * loadFactor. Khi Size > threshold thì cần cân nhắc mở rộng array; nói cách khác, đây là một tiêu chuẩn để xác định array có cần mở rộng hay không.
Source code class Node:
// kế thừa từ Map.Entry<K,V>
static class Node<K,V> implements Map.Entry<K,V> {
       final int hash;// hash value, dùng để so sánh hash của phần tử với các phần tử khác khi lưu vào HashMap
       final K key;// key
       V value;// value
       // trỏ tới node tiếp theo
       Node<K,V> next;
       Node(int hash, K key, V value, Node<K,V> next) {
            this.hash = hash;
            this.key = key;
            this.value = value;
            this.next = next;
        }
        public final K getKey()        { return key; }
        public final V getValue()      { return value; }
        public final String toString() { return key + "=" + value; }
        // override phương thức hashCode()
        public final int hashCode() {
            return Objects.hashCode(key) ^ Objects.hashCode(value);
        }

        public final V setValue(V newValue) {
            V oldValue = value;
            value = newValue;
            return oldValue;
        }
        // override phương thức equals()
        public final boolean equals(Object o) {
            if (o == this)
                return true;
            if (o instanceof Map.Entry) {
                Map.Entry<?,?> e = (Map.Entry<?,?>)o;
                if (Objects.equals(key, e.getKey()) &&
                    Objects.equals(value, e.getValue()))
                    return true;
            }
            return false;
        }
}
Source code class tree node:
static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> {
        TreeNode<K,V> parent;  // parent
        TreeNode<K,V> left;    // left
        TreeNode<K,V> right;   // right
        TreeNode<K,V> prev;    // needed to unlink next upon deletion
        boolean red;           // xác định màu
        TreeNode(int hash, K key, V val, Node<K,V> next) {
            super(hash, key, val, next);
        }
        // trả về root node
        final TreeNode<K,V> root() {
            for (TreeNode<K,V> r = this, p;;) {
                if ((p = r.parent) == null)
                    return r;
                r = p;
       }
Phân tích source code HashMap
Constructor
HashMap có bốn constructor, lần lượt như sau:
    // constructor mặc định.
    public HashMap() {
        this.loadFactor = DEFAULT_LOAD_FACTOR; // all   other fields defaulted
     }

     // constructor chứa một "Map" khác
     public HashMap(Map<? extends K, ? extends V> m) {
         this.loadFactor = DEFAULT_LOAD_FACTOR;
         putMapEntries(m, false);// phương thức này sẽ được phân tích bên dưới
     }

     // constructor chỉ định “capacity”
     public HashMap(int initialCapacity) {
         this(initialCapacity, DEFAULT_LOAD_FACTOR);
     }

     // constructor chỉ định “capacity” và “load factor”
     public HashMap(int initialCapacity, float loadFactor) {
         if (initialCapacity < 0)
             throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity);
         if (initialCapacity > MAXIMUM_CAPACITY)
             initialCapacity = MAXIMUM_CAPACITY;
         if (loadFactor <= 0 || Float.isNaN(loadFactor))
             throw new IllegalArgumentException("Illegal load factor: " + loadFactor);
         this.loadFactor = loadFactor;
         // initial capacity tạm thời được lưu vào threshold; sau đó resize sẽ gán nó cho newCap để khởi tạo table
         this.threshold = tableSizeFor(initialCapacity);
     }
Cần đặc biệt chú ý:
initialCapacitytruyền vào không phải là capacity cuối cùng của array.HashMapgọitableSizeFor()để làm tròn lên thành lũy thừa 2 nhỏ nhất lớn hơn hoặc bằng giá trị đó, rồi tạm thời lưu vào fieldthreshold.tablethực tế chỉ được khởi tạo với kích thước này trong lần resize đầu tiên.Ví dụ:
initialCapacity = 9→threshold = 16→ độ dàitablecuối cùng là 16.
Phương thức putMapEntries:
final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) {
    int s = m.size();
    if (s > 0) {
        // kiểm tra table đã được khởi tạo hay chưa
        if (table == null) { // pre-size
            /*
             * Chưa khởi tạo, s là số phần tử thực tế của m, ft=s/loadFactor => s=ft*loadFactor,
             * có giống threshold=capacity*load factor đã đề cập ở trên không? Đúng vậy, ft là capacity tối thiểu
             * cần thiết để thêm s phần tử
             */
            float ft = ((float)s / loadFactor) + 1.0F;
            int t = ((ft < (float)MAXIMUM_CAPACITY) ?
                    (int)ft : MAXIMUM_CAPACITY);
            /*
             * Theo constructor, table chưa được khởi tạo, nên threshold thực tế đang lưu initial capacity.
             * Nếu capacity tối thiểu cần để thêm s phần tử lớn hơn initial capacity,
             * làm tròn capacity tối thiểu lên lũy thừa 2 gần nhất để khởi tạo.
             * Chú ý đây không phải khởi tạo threshold.
             */
            if (t > threshold)
                threshold = tableSizeFor(t);
        }
        // đã khởi tạo, và số phần tử của m lớn hơn threshold, thực hiện resize
        else if (s > threshold)
            resize();
        // thêm tất cả phần tử trong m vào HashMap; nếu table chưa khởi tạo,
        // putVal sẽ gọi resize để khởi tạo hoặc mở rộng
        for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) {
            K key = e.getKey();
            V value = e.getValue();
            putVal(hash(key), key, value, false, evict);
        }
    }
}
Phương thức put
HashMap chỉ cung cấp put để thêm phần tử. Phương thức putVal chỉ được gọi bởi put và không cung cấp cho người dùng sử dụng.
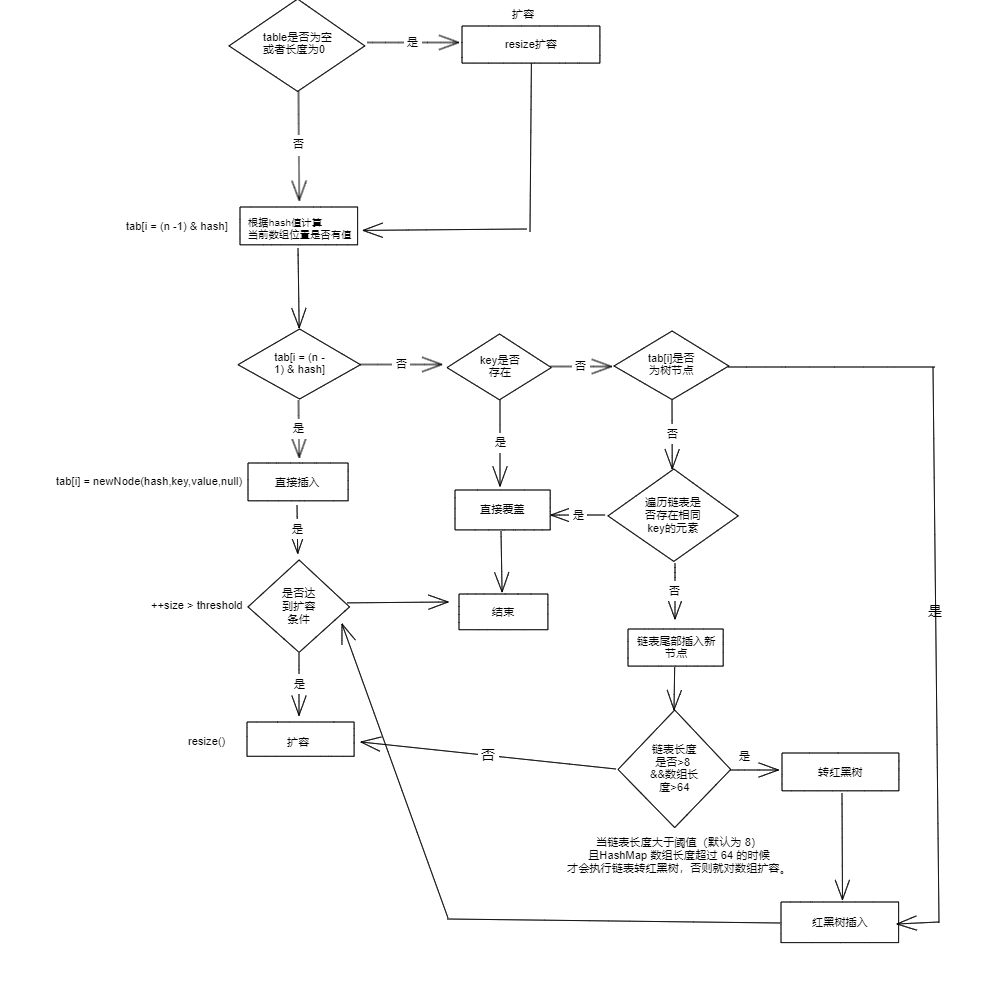
Phân tích việc thêm phần tử qua phương thức putVal:
- Nếu vị trí array được xác định không có phần tử thì chèn trực tiếp.
- Nếu vị trí array được xác định đã có phần tử thì so sánh với key cần chèn. Nếu key giống nhau thì ghi đè trực tiếp; nếu key khác nhau thì kiểm tra p có phải tree node hay không. Nếu phải thì gọi
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value)để thêm phần tử vào tree. Nếu không phải thì duyệt linked list để chèn (chèn vào cuối linked list).
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
    Node<K,V>[] tab; Node<K,V> p; int n, i;
    // table chưa khởi tạo hoặc độ dài bằng 0 thì resize
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;
    // (n - 1) & hash xác định bucket lưu phần tử; nếu bucket rỗng thì tạo node mới và đặt vào bucket
    // (lúc này node được đặt trong array)
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    // bucket đã có phần tử (xử lý hash collision)
    else {
        Node<K,V> e; K k;
        // nhanh chóng kiểm tra key của node đầu tiên tại table[i] có giống key chèn vào không;
        // nếu giống thì dùng value mới để thay thế value cũ của e
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
                e = p;
        // kiểm tra phần tử chèn vào có phải tree node không
        else if (p instanceof TreeNode)
            // đặt vào tree
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        // không phải red-black tree node thì là linked list node
        else {
            // chèn node vào cuối linked list
            for (int binCount = 0; ; ++binCount) {
                // đến cuối linked list
                if ((e = p.next) == null) {
                    // chèn node mới vào cuối
                    p.next = newNode(hash, key, value, null);
                    // số node đạt ngưỡng (mặc định là 8), thực hiện phương thức treeifyBin
                    // phương thức này quyết định có chuyển thành red-black tree dựa trên array của HashMap hay không.
                    // Chỉ khi độ dài array lớn hơn hoặc bằng 64 mới chuyển thành red-black tree để giảm thời gian tìm kiếm.
                    // Nếu không thì chỉ resize array.
                    if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
                        treeifyBin(tab, hash);
                    // thoát vòng lặp
                    break;
                }
                // kiểm tra key của node trong linked list có bằng key của phần tử chèn vào không
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    // bằng nhau, thoát vòng lặp
                    break;
                // dùng để duyệt linked list trong bucket; kết hợp với e = p.next phía trên để duyệt linked list
                p = e;
            }
        }
        // tìm thấy node trong bucket có key và hash trùng với phần tử chèn vào
        if (e != null) {
            // ghi lại value của e
            V oldValue = e.value;
            // onlyIfAbsent là false hoặc value cũ là null
            if (!onlyIfAbsent || oldValue == null)
                // thay value cũ bằng value mới
                e.value = value;
            // callback sau khi truy cập
            afterNodeAccess(e);
            // trả về value cũ
            return oldValue;
        }
    }
    // thay đổi cấu trúc
    ++modCount;
    // kích thước thực tế lớn hơn threshold thì resize
    if (++size > threshold)
        resize();
    // callback sau khi chèn
    afterNodeInsertion(evict);
    return null;
}
Hãy đối chiếu thêm code phương thức put của JDK1.7.
Phân tích phương thức put:
- ① Nếu vị trí array được xác định không có phần tử thì chèn trực tiếp.
- ② Nếu vị trí array được xác định đã có phần tử, duyệt linked list có phần tử này làm node đầu, lần lượt so sánh với key chèn vào. Nếu key giống nhau thì ghi đè trực tiếp, nếu khác thì chèn phần tử bằng phương pháp chèn đầu.
public V put(K key, V value)
    if (table == EMPTY_TABLE) {
    inflateTable(threshold);
}
    if (key == null)
        return putForNullKey(value);
    int hash = hash(key);
    int i = indexFor(hash, table.length);
    for (Entry<K,V> e = table[i]; e != null; e = e.next) { // duyệt trước
        Object k;
        if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
            V oldValue = e.value;
            e.value = value;
            e.recordAccess(this);
            return oldValue;
        }
    }

    modCount++;
    addEntry(hash, key, value, i);  // sau đó chèn
    return null;
}
Phương thức get
public V get(Object key) {
    Node<K,V> e;
    return (e = getNode(hash(key), key)) == null ? null : e.value;
}

final Node<K,V> getNode(int hash, Object key) {
    Node<K,V>[] tab; Node<K,V> first, e; int n; K k;
    if ((tab = table) != null && (n = tab.length) > 0 &&
        (first = tab[(n - 1) & hash]) != null) {
        // node đầu tiên trong array khớp
        if (first.hash == hash && // always check first node
            ((k = first.key) == key || (key != null && key.equals(k))))
            return first;
        // bucket có nhiều hơn một node
        if ((e = first.next) != null) {
            // get trong tree
            if (first instanceof TreeNode)
                return ((TreeNode<K,V>)first).getTreeNode(hash, key);
            // get trong linked list
            do {
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    return e;
            } while ((e = e.next) != null);
        }
    }
    return null;
}
Phương thức resize
Khi resize, HashMap sẽ duyệt các phần tử trong hash table và sử dụng hash value có sẵn của node cùng old capacity để xác định vị trí của node trong array mới, đây là thao tác rất tốn thời gian. Khi viết chương trình, nên cố gắng tránh resize. Về bản chất, phương thức resize kết hợp việc khởi tạo table và mở rộng table; thao tác bên dưới đều là gán một array mới cho table.
final Node<K,V>[] resize() {
    Node<K,V>[] oldTab = table;
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    int oldThr = threshold;
    int newCap, newThr = 0;
    if (oldCap > 0) {
        // vượt quá giá trị tối đa thì không mở rộng nữa, đành để collision tự xảy ra
        if (oldCap >= MAXIMUM_CAPACITY) {
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }
        // chưa vượt giá trị tối đa thì mở rộng thành gấp đôi
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY)
            newThr = oldThr << 1; // double threshold
    }
    else if (oldThr > 0) // initial capacity was placed in threshold
        // khi tạo object, initial capacity được đặt trong threshold; lúc này chỉ cần dùng nó làm capacity mới của array
        newCap = oldThr;
    else {
        // signifies using defaults: object được tạo bằng constructor không tham số sẽ tính capacity và threshold ở đây
        newCap = DEFAULT_INITIAL_CAPACITY;
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }
    if (newThr == 0) {
        // chỉ định initial capacity hoặc load factor khi tạo object thì khởi tạo threshold ở đây,
        // hoặc tính giới hạn resize mới khi old capacity trước khi resize nhỏ hơn 16
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE);
    }
    threshold = newThr;
    @SuppressWarnings({"rawtypes","unchecked"})
        Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
    table = newTab;
    if (oldTab != null) {
        // di chuyển từng bucket vào các bucket mới
        for (int j = 0; j < oldCap; ++j) {
            Node<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;
                if (e.next == null)
                    // chỉ có một node, trực tiếp tính vị trí mới của phần tử
                    newTab[e.hash & (newCap - 1)] = e;
                else if (e instanceof TreeNode)
                    // tách red-black tree thành 2 subtree; nếu số node của subtree nhỏ hơn hoặc bằng
                    // UNTREEIFY_THRESHOLD (mặc định là 6), chuyển subtree thành linked list.
                    // Nếu số node của subtree lớn hơn UNTREEIFY_THRESHOLD thì giữ nguyên cấu trúc tree.
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                else {
                    Node<K,V> loHead = null, loTail = null;
                    Node<K,V> hiHead = null, hiTail = null;
                    Node<K,V> next;
                    do {
                        next = e.next;
                        // index cũ
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                loTail.next = e;
                            loTail = e;
                        }
                        // index cũ + oldCap
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);
                    // đặt index cũ vào bucket
                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    // đặt index cũ + oldCap vào bucket
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
Kiểm thử các phương thức thường dùng của HashMap
package map;

import java.util.Collection;
import java.util.HashMap;
import java.util.Set;

public class HashMapDemo {

    public static void main(String[] args) {
        HashMap<String, String> map = new HashMap<String, String>();
        // key không thể trùng, value có thể trùng
        map.put("san", "Trương Tam");
        map.put("si", "Lý Tứ");
        map.put("wu", "Vương Ngũ");
        map.put("wang", "Lão Vương");
        map.put("wang", "Lão Vương 2");// Lão Vương bị ghi đè
        map.put("lao", "Lão Vương");
        System.out.println("-------in trực tiếp hashmap:-------");
        System.out.println(map);
        /**
         * duyệt HashMap
         */
        // 1. lấy tất cả key trong Map
        System.out.println("-------foreach lấy tất cả key trong Map:------");
        Set<String> keys = map.keySet();
        for (String key : keys) {
            System.out.print(key+"  ");
        }
        System.out.println();//xuống dòng
        // 2. lấy tất cả value trong Map
        System.out.println("-------foreach lấy tất cả value trong Map:------");
        Collection<String> values = map.values();
        for (String value : values) {
            System.out.print(value+"  ");
        }
        System.out.println();//xuống dòng
        // 3. lấy value tương ứng với key cùng lúc lấy key
        System.out.println("-------lấy value của key cùng lúc lấy value tương ứng với key:-------");
        Set<String> keys2 = map.keySet();
        for (String key : keys2) {
            System.out.print(key + ":" + map.get(key)+"   ");

        }
        /**
         * Nếu cần duyệt cả key và value thì nên dùng cách này, vì nếu lấy keySet trước rồi gọi map.get(key),
         * bên trong map sẽ thực hiện hai lần duyệt.
         * Một lần khi lấy keySet, một lần khi duyệt tất cả key.
         */
         // Khi gọi phương thức put(key,value), trước hết key và value được đóng gói vào
         // object của static inner class Entry, sau đó object Entry được thêm vào array, nên để lấy
         // tất cả key-value trong map, chỉ cần lấy tất cả object Entry trong array, rồi
         // gọi phương thức getKey() và getValue() của object Entry để lấy key-value
         Set<java.util.Map.Entry<String, String>> entrys = map.entrySet();
         for (java.util.Map.Entry<String, String> entry : entrys) {
             System.out.println(entry.getKey() + "--" + entry.getValue());
         }

         /**
          * Các phương thức thường dùng khác của HashMap
          */
         System.out.println("sau map.size():"+map.size());
         System.out.println("sau map.isEmpty():"+map.isEmpty());
         System.out.println(map.remove("san"));
         System.out.println("sau map.remove():"+map);
         System.out.println("sau map.get(si):"+map.get("si"));
         System.out.println("sau map.containsKey(si):"+map.containsKey("si"));
         System.out.println("sau containsValue(Lý Tứ):"+map.containsValue("Lý Tứ"));
         System.out.println(map.replace("si", "Lý Tứ 2"));
         System.out.println("sau map.replace(si, Lý Tứ 2):"+map);
     }

 }
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.