
Tổng hợp câu hỏi phỏng vấn Java Collections (phần dưới)

Map (quan trọng)
⭐️ Điểm khác biệt giữa HashMap và Hashtable
- Có thread-safe hay không:
HashMapkhông thread-safe, cònHashtablethread-safe, vì các method bên trongHashtablevề cơ bản đều được thêmsynchronized. (Nếu bạn muốn bảo đảm thread-safe thì hãy dùngConcurrentHashMap!); - Hiệu suất: Vì vấn đề thread-safe,
HashMapcó hiệu suất cao hơnHashtablemột chút. Ngoài ra,Hashtablevề cơ bản đã bị loại bỏ, không nên dùng nó trong code; - Hỗ trợ Null key và Null value:
HashMapcó thể lưu trữ key và value là null, nhưng null làm key chỉ có thể có một, còn null làm value có thể có nhiều;Hashtablekhông cho phép key và value là null, nếu không sẽ némNullPointerException. - Dung lượng ban đầu và dung lượng mỗi lần mở rộng khác nhau: ① Nếu khi khởi tạo không chỉ định giá trị ban đầu,
Hashtablemặc định có kích thước ban đầu là 11, sau đó mỗi lần mở rộng, dung lượng trở thành2n+1.HashMapmặc định có kích thước ban đầu là 16. Sau đó mỗi lần mở rộng, dung lượng tăng gấp 2 lần. ② Nếu khi khởi tạo chỉ định giá trị ban đầu,Hashtablesẽ trực tiếp sử dụng kích thước bạn cung cấp, cònHashMapsẽ mở rộng nó thành lũy thừa của 2 (tableSizeFor()trongHashMapbảo đảm điều này, source code được cung cấp bên dưới). Nói cách khác,HashMapluôn dùng lũy thừa của 2 làm kích thước hash table, phần sau sẽ giải thích vì sao là lũy thừa của 2. - Cấu trúc dữ liệu bên trong: Sau JDK1.8,
HashMapcó thay đổi khá lớn khi xử lý hash collision. Khi độ dài linked list lớn hơn ngưỡng (mặc định là 8), linked list sẽ được chuyển thành red-black tree (trước khi chuyển linked list thành red-black tree sẽ kiểm tra; nếu độ dài array hiện tại nhỏ hơn 64 thì sẽ ưu tiên mở rộng array thay vì chuyển thành red-black tree), nhằm giảm thời gian tìm kiếm (phần sau sẽ phân tích quy trình này cùng source code).Hashtablekhông có cơ chế này. - Cách triển khai hash function:
HashMaptrộn và làm nhiễu các bit cao và bit thấp của hash value để giảm collision, cònHashtabletrực tiếp sử dụng giá trịhashCode()của key.
Constructor có initial capacity trong HashMap:
    public HashMap(int initialCapacity, float loadFactor) {
        if (initialCapacity < 0)
            throw new IllegalArgumentException("Illegal initial capacity: " +
                                               initialCapacity);
        if (initialCapacity > MAXIMUM_CAPACITY)
            initialCapacity = MAXIMUM_CAPACITY;
        if (loadFactor <= 0 || Float.isNaN(loadFactor))
            throw new IllegalArgumentException("Illegal load factor: " +
                                               loadFactor);
        this.loadFactor = loadFactor;
        this.threshold = tableSizeFor(initialCapacity);
    }
     public HashMap(int initialCapacity) {
        this(initialCapacity, DEFAULT_LOAD_FACTOR);
    }
Method dưới đây bảo đảm HashMap luôn dùng lũy thừa của 2 làm kích thước hash table.
/**
 * Returns a power of two size for the given target capacity.
 */
static final int tableSizeFor(int cap) {
    int n = cap - 1;
    n |= n >>> 1;
    n |= n >>> 2;
    n |= n >>> 4;
    n |= n >>> 8;
    n |= n >>> 16;
    return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}
Điểm khác biệt giữa HashMap và HashSet
Nếu bạn đã xem source code của HashSet thì sẽ biết: HashSet bên trong được triển khai dựa trên HashMap. (Source code của HashSet rất ngắn, vì ngoài clone(), writeObject(), readObject() là những method mà HashSet bắt buộc phải tự triển khai, các method khác đều trực tiếp gọi method trong HashMap.)
HashMap | HashSet |
|---|---|
Triển khai interface Map | Triển khai interface Set |
| Lưu trữ key-value | Chỉ lưu trữ object |
Gọi put() để thêm phần tử vào map | Gọi method add() để thêm phần tử vào Set |
HashMap dùng key để tính hashcode | HashSet dùng object thành viên để tính giá trị hashcode; với hai object, hashcode có thể giống nhau, nên dùng method equals() để kiểm tra tính bằng nhau của object |
⭐️ Điểm khác biệt giữa HashMap và TreeMap
TreeMap và HashMap đều kế thừa AbstractMap, nhưng cần lưu ý TreeMap còn triển khai interface NavigableMap và interface SortedMap.
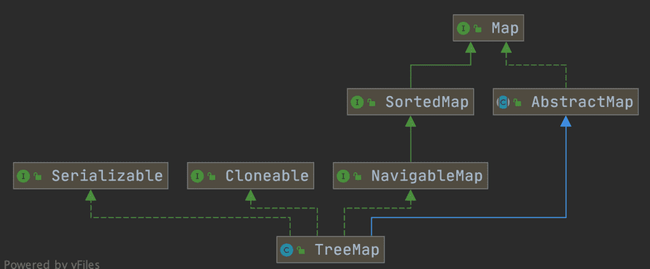
Việc triển khai interface NavigableMap giúp TreeMap có khả năng tìm kiếm các phần tử trong collection.
Interface NavigableMap cung cấp nhiều method để khám phá và thao tác với key-value:
- Tìm kiếm định hướng: Các method
ceilingEntry(),floorEntry(),higherEntry()vàlowerEntry()có thể dùng để định vị key-value gần nhất lớn hơn hoặc bằng, nhỏ hơn hoặc bằng, lớn hơn nghiêm ngặt, nhỏ hơn nghiêm ngặt so với key đã cho. - Thao tác subset: Các method
subMap(),headMap()vàtailMap()có thể tạo view subset của collection gốc một cách hiệu quả mà không cần sao chép toàn bộ collection. - View đảo ngược: Method
descendingMap()trả về một viewNavigableMaptheo thứ tự ngược, cho phép iterate toàn bộTreeMaptheo chiều ngược lại. - Thao tác biên: Các method
firstEntry(),lastEntry(),pollFirstEntry()vàpollLastEntry()giúp truy cập và loại bỏ phần tử một cách thuận tiện.
Các method này đều được triển khai dựa trên thuộc tính của cấu trúc dữ liệu red-black tree. Red-black tree duy trì trạng thái cân bằng, nhờ đó bảo đảm time complexity của thao tác tìm kiếm là O(log n), khiến TreeMap trở thành công cụ mạnh để xử lý bài toán tìm kiếm trong collection có thứ tự.
Việc triển khai interface SortedMap giúp TreeMap có khả năng sắp xếp các phần tử trong collection theo key. Mặc định là sắp xếp key theo thứ tự tăng dần, nhưng chúng ta cũng có thể chỉ định comparator. Code ví dụ như sau:
/**
 * @author shuang.kou
 * @createTime 2020-06-15 17:02:00
 */
public class Person {
    private Integer age;

    public Person(Integer age) {
        this.age = age;
    }

    public Integer getAge() {
        return age;
    }


    public static void main(String[] args) {
        TreeMap<Person, String> treeMap = new TreeMap<>(new Comparator<Person>() {
            @Override
            public int compare(Person person1, Person person2) {
                int num = person1.getAge() - person2.getAge();
                return Integer.compare(num, 0);
            }
        });
        treeMap.put(new Person(3), "person1");
        treeMap.put(new Person(18), "person2");
        treeMap.put(new Person(35), "person3");
        treeMap.put(new Person(16), "person4");
        treeMap.entrySet().stream().forEach(personStringEntry -> {
            System.out.println(personStringEntry.getValue());
        });
    }
}
Output:
person1
person4
person2
person3
Có thể thấy các phần tử trong TreeMap đã được sắp xếp tăng dần theo field age của Person.
Ở trên, chúng ta triển khai bằng cách truyền anonymous inner class. Bạn có thể thay code bằng cách triển khai qua Lambda expression:
TreeMap<Person, String> treeMap = new TreeMap<>((person1, person2) -> {
  int num = person1.getAge() - person2.getAge();
  return Integer.compare(num, 0);
});
Tóm lại, so với HashMap, TreeMap chủ yếu có thêm khả năng sắp xếp các phần tử trong collection theo key và khả năng tìm kiếm các phần tử trong collection.
HashSet kiểm tra trùng lặp như thế nào?
Nội dung dưới đây được trích từ cuốn sách nhập môn Java 《Head first java》 phiên bản thứ hai của tôi:
Khi bạn thêm object vào
HashSet,HashSettrước tiên tính giá trịhashcodecủa object để xác định vị trí thêm object, đồng thời so sánh với giá trịhashcodecủa các object khác đã được thêm. Nếu không cóhashcodenào khớp,HashSetsẽ cho rằng object chưa xuất hiện trùng lặp. Tuy nhiên, nếu phát hiện object có cùng giá trịhashcode, nó sẽ gọi methodequals()để kiểm tra các object cóhashcodebằng nhau có thực sự giống nhau hay không. Nếu hai object giống nhau,HashSetsẽ không cho phép thao tác thêm thành công.
Trong JDK1.8, method add() của HashSet chỉ đơn giản gọi method put() của HashMap, đồng thời kiểm tra giá trị trả về để bảo đảm không có phần tử trùng lặp. Hãy xem trực tiếp source code trong HashSet:
// Returns: true if this set did not already contain the specified element
// Giá trị trả về: true khi set chưa chứa phần tử được add
public boolean add(E e) {
        return map.put(e, PRESENT)==null;
}
Trong method putVal() của HashMap cũng có giải thích như sau:
// Returns : previous value, or null if none
// Giá trị trả về: trả về null nếu vị trí chèn chưa có phần tử, nếu không trả về value trước đó
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
...
}
Nói cách khác, trong JDK1.8, nếu HashSet đã tồn tại phần tử giống nhau, HashMap bên dưới sẽ giữ lại key ban đầu, HashSet#add() trả về false; chỉ khi chưa tồn tại thì phần tử mới được thêm và trả về true.
⭐️ Triển khai bên trong của HashMap
Trước JDK1.8
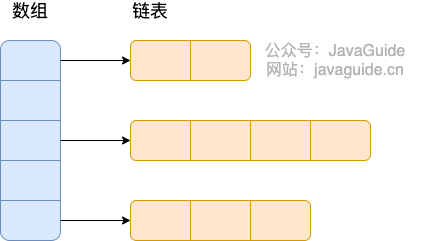
Trước JDK1.8, bên trong HashMap kết hợp array và linked list, còn gọi là separate chaining. HashMap lấy hashcode của key, xử lý qua hàm nhiễu để thu được hash value, sau đó dùng (n - 1) & hash để xác định vị trí lưu trữ phần tử hiện tại (n là độ dài của array). Nếu vị trí hiện tại đã có phần tử, nó sẽ kiểm tra hash value và key của phần tử đó có giống phần tử cần lưu hay không. Nếu giống thì ghi đè trực tiếp, nếu khác thì dùng separate chaining để xử lý collision.
Hàm nhiễu trong HashMap (method hash) dùng để tối ưu phân bố hash value. Bằng cách xử lý thêm hashCode() ban đầu, hàm nhiễu có thể giảm collision do cách triển khai hashCode() kém gây ra, từ đó cải thiện độ đồng đều của phân bố dữ liệu.
Source code method hash của HashMap JDK 1.8:
Method hash của JDK 1.8 được đơn giản hóa hơn so với method hash của JDK 1.7, nhưng nguyên lý không thay đổi.
    static final int hash(Object key) {
      int h;
      // key.hashCode(): trả về giá trị hash, tức hashcode
      // ^: phép XOR theo bit
      // >>>: dịch phải không dấu, bỏ qua bit dấu, các vị trí trống đều được điền bằng 0
      return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
  }
Hãy so sánh với source code method hash của HashMap JDK1.7.
static int hash(int h) {
    // This function ensures that hashCodes that differ only by
    // constant multiples at each bit position have a bounded
    // number of collisions (approximately 8 at default load factor).

    h ^= (h >>> 20) ^ (h >>> 12);
    return h ^ (h >>> 7) ^ (h >>> 4);
}
So với method hash của JDK1.8, method hash của JDK1.7 có hiệu suất kém hơn một chút, vì dù sao cũng đã làm nhiễu 4 lần.
Separate chaining là: kết hợp linked list với array. Nghĩa là tạo một array các linked list, mỗi ô trong array là một linked list. Khi xảy ra hash collision, chỉ cần thêm giá trị gây collision vào linked list.
Sau JDK1.8
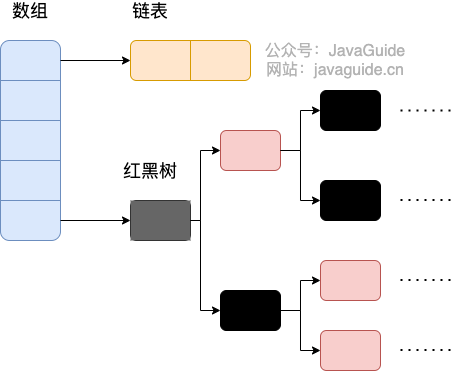
So với các phiên bản trước, sau JDK1.8 có thay đổi khá lớn khi xử lý hash collision. Khi độ dài linked list lớn hơn ngưỡng (mặc định là 8) (trước khi chuyển linked list thành red-black tree sẽ kiểm tra; nếu độ dài array hiện tại nhỏ hơn 64 thì sẽ ưu tiên mở rộng array thay vì chuyển thành red-black tree), linked list sẽ được chuyển thành red-black tree.
Mục đích của việc này là giảm thời gian tìm kiếm: hiệu suất tìm kiếm của linked list là O(n) (n là độ dài linked list), còn red-black tree là một binary search tree tự cân bằng, hiệu suất tìm kiếm là O(log n). Khi linked list ngắn, chênh lệch hiệu suất giữa O(n) và O(log n) không đáng kể. Nhưng khi linked list dài lên, hiệu suất tìm kiếm sẽ giảm rõ rệt.
Vì sao ưu tiên mở rộng thay vì chuyển trực tiếp thành red-black tree?
Mở rộng array có thể giảm xác suất xảy ra hash collision (tức phân tán lại các phần tử vào array mới, lớn hơn), trong đa số trường hợp sẽ hiệu quả hơn chuyển trực tiếp thành red-black tree.
Red-black tree cần duy trì tự cân bằng nên chi phí bảo trì khá cao. Hơn nữa, đưa red-black tree vào quá sớm có thể làm tăng độ phức tạp.
Vì sao chọn ngưỡng 8 và 64?
- Phân phối Poisson cho thấy xác suất độ dài linked list đạt 8 là cực thấp (nhỏ hơn một phần mười triệu). Trong đa số trường hợp, độ dài linked list sẽ không vượt quá 8. Đặt ngưỡng là 8 có thể bảo đảm cân bằng giữa hiệu suất và hiệu quả sử dụng không gian.
- Ngưỡng độ dài array là 64 cũng là giá trị kinh nghiệm đã được kiểm chứng qua thực tế. Trong array nhỏ, chi phí mở rộng thấp, ưu tiên mở rộng có thể tránh đưa red-black tree vào quá sớm. Khi kích thước array đạt 64, xác suất collision cao hơn, lúc này ưu thế hiệu suất của red-black tree bắt đầu thể hiện.
Bên trong
TreeMap,TreeSetvàHashMapsau JDK1.8 đều sử dụng red-black tree. Red-black tree được dùng để giải quyết khiếm khuyết của binary search tree, vì binary search tree trong một số trường hợp có thể suy biến thành cấu trúc tuyến tính.
Hãy kết hợp với source code để phân tích việc chuyển linked list của HashMap thành red-black tree.
1. Logic kiểm tra chuyển linked list thành red-black tree được thực hiện trong method putVal.
Khi độ dài linked list lớn hơn 8, logic treeifyBin (chuyển thành red-black tree) sẽ được thực hiện.
// Duyệt linked list
for (int binCount = 0; ; ++binCount) {
    // Duyệt đến node cuối cùng của linked list
    if ((e = p.next) == null) {
        p.next = newNode(hash, key, value, null);
        // Nếu số phần tử của linked list lớn hơn TREEIFY_THRESHOLD (8)
        if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
            // Chuyển thành red-black tree (không chuyển trực tiếp thành red-black tree)
            treeifyBin(tab, hash);
        break;
    }
    if (e.hash == hash &&
        ((k = e.key) == key || (key != null && key.equals(k))))
        break;
    p = e;
}
2. Kiểm tra có thực sự chuyển thành red-black tree hay không trong method treeifyBin.
final void treeifyBin(Node<K,V>[] tab, int hash) {
    int n, index; Node<K,V> e;
    // Kiểm tra độ dài array hiện tại có nhỏ hơn 64 hay không
    if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
        // Nếu độ dài array hiện tại nhỏ hơn 64 thì ưu tiên mở rộng array
        resize();
    else if ((e = tab[index = (n - 1) & hash]) != null) {
        // Nếu không thì mới chuyển linked list thành red-black tree

        TreeNode<K,V> hd = null, tl = null;
        do {
            TreeNode<K,V> p = replacementTreeNode(e, null);
            if (tl == null)
                hd = p;
            else {
                p.prev = tl;
                tl.next = p;
            }
            tl = p;
        } while ((e = e.next) != null);
        if ((tab[index] = hd) != null)
            hd.treeify(tab);
    }
}
Trước khi chuyển linked list thành red-black tree sẽ kiểm tra; nếu độ dài array hiện tại nhỏ hơn 64 thì ưu tiên mở rộng array thay vì chuyển thành red-black tree.
⭐️ Vì sao độ dài HashMap là lũy thừa của 2?
Để việc lưu trữ và truy xuất của HashMap hiệu quả, đồng thời giảm collision, chúng ta cần bảo đảm dữ liệu được phân bố đồng đều nhất có thể. Hash value trong Java thường dùng int biểu diễn, phạm vi từ -2147483648 đến 2147483647, tổng cộng khoảng 4 tỷ không gian ánh xạ. Chỉ cần hash function ánh xạ tương đối đồng đều và phân tán thì ứng dụng thông thường rất khó xảy ra collision. Tuy nhiên, một array có độ dài 4 tỷ phần tử sẽ không thể chứa trong memory. Vì vậy không thể dùng trực tiếp hash value này. Trước khi dùng, cần thực hiện phép lấy modulo với độ dài array để lấy phần dư, từ đó có được vị trí cần lưu trữ, tức index tương ứng trong array.
Nên thiết kế algorithm này như thế nào?
Trước tiên, chúng ta có thể nghĩ đến việc dùng phép % lấy phần dư. Với hash không âm, khi length là lũy thừa của 2, hash % length tương đương với hash & (length - 1). HashMap dùng cách thứ hai để tính index của array.
Ngoài việc phép toán bit nhanh hơn phép lấy phần dư như đã nói ở trên, tôi cho rằng lý do quan trọng hơn là: độ dài là lũy thừa của 2 giúp HashMap phân bố đồng đều hơn khi mở rộng. Ví dụ:
- length = 8, khi đó length - 1 = 7 có biểu diễn nhị phân là
0111 - length = 16, khi đó length - 1 = 15 có biểu diễn nhị phân là
1111
Khi đó, lúc tính vị trí mới của các phần tử vốn có trong HashMap bằng hash&(length-1), vị trí phụ thuộc vào bit nhị phân thứ tư của hash (tính từ phải sang), sẽ có hai trường hợp:
- Bit nhị phân thứ tư là 0, vị trí array không đổi, tức phần tử hiện tại có cùng vị trí trong array mới và array cũ.
- Bit nhị phân thứ tư là 1, vị trí array nằm ở phần được mở rộng của array mới.
Ví dụ:
Giả sử hash value của một phần tử là 10101100

Tính vị trí phần tử trong array cũ:
hash        = 10101100
length - 1  = 00000111
& -----------------
index       = 00000100  (4)

Tính vị trí phần tử trong array mới:
hash        = 10101100
length - 1  = 00001111
& -----------------
index       = 00001100  (12)

Xét bit thứ tư (tính từ phải sang):
1. Bit cao bằng 0: vị trí không đổi.
2. Bit cao bằng 1: di chuyển đến vị trí mới (index cũ + capacity cũ).
⚠️Lưu ý: Trường hợp trên xét bit nhị phân thứ tư; nói chính xác hơn là xét bit cao (tính từ phải sang). Ví dụ, khi length = 32 thì length - 1 = 31, biểu diễn nhị phân là 11111, lúc này xét bit nhị phân thứ năm.
Nói cách khác, sau khi mở rộng, trong điều kiện hash value của các phần tử trong array cũ tương đối đồng đều (hash value có đồng đều hay không phụ thuộc vào method hashcode() của object và hàm nhiễu đã nói ở trước), các phần tử trong array mới cũng được phân bổ tương đối đồng đều. Trường hợp tốt nhất là một nửa nằm ở nửa trước của array mới, một nửa nằm ở nửa sau.
Điều này cũng khiến cơ chế mở rộng trở nên đơn giản và hiệu quả. Sau khi mở rộng, chỉ cần kiểm tra thay đổi ở bit cao của hash value để quyết định vị trí mới của phần tử: hoặc vị trí không đổi (bit cao bằng 0), hoặc di chuyển đến vị trí mới (bit cao bằng 1, index cũ + capacity cũ).
Cuối cùng, hãy tóm tắt ngắn gọn lý do độ dài HashMap là lũy thừa của 2:
- Hiệu suất phép toán bit cao hơn: phép toán bit (
&) hiệu quả hơn phép lấy phần dư (%). Vớihashkhông âm, khi độ dài là lũy thừa của 2,hash % lengthtương đương vớihash & (length - 1). - Có thể bảo đảm tốt hơn sự phân bố đồng đều của hash value: sau khi mở rộng, trong điều kiện hash value của các phần tử trong array cũ tương đối đồng đều, các phần tử trong array mới cũng được phân bổ tương đối đồng đều. Trường hợp tốt nhất là một nửa nằm ở nửa trước của array mới, một nửa nằm ở nửa sau.
- Cơ chế mở rộng trở nên đơn giản và hiệu quả: sau khi mở rộng, chỉ cần kiểm tra thay đổi ở bit cao của hash value để quyết định vị trí mới của phần tử: hoặc vị trí không đổi (bit cao bằng 0), hoặc di chuyển đến vị trí mới (bit cao bằng 1, index cũ + capacity cũ).
⭐️ Vấn đề infinite loop do thao tác HashMap đa thread
Trong phiên bản JDK1.7 và trước đó, thao tác mở rộng HashMap trong môi trường đa thread có thể xảy ra infinite loop. Nguyên nhân là khi một bucket có nhiều phần tử cần mở rộng, nhiều thread cùng thao tác trên linked list, head insertion có thể khiến node trong linked list trỏ sai vị trí, từ đó hình thành circular linked list, khiến thao tác tìm kiếm phần tử rơi vào infinite loop và không thể kết thúc.
Để giải quyết vấn đề này, phiên bản HashMap JDK1.8 dùng tail insertion thay vì head insertion để tránh đảo ngược linked list, khiến node được chèn luôn nằm ở cuối linked list và tránh hình thành cấu trúc vòng. Tuy nhiên, vẫn không nên dùng HashMap trong môi trường đa thread, vì dùng HashMap đa thread vẫn có rủi ro data overwrite. Trong môi trường concurrent, nên dùng ConcurrentHashMap.
Trong phỏng vấn thông thường, giới thiệu như vậy là đủ, không cần ghi nhớ mọi chi tiết; theo tôi cũng không cần ghi nhớ. Nếu muốn tìm hiểu chi tiết vấn đề infinite loop do mở rộng HashMap, bạn có thể xem bài viết này của chú Hao: Infinite loop của Java HashMap.
⭐️ Vì sao HashMap không thread-safe?
HashMap không thread-safe. Trong môi trường đa thread, thao tác ghi concurrent trên HashMap có thể gây ra hai vấn đề chính:
- Mất dữ liệu: thao tác
putconcurrent có thể khiến dữ liệu do một thread ghi bị thread khác ghi đè. - Infinite loop: trong các phiên bản JDK 7 và trước đó, khi mở rộng concurrent, head insertion có thể khiến linked list hình thành vòng, từ đó gây infinite loop khi thao tác
get, khiến CPU tăng vọt lên 100%.
Mất dữ liệu tồn tại ở cả JDK1.7 và JDK 1.8, ở đây lấy JDK 1.8 làm ví dụ.
Sau JDK 1.8, trong HashMap, nhiều key-value có thể được phân bổ vào cùng một bucket và được lưu dưới dạng linked list hoặc red-black tree. Thao tác put của nhiều thread trên HashMap sẽ khiến nó không thread-safe, cụ thể là có rủi ro data overwrite.
Ví dụ:
- Hai thread 1 và 2 đồng thời thực hiện thao tác put, đồng thời xảy ra hash collision (index chèn do hash function tính ra giống nhau).
- Các thread khác nhau có thể nhận được cơ hội thực thi CPU ở các time slice khác nhau. Sau khi thread 1 hoàn tất phán đoán hash collision, nó bị tạm dừng vì time slice hết. Thread 2 hoàn tất thao tác chèn trước.
- Sau đó thread 1 nhận được time slice. Vì trước đó đã phán đoán hash collision, nó sẽ chèn trực tiếp, khiến dữ liệu thread 2 chèn bị thread 1 ghi đè.
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
    // ...
    // Kiểm tra có xảy ra hash collision hay không
    // (n - 1) & hash xác định bucket lưu phần tử; nếu bucket rỗng, node mới được tạo và đặt vào bucket (lúc này node nằm trong array)
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    // Bucket đã tồn tại phần tử (xử lý hash collision)
    else {
    // ...
}
Một trường hợp khác là thao tác put đồng thời của hai thread khiến giá trị size không chính xác:
- Khi thread 1 thực hiện phán đoán
if(++size > threshold), giả sử nhận được giá trịsizelà 10, sau đó bị tạm dừng vì time slice hết. - Thread 2 cũng thực hiện phán đoán
if(++size > threshold), nhận được giá trịsizecũng là 10, chèn phần tử vào bucket đó và cập nhật giá trịsizethành 11. - Sau đó thread 1 nhận được time slice, cũng đặt phần tử vào bucket và cập nhật giá trị size thành 11.
- Thread 1 và 2 đều thực hiện một lần thao tác
put, nhưng giá trịsizechỉ tăng 1. Lúc này việc đếm xảy ra lost update, nhưng không thể chỉ dựa vào kết quảsizeđể phán đoán thực tế đã chèn bao nhiêu phần tử.
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
    // ...
    // Mở rộng khi kích thước thực tế lớn hơn ngưỡng
    if (++size > threshold)
        resize();
    // Callback sau khi chèn
    afterNodeInsertion(evict);
    return null;
}
Các cách iterate HashMap thường gặp?
7 cách iterate HashMap và phân tích hiệu suất!
🐛 Đính chính (tham khảo: issue#1411):
Bài viết này phân tích sai về hiệu suất của cách iterate bằng parallelStream, kết luận trước: khi có blocking, parallelStream có hiệu suất cao nhất; khi không blocking, parallelStream có hiệu suất thấp nhất.
Khi iterate không có blocking, hiệu suất của parallelStream là thấp nhất:
Benchmark               Mode  Cnt     Score      Error  Units
Test.entrySet           avgt    5   288.651 ±   10.536  ns/op
Test.keySet             avgt    5   584.594 ±   21.431  ns/op
Test.lambda             avgt    5   221.791 ±   10.198  ns/op
Test.parallelStream     avgt    5  6919.163 ± 1116.139  ns/op
Chỉ sau khi thêm code blocking Thread.sleep(10), hiệu suất của parallelStream mới cao nhất:
Benchmark               Mode  Cnt           Score          Error  Units
Test.entrySet           avgt    5  1554828440.000 ± 23657748.653  ns/op
Test.keySet             avgt    5  1550612500.000 ±  6474562.858  ns/op
Test.lambda             avgt    5  1551065180.000 ± 19164407.426  ns/op
Test.parallelStream     avgt    5   186345456.667 ±  3210435.590  ns/op
⭐️ Điểm khác biệt giữa ConcurrentHashMap và Hashtable
Điểm khác biệt chính giữa ConcurrentHashMap và Hashtable nằm ở cách triển khai thread-safe khác nhau.
- Cấu trúc dữ liệu bên trong: Bên trong
ConcurrentHashMapJDK1.7 dùng array phân đoạn + linked list; trong JDK1.8 dùng cấu trúc giốngHashMap, tức array + linked list/red-black tree. Cấu trúc dữ liệu bên trongHashtablevàHashMaptrước JDK1.8 tương tự nhau, đều dùng dạng array + linked list; array là thành phần chính của HashMap, còn linked list chủ yếu tồn tại để xử lý hash collision; - Cách triển khai thread-safe (quan trọng):
- Trong JDK1.7,
ConcurrentHashMapphân đoạn toàn bộ bucket array (Segment, segmented lock), mỗi lock chỉ khóa một phần dữ liệu trong container (xem hình minh họa bên dưới). Khi nhiều thread truy cập dữ liệu ở các đoạn khác nhau trong container thì sẽ không xảy ra lock contention, giúp tăng concurrency; - Đến JDK1.8,
ConcurrentHashMapđã loại bỏ khái niệmSegment, mà trực tiếp dùng cấu trúc dữ liệuNodearray + linked list + red-black tree để triển khai, kiểm soát concurrent bằngsynchronizedvà CAS. (Sau JDK1.6, locksynchronizedđã được tối ưu hóa rất nhiều.) Nhìn tổng thể, nó giống mộtHashMapđã được tối ưu và thread-safe. Mặc dù trong JDK1.8 vẫn có thể thấy cấu trúc dữ liệuSegment, các thuộc tính đã được đơn giản hóa, chỉ nhằm tương thích với phiên bản cũ; Hashtable(dùng chung một lock): Dùngsynchronizedđể bảo đảm thread-safe, hiệu suất rất thấp. Khi một thread truy cập synchronized method, các thread khác cũng truy cập synchronized method có thể rơi vào trạng thái blocking hoặc polling. Ví dụ khi một thread dùngputđể thêm phần tử, thread khác không thể dùngputđể thêm phần tử, cũng không thể dùngget; contention càng lớn thì hiệu suất càng thấp.
- Trong JDK1.7,
Tiếp theo, hãy xem hình so sánh cấu trúc dữ liệu bên trong của hai loại.
Hashtable:
https://www.cnblogs.com/chengxiao/p/6842045.html
ConcurrentHashMap của JDK1.7:
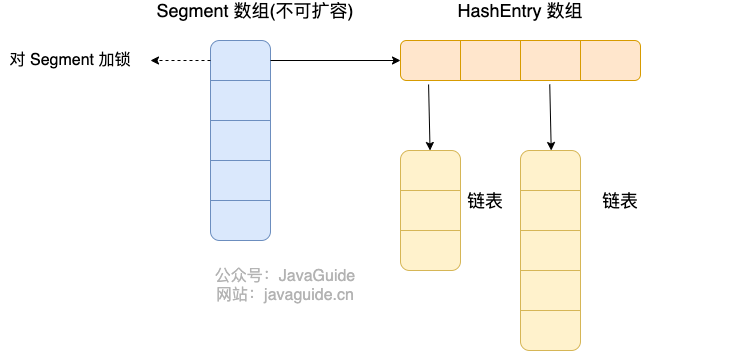
ConcurrentHashMap được cấu thành từ cấu trúc Segment array và cấu trúc HashEntry array.
Mỗi phần tử trong Segment array chứa một HashEntry array, mỗi HashEntry array có cấu trúc linked list.
ConcurrentHashMap của JDK1.8:
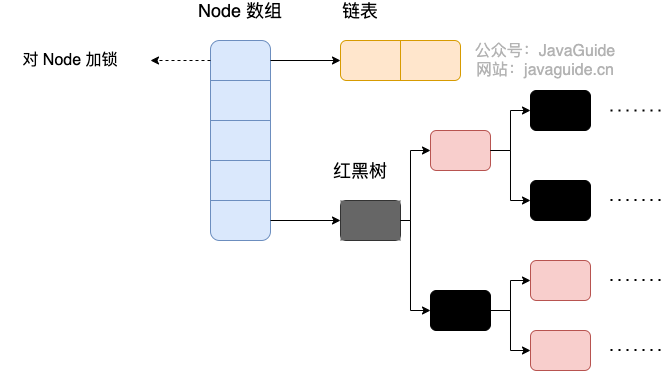
ConcurrentHashMap JDK1.8 không còn là Segment array + HashEntry array + linked list, mà là Node array + linked list/red-black tree. Tuy nhiên, Node chỉ dùng được trong trường hợp linked list; trường hợp red-black tree cần dùng TreeNode. Khi linked list xử lý collision đạt đến độ dài nhất định, linked list sẽ được chuyển thành red-black tree.
TreeNode dùng để lưu node của red-black tree và được TreeBin bọc lại. TreeBin duy trì root của red-black tree thông qua thuộc tính root, vì khi red-black tree xoay, root có thể bị node con ban đầu thay thế. Tại thời điểm đó, nếu thread khác muốn ghi vào red-black tree này thì sẽ xảy ra vấn đề thread-safe. Vì vậy trong ConcurrentHashMap, TreeBin duy trì thread hiện đang sử dụng red-black tree này thông qua thuộc tính waiter, nhằm ngăn thread khác đi vào.
static final class TreeBin<K,V> extends Node<K,V> {
        TreeNode<K,V> root;
        volatile TreeNode<K,V> first;
        volatile Thread waiter;
        volatile int lockState;
        // values for lockState
        static final int WRITER = 1; // set while holding write lock
        static final int WAITER = 2; // set when waiting for write lock
        static final int READER = 4; // increment value for setting read lock
...
}
⭐️ Cách triển khai cụ thể thread-safe / triển khai cụ thể bên trong của ConcurrentHashMap
Trước JDK1.8
Trước tiên dữ liệu được chia thành từng đoạn để lưu trữ (đoạn này chính là Segment), sau đó mỗi đoạn dữ liệu được gán một lock. Khi một thread chiếm lock để truy cập dữ liệu của một đoạn, dữ liệu của các đoạn khác vẫn có thể được thread khác truy cập.
ConcurrentHashMap được cấu thành từ cấu trúc Segment array và cấu trúc HashEntry array.
Segment kế thừa ReentrantLock, vì vậy Segment là một reentrant lock và đóng vai trò lock. HashEntry dùng để lưu trữ dữ liệu key-value.
static class Segment<K,V> extends ReentrantLock implements Serializable {
}
Một ConcurrentHashMap chứa một Segment array. Số lượng Segment một khi khởi tạo thì không thể thay đổi. Kích thước Segment array mặc định là 16, nghĩa là mặc định có thể đồng thời hỗ trợ 16 thread ghi concurrent.
Cấu trúc Segment tương tự HashMap, là cấu trúc array và linked list. Một Segment chứa một HashEntry array, mỗi HashEntry là một phần tử của linked list, mỗi Segment quản lý các phần tử trong một HashEntry array. Khi sửa dữ liệu trong HashEntry array, trước tiên phải lấy lock của Segment tương ứng. Nói cách khác, các thao tác ghi concurrent trên cùng một Segment sẽ bị blocking, còn thao tác ghi trên các Segment khác nhau có thể thực thi concurrent.
Sau JDK1.8
Java 8 gần như viết lại hoàn toàn ConcurrentHashMap, số dòng code từ hơn 1000 dòng trong Java 7 tăng thành hơn 6000 dòng hiện tại.
ConcurrentHashMap loại bỏ segmented lock Segment, dùng Node + CAS + synchronized để bảo đảm concurrent safety. Cấu trúc dữ liệu tương tự cấu trúc của HashMap 1.8, tức array + linked list/red-black tree. Trong Java 8, khi độ dài linked list vượt quá ngưỡng nhất định (8), linked list (time complexity tra cứu là O(N)) được chuyển thành red-black tree (time complexity tra cứu là O(log(N)).
Trong Java 8, lock granularity nhỏ hơn. Khi cập nhật bucket không rỗng, thông thường dùng synchronized để lock node đầu của bucket; việc cập nhật trên các bucket khác nhau thường có thể thực thi song song, còn thao tác đọc không dùng các bucket lock này.
⭐️ Cách triển khai ConcurrentHashMap của JDK 1.7 và JDK 1.8 khác nhau như thế nào?
- Cách triển khai thread-safe: JDK 1.7 dùng segmented lock
Segmentđể bảo đảm an toàn,Segmentkế thừaReentrantLock. JDK1.8 từ bỏ thiết kế segmented lockSegment, dùngNode + CAS + synchronizedđể bảo đảm thread-safe, lock granularity nhỏ hơn,synchronizedchỉ lock node đầu của linked list hoặc red-black tree hiện tại. - Cách xử lý Hash collision: JDK 1.7 dùng separate chaining, JDK1.8 dùng separate chaining kết hợp red-black tree (khi độ dài linked list vượt ngưỡng nhất định thì chuyển linked list thành red-black tree).
- Concurrency level: Trong JDK 1.7, việc cập nhật concurrent chủ yếu bị giới hạn bởi số lượng
Segment, mặc định là 16. JDK 1.8 không còn dùng số lượngSegmentcố định, việc cập nhật trên các bucket khác nhau thường có thể thực thi song song.
Vì sao key và value của ConcurrentHashMap không thể là null?
Key và value của ConcurrentHashMap không thể là null, chủ yếu để tránh ambiguity. Null là một giá trị đặc biệt, biểu thị không có object hoặc không có reference. Nếu dùng null làm key, bạn không thể phân biệt key này có tồn tại trong ConcurrentHashMap hay thực tế không có key này. Tương tự, nếu dùng null làm value, bạn không thể phân biệt value này thực sự được lưu trong ConcurrentHashMap hay được trả về vì không tìm thấy key tương ứng.
Xét method get, kết quả trả về null có hai trường hợp:
- Value không có trong collection;
- Bản thân value là null.
Đây chính là nguồn gốc của ambiguity.
Có thể tham khảo phân tích source code ConcurrentHashMap.
Trong môi trường đa thread, khi một thread đang thao tác với ConcurrentHashMap, các thread khác có thể sửa ConcurrentHashMap, nên không thể dùng containsKey(key) để phán đoán key-value này có tồn tại hay không, vì vậy cũng không thể giải quyết vấn đề ambiguity.
Ngược lại, HashMap có thể lưu trữ key và value là null, nhưng null làm key chỉ có thể có một, còn null làm value có thể có nhiều. Nếu truyền null làm parameter, nó sẽ trả về value ở vị trí có hash value bằng 0. Trong môi trường single-thread, khi một thread thao tác với HashMap sẽ không có thread khác sửa HashMap, nên có thể dùng containsKey(key) để phán đoán key-value có tồn tại hay không và xử lý tương ứng, do đó không có vấn đề ambiguity.
Nói cách khác, trong môi trường đa thread không thể phán đoán chính xác key-value có tồn tại hay không (do có thể bị thread khác sửa), còn trong môi trường single-thread thì có thể (không có thread khác sửa).
Nếu thực sự cần dùng null trong ConcurrentHashMap, bạn có thể dùng một static empty object đặc biệt để thay thế null.
public static final Object NULL = new Object();Cuối cùng, hãy chia sẻ câu trả lời của chính tác giả ConcurrentHashMap (Doug Lea) về vấn đề này:
The main reason that nulls aren't allowed in ConcurrentMaps (ConcurrentHashMaps, ConcurrentSkipListMaps) is that ambiguities that may be just barely tolerable in non-concurrent maps can't be accommodated. The main one is that if
map.get(key)returnsnull, you can't detect whether the key explicitly maps tonullvs the key isn't mapped. In a non-concurrent map, you can check this viamap.contains(key), but in a concurrent one, the map might have changed between calls.
Dịch ra, đại ý vẫn là ambiguity có thể chấp nhận trong single-thread, nhưng không thể chấp nhận trong multi-thread.
⭐️ ConcurrentHashMap có bảo đảm tính atomic của composite operation không?
ConcurrentHashMap thread-safe, nghĩa là khi nhiều thread đồng thời đọc ghi nó, có thể bảo đảm không xuất hiện tình trạng dữ liệu không nhất quán, cũng không gây ra vấn đề infinite loop do thao tác HashMap đa thread trong JDK1.7 và các phiên bản trước. Tuy nhiên, điều đó không có nghĩa là nó có thể bảo đảm mọi composite operation đều atomic, nhất định không được nhầm lẫn!
Composite operation là operation gồm nhiều operation cơ bản (put, get, remove, containsKey, v.v.), chẳng hạn trước tiên kiểm tra một key có tồn tại hay không bằng containsKey(key), sau đó chèn hoặc update bằng put(key, value) dựa trên kết quả. Trong quá trình thực thi operation này, thread khác có thể ngắt giữa chừng, khiến kết quả không như mong đợi.
Ví dụ, có hai thread A và B đồng thời thực hiện composite operation trên ConcurrentHashMap như sau:
// Thread A
if (!map.containsKey(key)) {
map.put(key, value);
}
// Thread B
if (!map.containsKey(key)) {
map.put(key, anotherValue);
}
Nếu thứ tự thực thi của thread A và B như sau:
- Thread A phán đoán map không có key
- Thread B phán đoán map không có key
- Thread B chèn
(key, anotherValue)vào map - Thread A chèn
(key, value)vào map
Khi đó kết quả cuối cùng là (key, value), không phải (key, anotherValue) như mong đợi. Đây là vấn đề do composite operation không atomic gây ra.
Vậy làm thế nào để bảo đảm tính atomic của composite operation trong ConcurrentHashMap?
ConcurrentHashMap cung cấp một số composite operation atomic như putIfAbsent, compute, computeIfAbsent, computeIfPresent, merge, v.v. Các method này đều có thể nhận một function làm parameter, tính value mới dựa trên key và value đã cho, rồi update nó vào map.
Code bên trên có thể viết lại như sau:
// Thread A
map.putIfAbsent(key, value);
// Thread B
map.putIfAbsent(key, anotherValue);
Hoặc:
// Thread A
map.computeIfAbsent(key, k -> value);
// Thread B
map.computeIfAbsent(key, k -> anotherValue);
Nhiều bạn có thể sẽ nói rằng trường hợp này cũng có thể dùng lock để đồng bộ! Đúng là có thể, nhưng không khuyến khích dùng cơ chế đồng bộ bằng lock, vì đi ngược mục đích ban đầu của việc sử dụng ConcurrentHashMap. Khi dùng ConcurrentHashMap, hãy cố gắng sử dụng các method composite operation atomic này để bảo đảm tính atomic.
Utility class Collections (không quan trọng)
Các method thường dùng của utility class Collections:
- Sắp xếp
- Tìm kiếm, thay thế
- Điều khiển đồng bộ (không khuyến khích; khi cần collection thread-safe, hãy cân nhắc dùng concurrent collection trong package JUC)
Thao tác sắp xếp
void reverse(List list)//đảo ngược
void shuffle(List list)//sắp xếp ngẫu nhiên
void sort(List list)//sắp xếp tăng dần theo thứ tự tự nhiên
void sort(List list, Comparator c)//sắp xếp tùy chỉnh, do Comparator kiểm soát logic sắp xếp
void swap(List list, int i , int j)//hoán đổi các phần tử ở hai index
void rotate(List list, int distance)//xoay. Khi distance là số dương, di chuyển toàn bộ distance phần tử sau cùng của list lên trước. Khi distance là số âm, di chuyển distance phần tử đầu của list ra sau
Thao tác tìm kiếm, thay thế
int binarySearch(List list, Object key)//tìm kiếm nhị phân trên List, trả về index; lưu ý List phải có thứ tự
int max(Collection coll)//theo thứ tự tự nhiên của phần tử, trả về phần tử lớn nhất. Tương tự int min(Collection coll)
int max(Collection coll, Comparator c)//theo cách sắp xếp tùy chỉnh, trả về phần tử lớn nhất; quy tắc sắp xếp do class Comparator kiểm soát. Tương tự int min(Collection coll, Comparator c)
void fill(List list, Object obj)//dùng phần tử được chỉ định thay thế toàn bộ phần tử trong list được chỉ định
int frequency(Collection c, Object o)//đếm số lần phần tử xuất hiện
int indexOfSubList(List list, List target)//đếm index xuất hiện lần đầu của target trong list; nếu không tìm thấy trả về -1; tương tự int lastIndexOfSubList(List source, list target)
boolean replaceAll(List list, Object oldVal, Object newVal)//dùng phần tử mới thay thế phần tử cũ
Điều khiển đồng bộ
Collections cung cấp nhiều method synchronizedXxx(). Các method này có thể bọc collection được chỉ định thành collection đồng bộ, từ đó giải quyết vấn đề thread-safe khi nhiều thread truy cập concurrent vào collection.
Mọi thao tác truy cập đều phải thông qua wrapper được trả về; khi dùng Iterator, Spliterator hoặc Stream để iterate, còn cần tự đồng bộ wrapper này.
Chúng ta biết HashSet, TreeSet, ArrayList, LinkedList, HashMap, TreeMap đều không thread-safe. Collections cung cấp nhiều static method để bọc chúng thành collection đồng bộ.
Tốt nhất không nên dùng các method dưới đây vì hiệu suất rất thấp; khi cần collection thread-safe, hãy cân nhắc dùng concurrent collection trong package JUC.
Các method như sau:
synchronizedCollection(Collection<T>  c) //trả về collection đồng bộ (thread-safe) được hỗ trợ bởi collection được chỉ định.
synchronizedList(List<T> list)//trả về List đồng bộ (thread-safe) được hỗ trợ bởi list được chỉ định.
synchronizedMap(Map<K,V> m) //trả về Map đồng bộ (thread-safe) được hỗ trợ bởi map được chỉ định.
synchronizedSet(Set<T> s) //trả về set đồng bộ (thread-safe) được hỗ trợ bởi set được chỉ định.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.