
Phân tích source code ConcurrentHashMap
Bài viết này do Mò code gửi: https://mp.weixin.qq.com/s/AHWzboztt53ZfFZmsSnMSw, JavaGuide đã cải tiến và tối ưu đáng kể bài viết gốc.
Bài viết trước đã giới thiệu source code HashMap và nhận được phản hồi khá tốt, đồng thời cũng có nhiều bạn đưa ra quan điểm của mình. Lần này chúng ta sẽ tìm hiểu ConcurrentHashMap, một HashMap thread-safe được sử dụng rất thường xuyên. Vậy cấu trúc lưu trữ và nguyên lý triển khai của nó như thế nào?
1. ConcurrentHashMap 1.7
1. Cấu trúc lưu trữ
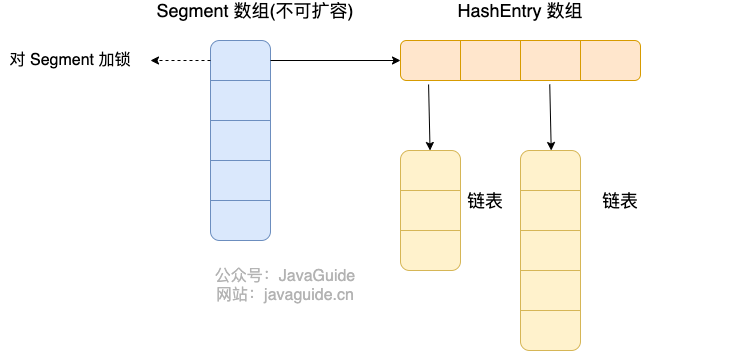
Cấu trúc lưu trữ của ConcurrentHashMap trong Java 7 như hình trên. ConcurrentHashMap được ghép từ nhiều Segment, mỗi Segment là một cấu trúc tương tự HashMap, vì vậy bảng bên trong mỗi Segment có thể mở rộng capacity. Tuy nhiên, số lượng Segment không thể thay đổi sau khi khởi tạo. Mặc định có 16 Segment, do đó mặc định nhiều nhất 16 phân đoạn có thể đồng thời thực hiện thao tác update.
2. Khởi tạo
Hãy tìm hiểu flow khởi tạo ConcurrentHashMap thông qua constructor không tham số của ConcurrentHashMap.
    /**
     * Creates a new, empty map with a default initial capacity (16),
     * load factor (0.75) and concurrencyLevel (16).
     */
    public ConcurrentHashMap() {
        this(DEFAULT_INITIAL_CAPACITY, DEFAULT_LOAD_FACTOR, DEFAULT_CONCURRENCY_LEVEL);
    }
Constructor không tham số gọi constructor có tham số và truyền vào ba giá trị mặc định. Các giá trị đó là:
    /**
     * Capacity khởi tạo mặc định
     */
    static final int DEFAULT_INITIAL_CAPACITY = 16;

    /**
     * Load factor mặc định
     */
    static final float DEFAULT_LOAD_FACTOR = 0.75f;

    /**
     * Mức concurrency mặc định
     */
    static final int DEFAULT_CONCURRENCY_LEVEL = 16;
Tiếp theo hãy xem logic triển khai bên trong constructor có tham số này.
@SuppressWarnings("unchecked")
public ConcurrentHashMap(int initialCapacity,float loadFactor, int concurrencyLevel) {
    // Kiểm tra tham số
    if (!(loadFactor > 0) || initialCapacity < 0 || concurrencyLevel <= 0)
        throw new IllegalArgumentException();
    // Kiểm tra kích thước concurrency level, nếu lớn hơn 1<<16 thì đặt lại thành 65536
    if (concurrencyLevel > MAX_SEGMENTS)
        concurrencyLevel = MAX_SEGMENTS;
    // Find power-of-two sizes best matching arguments
    // Số mũ của 2
    int sshift = 0;
    int ssize = 1;
    // Vòng lặp này tìm giá trị lũy thừa của 2 gần nhất nhưng lớn hơn hoặc bằng concurrencyLevel
    while (ssize < concurrencyLevel) {
        ++sshift;
        ssize <<= 1;
    }
    // Ghi lại segment shift
    this.segmentShift = 32 - sshift;
    // Ghi lại segment mask
    this.segmentMask = ssize - 1;
    // Thiết lập capacity
    if (initialCapacity > MAXIMUM_CAPACITY)
        initialCapacity = MAXIMUM_CAPACITY;
    // c = capacity / ssize, mặc định 16 / 16 = 1, dùng để tính capacity tương tự HashMap trong mỗi Segment
    int c = initialCapacity / ssize;
    if (c * ssize < initialCapacity)
        ++c;
    int cap = MIN_SEGMENT_TABLE_CAPACITY;
    // Capacity tương tự HashMap trong Segment ít nhất là 2 và tăng theo lũy thừa của 2
    while (cap < c)
        cap <<= 1;
    // create segments and segments[0]
    // Tạo mảng Segment và thiết lập segments[0]
    Segment<K,V> s0 = new Segment<K,V>(loadFactor, (int)(cap * loadFactor),
                         (HashEntry<K,V>[])new HashEntry[cap]);
    Segment<K,V>[] ss = (Segment<K,V>[])new Segment[ssize];
    UNSAFE.putOrderedObject(ss, SBASE, s0); // ordered write of segments[0]
    this.segments = ss;
}
Tóm tắt logic khởi tạo ConcurrentHashMap trong Java 7:
- Kiểm tra các tham số cần thiết.
- Kiểm tra kích thước
concurrencyLevel; nếu lớn hơn giá trị tối đa thì đặt lại thành giá trị tối đa. Giá trị mặc định của constructor không tham số là 16. - Tìm giá trị lũy thừa của 2 gần nhất nhưng lớn hơn hoặc bằng
concurrencyLevel, dùng làm độ dài mảngsegments, mặc định là 16. - Ghi lại
segmentShift; giá trị này là 32 - sshift, được sử dụng khi tính vị trí trong thao tác put về sau, mặc định là 28. - Ghi lại
segmentMask, mặc định là ssize - 1 = 16 - 1 = 15. - Khởi tạo
segments[0], kích thước mặc định là 2, load factor 0.75, ngưỡng mở rộng là 2 * 0.75 = 1.5, nên chỉ khi chèn giá trị thứ hai mới mở rộng capacity.
3. put
Tiếp tục với các tham số khởi tạo ở trên để xem source code method put.
/**
 * Maps the specified key to the specified value in this table.
 * Neither the key nor the value can be null.
 *
 * <p> The value can be retrieved by calling the <tt>get</tt> method
 * with a key that is equal to the original key.
 *
 * @param key key with which the specified value is to be associated
 * @param value value to be associated with the specified key
 * @return the previous value associated with <tt>key</tt>, or
 *         <tt>null</tt> if there was no mapping for <tt>key</tt>
 * @throws NullPointerException if the specified key or value is null
 */
public V put(K key, V value) {
    Segment<K,V> s;
    if (value == null)
        throw new NullPointerException();
    int hash = hash(key);
    // Dịch phải không dấu giá trị hash 28 bit (nhận được khi khởi tạo), sau đó thực hiện phép AND với segmentMask=15
    // Thực chất là thực hiện phép AND 4 bit cao với segmentMask (1111)
    int j = (hash >>> segmentShift) & segmentMask;
    if ((s = (Segment<K,V>)UNSAFE.getObject          // nonvolatile; recheck
         (segments, (j << SSHIFT) + SBASE)) == null) //  in ensureSegment
        // Nếu Segment tìm được là null thì khởi tạo
        s = ensureSegment(j);
    return s.put(key, hash, value, false);
}

/**
 * Returns the segment for the given index, creating it and
 * recording in segment table (via CAS) if not already present.
 *
 * @param k the index
 * @return the segment
 */
@SuppressWarnings("unchecked")
private Segment<K,V> ensureSegment(int k) {
    final Segment<K,V>[] ss = this.segments;
    long u = (k << SSHIFT) + SBASE; // raw offset
    Segment<K,V> seg;
    // Kiểm tra Segment tại vị trí u có phải null không
    if ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u)) == null) {
        Segment<K,V> proto = ss[0]; // use segment 0 as prototype
        // Lấy độ dài khởi tạo của HashEntry<K,V> trong segment số 0
        int cap = proto.table.length;
        // Lấy load factor mở rộng của hash table trong segment số 0; loadFactor của mọi segment giống nhau
        float lf = proto.loadFactor;
        // Tính ngưỡng mở rộng
        int threshold = (int)(cap * lf);
        // Tạo mảng HashEntry có capacity cap
        HashEntry<K,V>[] tab = (HashEntry<K,V>[])new HashEntry[cap];
        if ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u)) == null) { // recheck
            // Kiểm tra lại Segment tại vị trí u có phải null không, vì trong lúc này thread khác có thể đã thao tác
            Segment<K,V> s = new Segment<K,V>(lf, threshold, tab);
            // Spin kiểm tra Segment tại vị trí u có phải null không
            while ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u))
                   == null) {
                // Gán bằng CAS, chỉ thành công một lần
                if (UNSAFE.compareAndSwapObject(ss, u, null, seg = s))
                    break;
            }
        }
    }
    return seg;
}
Source code trên đã phân tích flow xử lý của ConcurrentHashMap khi put một dữ liệu. Hãy tổng hợp flow cụ thể:
Tính vị trí của key cần put và lấy
Segmenttại vị trí đó.Nếu
Segmenttại vị trí chỉ định là null thì khởi tạoSegmentđó.Flow khởi tạo Segment:
- Kiểm tra
Segmenttại vị trí đã tính có phải null không. - Nếu là null thì tiếp tục khởi tạo, dùng capacity và load factor của
Segment[0]để tạo mảngHashEntry. - Kiểm tra lại
Segmenttại vị trí chỉ định đã tính có phải null không. - Dùng mảng
HashEntryđã tạo để khởi tạo Segment này. - Spin kiểm tra
Segmenttại vị trí đã tính có phải null không, dùng CAS để gánSegmentvào vị trí đó.
- Kiểm tra
Segment.putchèn giá trị key, value.
Ở trên đã tìm hiểu thao tác lấy và khởi tạo Segment. Method put của Segment ở dòng cuối vẫn chưa được xem xét, hãy tiếp tục phân tích.
final V put(K key, int hash, V value, boolean onlyIfAbsent) {
    // Lấy exclusive lock ReentrantLock; nếu không lấy được thì dùng scanAndLockForPut.
    HashEntry<K,V> node = tryLock() ? null : scanAndLockForPut(key, hash, value);
    V oldValue;
    try {
        HashEntry<K,V>[] tab = table;
        // Tính vị trí của dữ liệu cần put
        int index = (tab.length - 1) & hash;
        // Đọc giá trị tại vị trí index bằng thao tác volatile
        HashEntry<K,V> first = entryAt(tab, index);
        for (HashEntry<K,V> e = first;;) {
            if (e != null) {
                // Kiểm tra key đã tồn tại chưa; nếu có thì duyệt linked list để tìm vị trí, sau đó thay thế value
                K k;
                if ((k = e.key) == key ||
                    (e.hash == hash && key.equals(k))) {
                    oldValue = e.value;
                    if (!onlyIfAbsent) {
                        e.value = value;
                        ++modCount;
                    }
                    break;
                }
                e = e.next;
            }
            else {
                // first null nghĩa là vị trí index chưa có giá trị, tạo node mới tại vị trí này.
                if (node != null)
                    node.setNext(first);
                else
                    node = new HashEntry<K,V>(hash, key, value, first);
                int c = count + 1;
                // Nếu capacity lớn hơn ngưỡng mở rộng và nhỏ hơn capacity tối đa thì mở rộng
                if (c > threshold && tab.length < MAXIMUM_CAPACITY)
                    rehash(node);
                else
                    // Gán node vào vị trí index; node có thể là một phần tử hoặc node đầu linked list
                    setEntryAt(tab, index, node);
                ++modCount;
                count = c;
                oldValue = null;
                break;
            }
        }
    } finally {
        unlock();
    }
    return oldValue;
}
Vì Segment kế thừa ReentrantLock, việc lấy lock bên trong Segment khá thuận tiện; flow put đã sử dụng chức năng này.
tryLock()lấy lock; nếu không lấy được thì tiếp tục lấy lock bằng methodscanAndLockForPut.Tính vị trí index cần đặt dữ liệu put, sau đó lấy
HashEntrytại vị trí này.Duyệt các node tại vị trí để put phần tử mới. Tại sao phải duyệt? Vì
HashEntrylấy được có thể là phần tử rỗng hoặc có thể đã tồn tại dưới dạng linked list, nên cần xử lý khác nhau.Nếu
HashEntrytại vị trí này không tồn tại:- Nếu capacity hiện tại lớn hơn ngưỡng mở rộng và nhỏ hơn capacity tối đa thì mở rộng.
- Chèn trực tiếp vào đầu linked list.
Nếu
HashEntrytại vị trí này tồn tại:- Kiểm tra key và hash của phần tử hiện tại trong linked list có giống key và hash cần put không. Nếu giống thì thay thế value.
- Nếu không giống, lấy node tiếp theo của linked list cho đến khi tìm thấy phần tử giống để thay thế value, hoặc duyệt hết linked list mà không tìm thấy phần tử giống.
- Nếu capacity hiện tại lớn hơn ngưỡng mở rộng và nhỏ hơn capacity tối đa thì mở rộng.
- Chèn trực tiếp vào đầu linked list.
Nếu vị trí cần chèn đã tồn tại phần tử thì thay thế và trả về value cũ; nếu không thì trả về null.
Thao tác scanAndLockForPut ở bước đầu tiên chưa được giới thiệu. Method này liên tục spin và gọi tryLock() để lấy lock. Khi số lần spin lớn hơn số lần chỉ định, nó dùng lock() để block cho đến khi lấy được lock. Trong lúc spin, method đồng thời lấy HashEntry tại vị trí hash.
private HashEntry<K,V> scanAndLockForPut(K key, int hash, V value) {
    HashEntry<K,V> first = entryForHash(this, hash);
    HashEntry<K,V> e = first;
    HashEntry<K,V> node = null;
    int retries = -1; // negative while locating node
    // Spin để lấy lock
    while (!tryLock()) {
        HashEntry<K,V> f; // to recheck first below
        if (retries < 0) {
            if (e == null) {
                if (node == null) // speculatively create node
                    node = new HashEntry<K,V>(hash, key, value, null);
                retries = 0;
            }
            else if (key.equals(e.key))
                retries = 0;
            else
                e = e.next;
        }
        else if (++retries > MAX_SCAN_RETRIES) {
            // Sau khi spin đủ số lần chỉ định, block cho đến khi lấy được lock
            lock();
            break;
        }
        else if ((retries & 1) == 0 &&
                 (f = entryForHash(this, hash)) != first) {
            e = first = f; // re-traverse if entry changed
            retries = -1;
        }
    }
    return node;
}
4. Mở rộng rehash
ConcurrentHashMap chỉ mở rộng capacity lên gấp đôi capacity hiện tại. Khi di chuyển dữ liệu từ mảng cũ sang mảng mới, vị trí hoặc không đổi, hoặc trở thành index + oldSize; node trong tham số sẽ được chèn vào vị trí chỉ định bằng cách chèn vào đầu linked list sau khi mở rộng.
private void rehash(HashEntry<K,V> node) {
    HashEntry<K,V>[] oldTable = table;
    // Capacity cũ
    int oldCapacity = oldTable.length;
    // Capacity mới, tăng gấp đôi
    int newCapacity = oldCapacity << 1;
    // Ngưỡng mở rộng mới
    threshold = (int)(newCapacity * loadFactor);
    // Tạo mảng mới
    HashEntry<K,V>[] newTable = (HashEntry<K,V>[]) new HashEntry[newCapacity];
    // Mask mới, sau khi capacity mặc định 2 mở rộng thành 4, -1 là 3, biểu diễn nhị phân là 11.
    int sizeMask = newCapacity - 1;
    for (int i = 0; i < oldCapacity ; i++) {
        // Duyệt mảng cũ
        HashEntry<K,V> e = oldTable[i];
        if (e != null) {
            HashEntry<K,V> next = e.next;
            // Tính vị trí mới, vị trí mới chỉ có thể không đổi hoặc bằng vị trí cũ + capacity cũ.
            int idx = e.hash & sizeMask;
            if (next == null)   //  Single node on list
                // Nếu vị trí hiện tại chưa phải linked list mà chỉ là một phần tử thì gán trực tiếp
                newTable[idx] = e;
            else { // Reuse consecutive sequence at same slot
                // Nếu là linked list
                HashEntry<K,V> lastRun = e;
                int lastIdx = idx;
                // Vị trí mới chỉ có thể không đổi hoặc bằng vị trí cũ + capacity cũ.
                // Sau khi duyệt xong, vị trí của các phần tử phía sau lastRun đều giống nhau
                for (HashEntry<K,V> last = next; last != null; last = last.next) {
                    int k = last.hash & sizeMask;
                    if (k != lastIdx) {
                        lastIdx = k;
                        lastRun = last;
                    }
                }
                // Các phần tử phía sau lastRun có cùng vị trí, gán trực tiếp chúng vào vị trí mới dưới dạng linked list.
                newTable[lastIdx] = lastRun;
                // Clone remaining nodes
                for (HashEntry<K,V> p = e; p != lastRun; p = p.next) {
                    // Duyệt các phần tử còn lại, chèn vào đầu linked list tại vị trí k chỉ định.
                    V v = p.value;
                    int h = p.hash;
                    int k = h & sizeMask;
                    HashEntry<K,V> n = newTable[k];
                    newTable[k] = new HashEntry<K,V>(h, p.key, v, n);
                }
            }
        }
    }
    // Chèn node mới vào đầu linked list
    int nodeIndex = node.hash & sizeMask; // add the new node
    node.setNext(newTable[nodeIndex]);
    newTable[nodeIndex] = node;
    table = newTable;
}
Một số bạn có thể thắc mắc về hai vòng for cuối. Vòng for đầu tiên dùng để tìm một node sao cho vị trí mới của tất cả node next phía sau node này đều giống nhau. Sau đó node này được gán vào vị trí mới dưới dạng một linked list. Vòng for thứ hai dùng để chèn các phần tử còn lại vào linked list tại vị trí chỉ định bằng cách chèn vào đầu. Lý do triển khai như vậy có thể dựa trên thống kê xác suất; nếu nghiên cứu sâu hơn, bạn có thể chia sẻ ý kiến của mình.
Trong vòng for thứ hai bên trong, new HashEntry<K,V>(h, p.key, v, n) được dùng để tạo một HashEntry mới thay vì tái sử dụng node trước đó. Lý do là nếu tái sử dụng node cũ, thread đang duyệt (chẳng hạn đang thực thi method get) có thể không duyệt tiếp được do pointer bị thay đổi. Như comment đã nói:
Khi không còn được bất kỳ reader thread nào có thể đang đồng thời duyệt table tham chiếu đến, các node bị thay thế sẽ có thể được garbage collection.
The nodes they replace will be garbage collectable as soon as they are no longer referenced by any reader thread that may be in the midst of concurrently traversing table
Tại sao cần thêm một vòng for để tìm lastRun? Thực chất là để giảm số lần tạo object, như comment đã nói:
Theo thống kê, ở threshold mặc định, chỉ khoảng một phần sáu số node cần được clone khi table tăng gấp đôi.
Statistically, at the default threshold, only about one-sixth of them need cloning when a table doubles.
5. get
Đến đây khá đơn giản, method get chỉ cần hai bước:
- Tính vị trí lưu trữ key.
- Duyệt vị trí chỉ định để tìm value có key giống nhau.
public V get(Object key) {
    Segment<K,V> s; // manually integrate access methods to reduce overhead
    HashEntry<K,V>[] tab;
    int h = hash(key);
    long u = (((h >>> segmentShift) & segmentMask) << SSHIFT) + SBASE;
    // Tính vị trí lưu trữ key
    if ((s = (Segment<K,V>)UNSAFE.getObjectVolatile(segments, u)) != null &&
        (tab = s.table) != null) {
        for (HashEntry<K,V> e = (HashEntry<K,V>) UNSAFE.getObjectVolatile
                 (tab, ((long)(((tab.length - 1) & h)) << TSHIFT) + TBASE);
             e != null; e = e.next) {
            // Nếu là linked list thì duyệt để tìm value có key giống nhau.
            K k;
            if ((k = e.key) == key || (e.hash == h && key.equals(k)))
                return e.value;
        }
    }
    return null;
}
2. ConcurrentHashMap 1.8
Nhìn chung, ConcurrentHashMap trong Java 8 đã thay đổi khá nhiều so với Java 7.
1. Cấu trúc lưu trữ
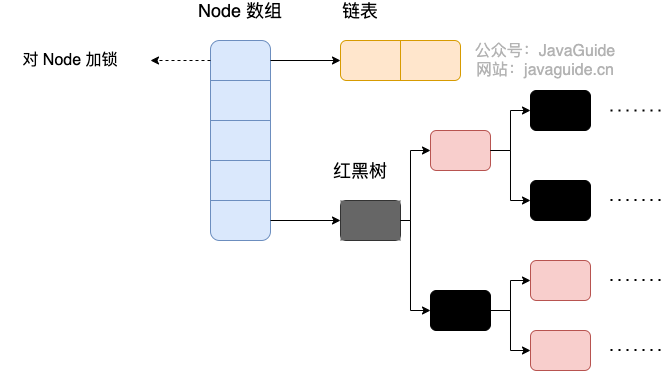
Có thể thấy ConcurrentHashMap trong Java 8 đã thay đổi khá nhiều so với Java 7. Nó không còn là mảng Segment + mảng HashEntry + linked list như trước, mà trở thành mảng Node + linked list / red-black tree. Khi collision trong linked list đạt đến độ dài nhất định, linked list sẽ được chuyển thành red-black tree.
2. Khởi tạo initTable
/**
 * Initializes table, using the size recorded in sizeCtl.
 */
private final Node<K,V>[] initTable() {
    Node<K,V>[] tab; int sc;
    while ((tab = table) == null || tab.length == 0) {
        // Nếu sizeCtl < 0, nghĩa là thread khác đã CAS thành công và đang khởi tạo.
        if ((sc = sizeCtl) < 0)
            // Nhường quyền sử dụng CPU
            Thread.yield(); // lost initialization race; just spin
        else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {
            try {
                if ((tab = table) == null || tab.length == 0) {
                    int n = (sc > 0) ? sc : DEFAULT_CAPACITY;
                    @SuppressWarnings("unchecked")
                    Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                    table = tab = nt;
                    sc = n - (n >>> 2);
                }
            } finally {
                sizeCtl = sc;
            }
            break;
        }
    }
    return tab;
}
Từ source code có thể thấy việc khởi tạo ConcurrentHashMap được hoàn tất bằng thao tác spin và CAS. Cần chú ý đến biến sizeCtl (viết tắt của sizeControl); giá trị của nó quyết định trạng thái khởi tạo hiện tại.
-1cho biết đang khởi tạo, các thread khác cần spin chờ.-Ncho biết table đang mở rộng; 16 bit cao biểu thị resize stamp, 16 bit thấp trừ 1 là số thread đang thực hiện mở rộng.0cho biết table chưa được khởi tạo; khi khởi tạo sẽ dùng capacity mặc định.>0cho biết threshold mở rộng của table nếu table đã được khởi tạo.
3. put
Hãy xem trực tiếp source code put.
public V put(K key, V value) {
    return putVal(key, value, false);
}

/** Implementation for put and putIfAbsent */
final V putVal(K key, V value, boolean onlyIfAbsent) {
    // key và value không được null
    if (key == null || value == null) throw new NullPointerException();
    int hash = spread(key.hashCode());
    int binCount = 0;
    for (Node<K,V>[] tab = table;;) {
        // f = phần tử tại vị trí đích
        Node<K,V> f; int n, i, fh;// fh lưu hash của phần tử tại vị trí đích ở phía sau
        if (tab == null || (n = tab.length) == 0)
            // Bucket của array rỗng, khởi tạo bucket của array (spin + CAS)
            tab = initTable();
        else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
            // Bucket rỗng, dùng CAS để put, không lock; nếu thành công thì break trực tiếp
            if (casTabAt(tab, i, null,new Node<K,V>(hash, key, value, null)))
                break;  // no lock when adding to empty bin
        }
        else if ((fh = f.hash) == MOVED)
            tab = helpTransfer(tab, f);
        else {
            V oldVal = null;
            // Dùng synchronized lock để thêm node
            synchronized (f) {
                if (tabAt(tab, i) == f) {
                    // Cho biết đây là linked list
                    if (fh >= 0) {
                        binCount = 1;
                        // Lặp để thêm node mới hoặc ghi đè node
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            Node<K,V> pred = e;
                            if ((e = e.next) == null) {
                                pred.next = new Node<K,V>(hash, key,
                                                          value, null);
                                break;
                            }
                        }
                    }
                    else if (f instanceof TreeBin) {
                        // Red-black tree
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                                       value)) != null) {
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                }
            }
            if (binCount != 0) {
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i);
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount);
    return null;
}
Tính hashcode từ key.
Kiểm tra có cần khởi tạo hay không.
Nếu Node tại vị trí được định vị bởi key là null, nghĩa là có thể ghi dữ liệu vào vị trí hiện tại; dùng CAS để thử ghi. Nếu thất bại, quay lại loop và kiểm tra trạng thái mới nhất.
Nếu
hashcode == MOVED == -1tại vị trí hiện tại thì cần mở rộng.Nếu không rơi vào các trường hợp trên thì dùng lock synchronized để ghi dữ liệu.
Nếu số lượng lớn hơn
TREEIFY_THRESHOLDthì thực thi method treeify. TrongtreeifyBin, trước hết sẽ kiểm tra độ dài array >= 64 thì mới chuyển linked list thành red-black tree.
4. get
Flow get khá đơn giản, hãy xem trực tiếp source code.
public V get(Object key) {
    Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek;
    // Vị trí hash chứa key
    int h = spread(key.hashCode());
    if ((tab = table) != null && (n = tab.length) > 0 &&
        (e = tabAt(tab, (n - 1) & h)) != null) {
        // Nếu phần tử tại vị trí chỉ định tồn tại và hash của head node giống nhau
        if ((eh = e.hash) == h) {
            if ((ek = e.key) == key || (ek != null && key.equals(ek)))
                // Hash của key bằng nhau, key giống nhau, trả về value của phần tử trực tiếp
                return e.val;
        }
        else if (eh < 0)
            // Hash của head node nhỏ hơn 0, cho biết đang mở rộng hoặc là red-black tree, tìm kiếm bằng find
            return (p = e.find(h, key)) != null ? p.val : null;
        while ((e = e.next) != null) {
            // Là linked list, duyệt để tìm kiếm
            if (e.hash == h &&
                ((ek = e.key) == key || (ek != null && key.equals(ek))))
                return e.val;
        }
    }
    return null;
}
Tóm tắt flow get:
- Tính vị trí theo hash.
- Tìm đến vị trí chỉ định; nếu head node chính là node cần tìm thì trả về value trực tiếp.
- Nếu hash của head node nhỏ hơn 0 thì cho biết đang mở rộng hoặc là red-black tree, tiến hành tìm kiếm.
- Nếu là linked list thì duyệt để tìm kiếm.
5. Đếm size
Method size() của ConcurrentHashMap dùng để lấy tổng số phần tử hiện tại trong Map. Tuy nhiên, trong môi trường concurrency cao, làm thế nào để thống kê số lượng phần tử vừa chính xác vừa hiệu quả là một vấn đề kỹ thuật khó. Java 8 sử dụng một cơ chế đếm phân tán tinh tế để giải quyết vấn đề này.
5.1 Tại sao cần đếm phân tán
Trong môi trường concurrency, nếu nhiều thread đồng thời thực hiện thao tác put, chúng đều cần update tổng số phần tử. Nếu sử dụng một biến counter dùng chung, cạnh tranh gay gắt sẽ xảy ra: tất cả thread đều tranh giành quyền sửa cùng một biến, làm performance giảm nghiêm trọng.
Để giải quyết vấn đề này, ConcurrentHashMap áp dụng tư tưởng thiết kế phân tán điểm nóng: không dùng một counter duy nhất mà phân tán việc đếm vào nhiều biến. Tương tự việc ngân hàng không chỉ mở một quầy giao dịch mà mở nhiều quầy để phân luồng khách hàng, cách này có thể giảm đáng kể collision.
5.2 Thiết kế của baseCount và counterCells
Bên trong ConcurrentHashMap duy trì hai field quan trọng liên quan đến việc đếm:
- baseCount: counter cơ sở; khi không có cạnh tranh, trực tiếp update biến này bằng CAS. Có thể hiểu đây là “counter chính”.
- counterCells: mảng counter. Khi nhiều thread update
baseCountthất bại, chúng sẽ thử phân tán increment vào các vị trí khác nhau trong mảngcounterCells.- Mỗi thread dùng giá trị Probe của mình (có thể hiểu là một hashcode được tạo từ thread ID) để ánh xạ đến một slot trong array, ưu tiên cộng dồn tại “ô ưu tiên” này.
- Lưu ý: Ô này không phải “private của thread” theo nghĩa nghiêm ngặt; khi xảy ra hash collision, nhiều thread vẫn có thể ánh xạ đến cùng một slot và update đồng thời.
Ví dụ: Giả sử có 10 thread đồng thời thêm phần tử vào Map. Thread đầu tiên update baseCount thành công bằng CAS, nhưng 9 thread sau phát hiện có cạnh tranh khi update baseCount nên chuyển sang tìm một vị trí trong mảng counterCells để cộng dồn. 9 thread này có thể được phân tán đến các vị trí khác nhau trong array (chẳng hạn thread 2 ở counterCells[1], thread 3 ở counterCells[2]), qua đó phân tán cạnh tranh từ một điểm thành nhiều điểm.
5.3 Cách update counter khi put phần tử
Ở cuối method putVal, ta thấy lời gọi method addCount(1L, binCount). Method này dùng để update counter phần tử.
Logic thực thi của addCount có thể tóm tắt như sau:
Ưu tiên update baseCount
- Nếu
counterCellschưa được bật (counterCells == null), thread trước tiên sẽ thử trực tiếp updatebaseCountbằng CAS. - Nếu CAS thành công, nghĩa là cạnh tranh không gay gắt, có thể return trực tiếp.
- Nếu
Chuyển sang counterCells khi xảy ra cạnh tranh
- Nếu update
baseCountbằng CAS thất bại (cho biết thread khác đang cạnh tranh), hoặccounterCellsđã tồn tại (cho biết hệ thống từng gặp cạnh tranh), thread sẽ thử update trongcounterCells:- Ánh xạ theo probe của mình đến một slot;
- Thực hiện một lần cộng dồn bằng CAS trên
CounterCelltương ứng với slot đó.
- Nếu slot này rỗng hoặc CAS vẫn xảy ra collision, sẽ đi vào path “nặng” hơn là
fullAddCount, bên trong chịu trách nhiệm khởi tạo slot và chọn lại slot.
- Nếu update
Khởi tạo và mở rộng counterCells động
- Khi phát hiện cạnh tranh khá gay gắt (ví dụ CAS của một cell thường xuyên thất bại),
fullAddCountsẽ được bảo vệ bởi spin lock nhẹcellsBusyđể:- Nếu
counterCellschưa được khởi tạo thì khởi tạo array nhỏ (chẳng hạn độ dài 2); - Nếu đã tồn tại nhưng chưa đạt giới hạn (thường không vượt quá số core CPU), mở rộng gấp đôi, thêm nhiều counter slot hơn để tiếp tục phân tán thread.
- Nếu
- Khi phát hiện cạnh tranh khá gay gắt (ví dụ CAS của một cell thường xuyên thất bại),
Thiết kế này bảo đảm: khi concurrency thấp, chỉ dùng baseCount đơn giản với path rất ngắn; khi concurrency cao, tự động chuyển sang đếm phân tán, giảm cạnh tranh thông qua counterCells và cơ chế mở rộng, đồng thời cân bằng performance và độ chính xác.
5.4 Cách sumCount tính tổng số phần tử
Khi gọi method size(), cuối cùng nó sẽ gọi method sumCount() để tính tổng số phần tử. Logic của sumCount() rất đơn giản:
- Đọc giá trị của
baseCountlàm giá trị cơ sở. - Duyệt mảng
counterCells, cộng giá trị counter của mọi vị trí khác null vào giá trị cơ sở. - Trả về kết quả cộng dồn.
Lưu ý:
- Weak consistency:
sumCount()không lock trong toàn bộ quá trình. Nếu thread khác insert dữ liệu trong lúc tính toán, kết quả trả về chỉ là giá trị gần đúng. Tuy nhiên, trong môi trường concurrency cao, việc theo đuổi “tổng số chính xác tại một thời điểm tức thì” có chi phí quá lớn và không có ý nghĩa; giá trị gần đúng thường đã đủ. - Integer overflow: Method
size()trả về kiểuint. Nếu số lượng phần tử vượt quáInteger.MAX_VALUE, nó chỉ trả vềInteger.MAX_VALUE. Java 8 bổ sung methodmappingCount()trả về kiểulong, phù hợp để biểu thị counter lớn hơn, nhưng trong lúc update concurrent, giá trị trả về vẫn là một ước tính.
3. Tổng kết
Trong Java 7, ConcurrentHashMap sử dụng segmented lock, nghĩa là tại mỗi Segment chỉ có một thread có thể thao tác tại một thời điểm. Mỗi Segment là một cấu trúc tương tự HashMap, có thể mở rộng và collision của nó sẽ chuyển thành linked list. Tuy nhiên, số lượng Segment không thể thay đổi sau khi khởi tạo.
Trong Java 8, ConcurrentHashMap sử dụng cơ chế lock synchronized kết hợp với CAS. Cấu trúc cũng tiến hoá từ mảng Segment + mảng HashEntry + linked list trong Java 7 thành mảng Node + linked list / red-black tree; Node là một cấu trúc tương tự HashEntry. Khi collision đạt đến kích thước nhất định, TREEIFY_THRESHOLD = 8 sẽ chuyển linked list thành red-black tree; khi collision nhỏ hơn số lượng nhất định, UNTREEIFY_THRESHOLD = 6 sẽ chuyển ngược lại thành linked list.
Một số bạn có thể nghi ngờ performance của lock synchronized. Thực tế, từ khi cơ chế lock upgrade được đưa vào, performance của lock synchronized không còn là vấn đề. Nếu quan tâm, bạn có thể tự tìm hiểu về lock upgrade của synchronized.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.