
Tổng hợp các câu hỏi thường gặp về Kafka
Kafka Basics
Kafka là gì? Các trường hợp sử dụng chính là gì?
Kafka là một nền tảng xử lý stream phân tán. Điều này thực sự có nghĩa là gì?
Nền tảng stream có ba chức năng chính:
- Message queue: publish và subscribe các stream message. Chức năng này tương tự message queue, cũng là lý do Kafka được xếp vào nhóm message queue.
- Lưu trữ message stream bền vững và có khả năng chịu lỗi: Kafka lưu message trên disk, giúp tránh hiệu quả rủi ro mất message.
- Nền tảng xử lý stream: xử lý message ngay khi publish; Kafka cung cấp một thư viện đầy đủ để xử lý stream.
Kafka chủ yếu có hai trường hợp sử dụng:
- Message queue: xây dựng data pipeline realtime để truyền dữ liệu đáng tin cậy giữa các system hoặc application.
- Xử lý dữ liệu: xây dựng các chương trình xử lý stream realtime để chuyển đổi hoặc xử lý data stream.
So với các message queue khác, Kafka có ưu thế gì?
Khi nhắc đến Kafka, chúng ta thường mặc định đây là một message queue rất tốt, đồng thời cũng thường so sánh Kafka với RocketMQ và RabbitMQ. Theo tôi, các ưu thế chính của Kafka so với những message queue khác như sau:
- Performance cực cao: được phát triển bằng Scala và Java, thiết kế sử dụng nhiều tư tưởng xử lý theo batch và bất đồng bộ, tối đa có thể xử lý hàng chục triệu message mỗi giây.
- Khả năng tương thích với ecosystem không đối thủ: Kafka có khả năng tương thích với ecosystem xung quanh tốt nhất, đặc biệt trong lĩnh vực big data và stream computing.
Thực tế, ở giai đoạn đầu Kafka chưa phải là một message queue đạt yêu cầu. Kafka thời kỳ đầu trong lĩnh vực message queue giống như một đứa trẻ rách rưới: chức năng chưa hoàn chỉnh và còn một số vấn đề nhỏ như mất message, không đảm bảo độ tin cậy của message, v.v. Điều này cũng liên quan nhiều đến việc LinkedIn ban đầu phát triển Kafka để xử lý lượng log khổng lồ. Nói vui một chút, ban đầu Kafka vốn không được tạo ra để làm message queue, ai ngờ sau đó lại vô tình chiếm được một vị trí trong lĩnh vực này.
Theo quá trình phát triển, những điểm yếu này dần được Kafka khắc phục và hoàn thiện. Vì vậy, nhận định Kafka không đáng tin cậy khi làm message queue đã lỗi thời!
Bạn có biết queue model không? Bạn có biết message model của Kafka không?
Ngoài lề: JMS và AMQP thời kỳ đầu là các tiêu chuẩn liên quan do những tổ chức có thẩm quyền trong lĩnh vực message service xây dựng. Tôi từng giới thiệu chúng trong bài "Message queue thực ra rất đơn giản" của JavaGuide. Tuy nhiên, tốc độ phát triển của các tiêu chuẩn này không theo kịp tốc độ tiến hóa của message queue, nên trên thực tế chúng đã ở trạng thái bị loại bỏ. Vì vậy, có thể xảy ra tình huống mỗi message queue có một message model riêng.
Queue model: message model thời kỳ đầu
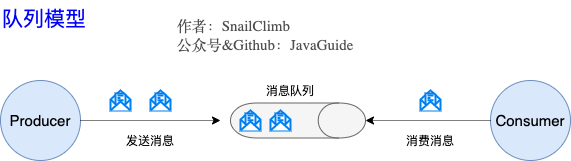
Dùng queue làm phương tiện giao tiếp message, đáp ứng mô hình producer và consumer. Một message chỉ có thể được một consumer sử dụng; message chưa được consume sẽ được giữ trong queue cho đến khi được consume hoặc hết hạn. Ví dụ: nếu producer gửi 100 message, trong điều kiện thông thường, hai consumer sẽ consume mỗi bên một nửa theo thứ tự message được gửi, tức là lần lượt mỗi bên một message.
Vấn đề của queue model:
Giả sử cần phân phối message do producer tạo ra cho nhiều consumer, đồng thời mỗi consumer đều nhận được toàn bộ nội dung message.
Queue model khó giải quyết tình huống này. Có người sẽ cố tranh luận rằng có thể tạo một queue riêng cho mỗi consumer rồi để producer gửi nhiều bản sao. Đây là cách làm rất ngớ ngẩn: chưa nói đến việc lãng phí tài nguyên, nó còn đi ngược mục đích sử dụng message queue.
Publish-subscribe model: message model của Kafka
Publish-subscribe model chủ yếu dùng để giải quyết vấn đề của queue model.
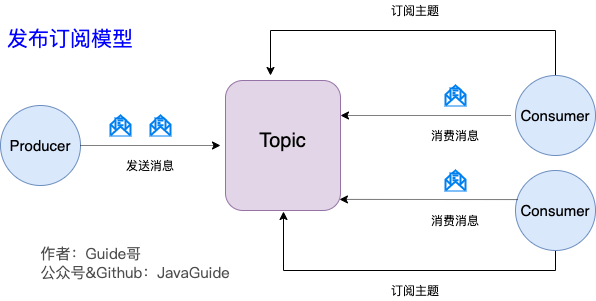
Publish-subscribe model (Pub-Sub) dùng topic làm phương tiện giao tiếp message, tương tự broadcast model; publisher publish một message, message đó được truyền qua topic đến tất cả subscriber. User subscribe sau khi một message đã được broadcast sẽ không nhận được message đó.
Trong publish-subscribe model, nếu chỉ có một subscriber thì về cơ bản nó giống queue model. Vì vậy, xét về chức năng, publish-subscribe model có thể tương thích với queue model.
Kafka sử dụng publish-subscribe model.
Message model của RocketMQ về cơ bản hoàn toàn giống Kafka. Điểm khác biệt duy nhất là Kafka không có khái niệm queue; khái niệm tương ứng là Partition.
Khái niệm cốt lõi của Kafka
Producer, Consumer, Broker, Topic, Partition là gì?
Kafka gửi message do producer publish vào Topic; consumer cần những message này có thể subscribe các Topic tương ứng, như hình dưới đây:
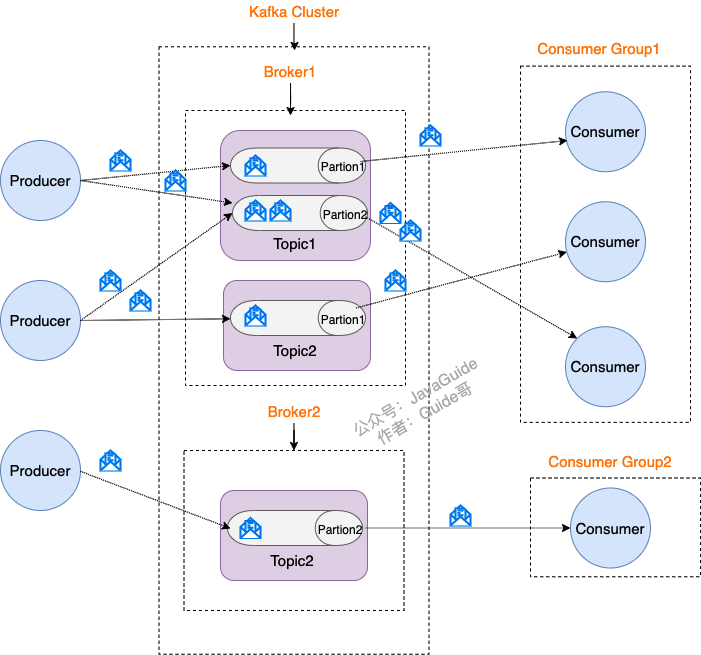
Hình trên giới thiệu một số khái niệm quan trọng của Kafka:
- Producer: bên tạo message.
- Consumer: bên consume message.
- Broker: có thể xem là một Kafka instance độc lập. Nhiều Kafka Broker tạo thành một Kafka Cluster.
Đồng thời, bạn cũng nhận thấy mỗi Broker còn chứa hai khái niệm quan trọng là Topic và Partition:
- Topic: Producer gửi message đến một topic cụ thể; Consumer consume message bằng cách subscribe Topic cụ thể.
- Partition: Partition là một phần của Topic. Một Topic có thể có nhiều Partition, các Partition trong cùng một Topic có thể phân bố trên các Broker khác nhau. Điều này có nghĩa một Topic có thể trải rộng trên nhiều Broker, đúng như hình minh họa ở trên.
Trọng tâm: Partition trong Kafka thực tế có thể tương ứng với queue trong message queue. Như vậy có dễ hiểu hơn không?
Bạn có biết cơ chế multi-replica của Kafka không? Cơ chế này đem lại lợi ích gì?
Một điểm quan trọng khác là Kafka đưa cơ chế multi-replica vào Partition. Trong số các replica của Partition có một replica gọi là leader, các replica khác gọi là follower. Message chúng ta gửi sẽ được gửi đến leader replica, sau đó follower replica mới pull message từ leader replica để đồng bộ.
Producer và consumer chỉ tương tác với leader replica. Bạn có thể hiểu các replica khác chỉ là bản sao của leader replica; chúng tồn tại để đảm bảo an toàn lưu trữ message. Khi leader replica gặp lỗi, một leader sẽ được bầu từ các follower, nhưng follower không đồng bộ đạt yêu cầu với leader sẽ không thể tham gia tranh cử leader.
Cơ chế multi-Partition và multi-replica của Kafka có lợi ích gì?
- Kafka chỉ định nhiều Partition cho một Topic cụ thể, các Partition có thể phân bố trên những Broker khác nhau, nhờ đó cung cấp khả năng concurrency tốt hơn (load balancing).
- Partition có thể chỉ định số Replica tương ứng. Điều này nâng cao đáng kể độ an toàn lưu trữ message và khả năng disaster recovery, nhưng đồng thời cũng làm tăng storage cần thiết.
ZooKeeper và Kafka
ZooKeeper có vai trò gì trong Kafka?
Muốn hiểu vai trò của zookeeper trong Kafka, bạn nhất định nên tự dựng một môi trường Kafka rồi vào zookeeper xem có những folder nào liên quan đến Kafka và mỗi node lưu thông tin gì. Đừng chỉ đọc mà không thực hành, nếu không kiến thức học được cũng sẽ bị quên! Phần này tham khảo và kế thừa từ bài viết: https://www.jianshu.com/p/a036405f989c.
Hình dưới đây là ZooKeeper trên máy local của tôi, đã liên kết thành công với Kafka local (cấu trúc folder dưới đây được tạo bằng plugin ZooKeeper tool của idea).
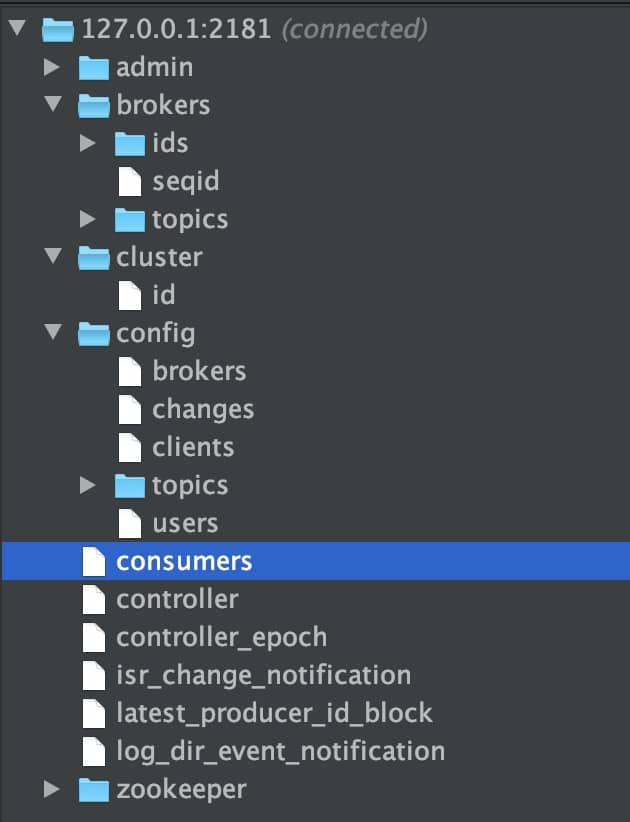
ZooKeeper chủ yếu cung cấp chức năng quản lý metadata cho Kafka.
Từ hình trên, có thể thấy ZooKeeper chủ yếu làm những việc sau cho Kafka:
- Đăng ký Broker: trên ZooKeeper có một node chuyên ghi lại danh sách Broker server. Mỗi Broker đều đăng ký trên ZooKeeper khi khởi động, tức tạo node của mình dưới
/brokers/ids. Mỗi Broker ghi IP, port và các thông tin khác của mình vào node đó. - Đăng ký Topic: trong Kafka, message của cùng một Topic được chia thành nhiều Partition và phân bố trên nhiều Broker; thông tin Partition cùng quan hệ tương ứng với Broker cũng do ZooKeeper duy trì. Ví dụ, nếu tạo topic tên my-topic có hai Partition, ZooKeeper sẽ tạo các folder:
/brokers/topics/my-topic/Partitions/0,/brokers/topics/my-topic/Partitions/1. - Load balancing: như đã nói ở trên, Kafka chỉ định nhiều Partition cho một Topic cụ thể, các Partition có thể phân bố trên những Broker khác nhau, nhờ đó cung cấp khả năng concurrency tốt hơn. Với các Partition khác nhau của cùng một Topic, Kafka cố gắng phân bố chúng trên các Broker server khác nhau. Khi producer tạo message, Kafka cũng cố gắng gửi chúng đến Partition trên các Broker khác nhau. Khi Consumer consume, ZooKeeper có thể thực hiện load balancing động dựa trên số Partition và số Consumer hiện tại.
- ……
Có thể sử dụng Kafka mà không đưa ZooKeeper vào không?
Trước Kafka 2.8, điều bị phàn nàn nhiều nhất về Kafka là phụ thuộc quá nặng vào ZooKeeper. Kafka 2.8 giới thiệu mode KRaft dựa trên giao thức Raft, nhưng lúc đó vẫn là Early Access; từ Kafka 3.3.x, KRaft dành cho cluster mới được đánh dấu là sẵn sàng cho production; từ Kafka 4.0, mode ZooKeeper đã bị loại bỏ và Kafka chỉ hỗ trợ mode KRaft.
Tuy nhiên, cần lưu ý: việc migrate cluster cũ từ mode ZooKeeper sang mode KRaft phải thực hiện theo quy trình migrate chính thức, không thể chỉ sửa config rồi restart. Với cluster mới, nên ưu tiên deploy theo mode hiện được tài liệu chính thức khuyến nghị.

Thứ tự consume, mất message và consume trùng trong Kafka
Kafka đảm bảo thứ tự consume message như thế nào?
Trong quá trình sử dụng message queue, nhiều business scenario cần đảm bảo nghiêm ngặt thứ tự consume message. Ví dụ, gửi đồng thời hai message, hai message tương ứng với các thao tác database sau:
- Thay đổi cấp độ thành viên của user.
- Tính giá order dựa trên cấp độ thành viên.
Nếu thứ tự consume hai message này khác nhau, kết quả cuối cùng có thể hoàn toàn khác.
Chúng ta biết Partition trong Kafka là nơi thực sự lưu message. Các message gửi đi đều được đặt ở đây. Partition lại thuộc khái niệm Topic, và một Topic cụ thể có thể được chỉ định nhiều Partition.
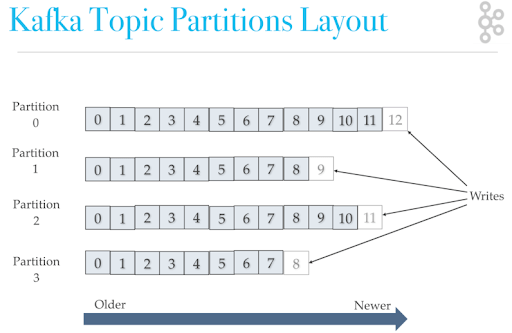
Mỗi lần thêm message vào Partition đều dùng cách thêm vào cuối như hình trên. Kafka chỉ đảm bảo message có thứ tự trong một Partition.
Khi được append vào Partition, mỗi message sẽ được gán một offset cụ thể. Kafka dùng offset để đảm bảo thứ tự message trong Partition.
Vì vậy, có một cách rất đơn giản để đảm bảo thứ tự consume message: một Topic chỉ tương ứng với một Partition. Cách này tất nhiên giải quyết được vấn đề, nhưng lại phá vỡ ý đồ thiết kế của Kafka.
Khi gửi một message trong Kafka, có thể chỉ định bốn tham số topic, partition, key, data. Nếu chỉ định Partition khi gửi message, tất cả message sẽ được gửi đến Partition đó. Ngoài ra, message có cùng key có thể đảm bảo chỉ được gửi đến cùng một partition; có thể dùng id của table/object làm key.
Tóm lại, để đảm bảo thứ tự consume message trong Kafka, có hai cách:
- Một Topic chỉ tương ứng với một Partition.
- (Khuyến nghị) Chỉ định key/Partition khi gửi message.
Tất nhiên không chỉ có hai cách trên; đây là hai cách dễ hiểu hơn theo tôi.
Consume theo thứ tự còn cần chú ý hai giới hạn:
- Chỉ đảm bảo có thứ tự trong cùng một Partition: nhiều Partition vốn xử lý song song, không đảm bảo thứ tự toàn cục.
- Retry khi lỗi có thể làm sai lệch hiệu quả business: nếu một message xử lý thất bại nhưng message sau đã được xử lý, tầng business vẫn cần state machine hoặc version để làm cơ chế bảo vệ.
Vì vậy, trong production thường kết hợp “cùng business key vào cùng một Partition + consume tuần tự trong một Partition + idempotent/state machine validation ở consumer”.
Kafka đảm bảo message không bị mất như thế nào?
Trường hợp producer làm mất message
Sau khi Producer gọi method send để gửi message, message có thể chưa được gửi đi do vấn đề network.
Vì vậy, không thể mặc định rằng message đã gửi thành công sau khi gọi method send. Để xác định việc gửi thành công, cần kiểm tra kết quả gửi. Tuy nhiên, cần lưu ý method send của Kafka Producer thực tế là thao tác bất đồng bộ. Có thể dùng method get() để lấy kết quả, nhưng như vậy thao tác sẽ trở thành đồng bộ. Ví dụ:
Xem code chi tiết trong bài viết: Series Kafka, phần 3! Học cách sử dụng Kafka làm message queue trong chương trình Spring Boot trong 10 phút
SendResult<String, Object> sendResult = kafkaTemplate.send(topic, o).get();
if (sendResult.getRecordMetadata() != null) {
  logger.info("Producer gửi message thành công tới " + sendResult.getProducerRecord().topic() + "-> " + sendResult.getProducerRecord().value().toString());
}
Tuy nhiên, thông thường không khuyến nghị làm vậy! Có thể thêm callback, ví dụ:
        ListenableFuture<SendResult<String, Object>> future = kafkaTemplate.send(topic, o);
        future.addCallback(result -> logger.info("Producer gửi thành công message của topic:{} partition:{}", result.getRecordMetadata().topic(), result.getRecordMetadata().partition()),
                ex -> logger.error("Producer gửi message thất bại, nguyên nhân: {}", ex.getMessage()));
Nếu gửi message thất bại, chỉ cần kiểm tra nguyên nhân rồi gửi lại!
Ngoài ra, khuyến nghị đặt giá trị hợp lý cho retries (số lần retry) của Producer, thường là 3, nhưng để đảm bảo không mất message thì thường đặt lớn hơn. Sau khi cấu hình, khi xảy ra vấn đề network, message sẽ tự động được retry để tránh mất message. Ngoài ra nên cấu hình khoảng thời gian giữa các lần retry; nếu khoảng thời gian quá ngắn thì hiệu quả retry không rõ ràng, một lần network chập chờn có thể khiến cả 3 lần retry kết thúc ngay.
Trường hợp consumer làm mất message
Chúng ta biết mỗi message khi được append vào Partition sẽ được gán một offset cụ thể. Offset biểu thị vị trí hiện tại mà Consumer đã consume trong Partition. Kafka dùng offset để đảm bảo thứ tự message trong Partition.
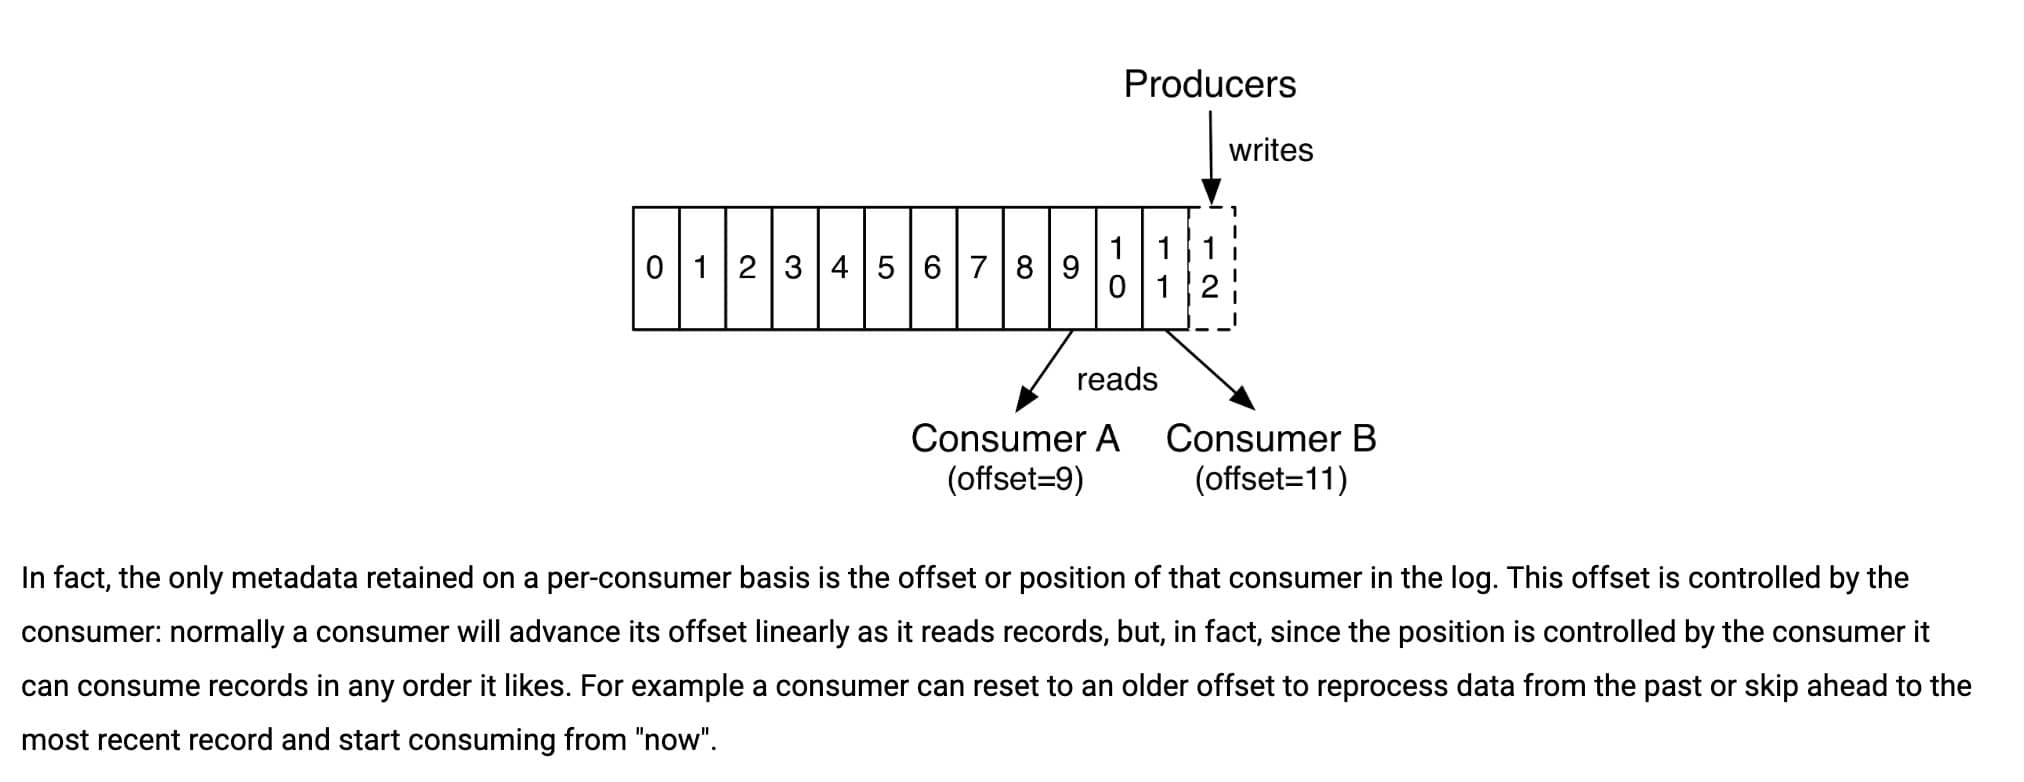
Sau khi pull được một message nào đó trong Partition, consumer sẽ tự động commit offset. Auto commit có một vấn đề: giả sử consumer vừa nhận message và chuẩn bị consume thực sự thì đột nhiên bị dừng; message thực tế chưa được consume nhưng offset đã được auto commit.
Cách giải quyết khá trực tiếp: tắt auto commit offset và tự commit offset sau khi thực sự consume xong message. Tuy nhiên, cách này có thể khiến message bị consume lại. Ví dụ, vừa consume xong message nhưng chưa commit offset thì bị dừng; về lý thuyết message đó sẽ bị consume hai lần.
Kafka làm mất message
Chúng ta biết Kafka đưa cơ chế multi-replica vào Partition. Trong số các replica của Partition có một replica gọi là leader, các replica khác gọi là follower. Message chúng ta gửi sẽ được gửi đến leader replica, sau đó follower replica mới pull message từ leader replica để đồng bộ. Producer và consumer chỉ tương tác với leader replica. Bạn có thể hiểu các replica khác chỉ là bản sao của leader replica; chúng tồn tại để đảm bảo an toàn lưu trữ message.
Hãy thử xét tình huống: nếu broker chứa leader replica đột nhiên dừng, một leader mới phải được bầu từ follower replica. Nhưng nếu một phần data của leader chưa được follower replica đồng bộ, message sẽ bị mất.
Đặt acks = all
Cách giải quyết là đặt acks = all. acks là một parameter rất quan trọng của Kafka Producer.
Giá trị mặc định của acks là 1, nghĩa là message được xem là gửi thành công sau khi leader replica nhận được. Khi cấu hình acks = all, chỉ khi tất cả replica trong danh sách ISR nhận được message thì Producer mới nhận response từ server. Đây là mode an toàn nhất, có thể đảm bảo nhiều hơn một Broker đã nhận message. Độ trễ của mode này sẽ cao.
Đặt replication.factor >= 3
Để đảm bảo leader replica có follower replica đồng bộ message, thường đặt replication.factor >= 3 cho topic. Như vậy mỗi Partition có ít nhất 3 replica. Cách này tạo ra data redundancy nhưng tăng độ an toàn của data.
Đặt min.insync.replicas > 1
Thông thường cũng cần đặt min.insync.replicas > 1, nghĩa là message phải được ghi vào ít nhất 2 replica mới được xem là gửi thành công. Giá trị mặc định của min.insync.replicas là 1; trong production nên tránh giá trị mặc định 1.
Tuy nhiên, để đảm bảo high availability cho toàn bộ Kafka service, cần đảm bảo replication.factor > min.insync.replicas. Vì sao? Nếu hai giá trị bằng nhau, chỉ cần một replica dừng là toàn bộ Partition không thể hoạt động bình thường. Điều này rõ ràng vi phạm high availability! Thông thường nên đặt replication.factor = min.insync.replicas + 1.
Đặt unclean.leader.election.enable = false
Từ Kafka 0.11.0.0, giá trị mặc định của parameter
unclean.leader.election.enableđã đổi từ true thành false.
Như đã nói, message gửi đi sẽ được gửi đến leader replica, sau đó follower replica mới pull message từ leader replica để đồng bộ. Mức độ đồng bộ message giữa các follower replica khác nhau. Khi cấu hình unclean.leader.election.enable = false, nếu leader replica gặp lỗi, hệ thống sẽ không chọn follower replica có mức độ đồng bộ chưa đạt yêu cầu với leader làm leader mới, nhờ đó giảm khả năng mất message.
Trong production cũng nên đồng thời chú ý các config ở phía producer:
- Bật idempotent producer để tránh producer retry dẫn đến ghi trùng vào cùng một Partition.
- Cấu hình hợp lý
delivery.timeout.ms,request.timeout.msvàlinger.ms, cân bằng giữa reliability, latency và throughput. - Với message business quan trọng, ghi lại log gửi thất bại hoặc local message table để thuận tiện bù trừ sau này.
Reliability của Kafka không do một parameter duy nhất quyết định, mà do Topic replica, ISR, Producer ACK, thời điểm Consumer commit offset và business idempotent cùng quyết định.
Kafka đảm bảo message không bị consume trùng như thế nào?
Nguyên nhân Kafka xuất hiện consume trùng message:
- Data đã được consume ở phía service nhưng chưa commit offset thành công (nguyên nhân cốt lõi).
- Ở phía Kafka, do service xử lý business quá lâu hoặc network connection, Kafka cho rằng service đã chết giả và trigger partition rebalance.
Giải pháp:
- Service consume message thực hiện idempotent validation, chẳng hạn dùng
setcủa Redis, primary key của MySQL và các chức năng idempotent tự nhiên khác. Đây là cách hiệu quả nhất. - Đặt parameter
enable.auto.committhành false để tắt auto commit, developer tự commit offset trong code. Khi đó có một vấn đề: thời điểm nào commit offset là phù hợp?- Commit sau khi xử lý xong message: vẫn có rủi ro consume trùng message, giống auto commit.
- Commit ngay khi pull được message: có rủi ro mất message. Với scenario cho phép message bị trễ, thường dùng cách này. Sau đó dùng scheduled task để bổ sung kiểm tra data khi business không bận, chẳng hạn lúc nửa đêm.
Rebalance có rủi ro gì? Làm thế nào để giảm ảnh hưởng?
Consumer Group thay đổi số lượng consumer, thay đổi Topic được subscribe hoặc consumer không gửi heartbeat trong thời gian dài đều có thể trigger Rebalance. Trong thời gian Rebalance, Partition được phân bổ lại, một số consumer sẽ tạm dừng consume; trường hợp nghiêm trọng có thể gây dao động consume và consume trùng.
Các hướng tối ưu thường gặp:
- Kiểm soát việc instance consumer thường xuyên online/offline; khi release nên rolling và chia thành nhiều batch.
- Cấu hình hợp lý
max.poll.interval.ms, tránh một batch message xử lý quá lâu khiến consumer bị loại khỏi group. - Kiểm soát số lượng pull mỗi lần, tránh pull quá nhiều khiến thời gian xử lý vượt quá khoảng heartbeat hoặc poll.
- Dùng static member hoặc strategy phân bổ Partition mượt hơn để giảm việc migrate Partition không cần thiết.
- Consumer bắt buộc phải idempotent, vì trước và sau Rebalance vẫn có thể xảy ra trùng giữa commit offset và xử lý business.
Nếu được hỏi về Rebalance trong phỏng vấn, đừng chỉ nói “consumer phân bổ lại Partition”. Quan trọng hơn là phải nói rõ nó gây pause ngắn, có rủi ro consume trùng, và cách giảm ảnh hưởng thông qua parameter, strategy release và thiết kế idempotent.
Cơ chế retry của Kafka
Trong phần Kafka đảm bảo message không bị mất, chúng ta đã đề cập đến cơ chế retry của Kafka. Vì phần này khá quan trọng nên sẽ giới thiệu chi tiết hơn.
Trên Internet có nhiều bài viết về cơ chế retry mặc định của Spring Kafka, nhưng phần lớn đã lỗi thời và hoàn toàn khác với kết quả chạy thực tế. Nội dung dưới đây được hệ thống lại từ source code của spring-kafka-2.9.3.
Consume thất bại sẽ thế nào?
Trong quá trình consume, khi một message xảy ra exception, việc consume các message sau có bị kẹt không? Nếu vậy business chẳng phải sẽ bị kẹt sao?
Code producer:
 for (int i = 0; i < 10; i++) {
   kafkaTemplate.send(KafkaConst.TEST_TOPIC, String.valueOf(i))
 }
Code consumer:
   @KafkaListener(topics = {KafkaConst.TEST_TOPIC},groupId = "apple")
   private void customer(String message) throws InterruptedException {
       log.info("kafka customer:{}",message);
       Integer n = Integer.parseInt(message);
       if (n%5==0){
           throw new  RuntimeException();
       }
   }
Trong config mặc định, khi consume xảy ra exception, hệ thống sẽ retry; sau nhiều lần retry sẽ bỏ qua message hiện tại và tiếp tục consume các message sau, không bị kẹt mãi ở message hiện tại. Dưới đây là một đoạn log consume, có thể thấy sau nhiều lần retry, test-0@95 bị bỏ qua.
2023-08-10 12:03:32.918 DEBUG 9700 --- [ntainer#0-0-C-1] o.s.kafka.listener.DefaultErrorHandler   : Skipping seek of: test-0@95
2023-08-10 12:03:32.918 TRACE 9700 --- [ntainer#0-0-C-1] o.s.kafka.listener.DefaultErrorHandler   : Seeking: test-0 to: 96
2023-08-10 12:03:32.918  INFO 9700 --- [ntainer#0-0-C-1] o.a.k.clients.consumer.KafkaConsumer     : [Consumer clientId=consumer-apple-1, groupId=apple] Seeking to offset 96 for partition test-0
Do đó, ngay cả khi một message consume bị exception, Kafka consumer vẫn có thể tiếp tục consume các message sau, không bị kẹt mãi ở message hiện tại và đảm bảo business hoạt động bình thường.
Mặc định retry bao nhiêu lần?
Với config mặc định, consume exception sẽ được retry. Số lần retry là bao nhiêu, có khoảng thời gian giữa các lần retry không?
Trong source code, class FailedRecordTracker có function recovered trả về giá trị Boolean để quyết định có retry hay không. Logic quyết định retry trong function này như sau:
\t@Override
\tpublic boolean recovered(ConsumerRecord<?, ?> record, Exception exception,
\t    @Nullable MessageListenerContainer container,
\t    @Nullable Consumer<?, ?> consumer) throws InterruptedException {

\t    if (this.noRetries) {
         // Không hỗ trợ retry
\t        attemptRecovery(record, exception, null, consumer);
\t        return true;
\t    }
      // Lấy collection các record consume đã thất bại
\t    Map < TopicPartition, FailedRecord > map = this.failures.get();
\t    if (map == null) {
\t        this.failures.set(new HashMap < > ());
\t        map = this.failures.get();
\t    }
      // Lấy Topic và Partition chứa record consume
\t    TopicPartition topicPartition = new TopicPartition(record.topic(), record.partition());
\t    FailedRecord failedRecord = getFailedRecordInstance(record, exception, map, topicPartition);
      // Thông báo cho retry listener đã đăng ký rằng message delivery thất bại
\t    this.retryListeners.forEach(rl - >
\t        rl.failedDelivery(record, exception, failedRecord.getDeliveryAttempts().get()));
\t    // Lấy khoảng thời gian trước lần retry tiếp theo
     long nextBackOff = failedRecord.getBackOffExecution().nextBackOff();
\t    if (nextBackOff != BackOffExecution.STOP) {
\t        this.backOffHandler.onNextBackOff(container, exception, nextBackOff);
\t        return false;
\t    } else {
\t        attemptRecovery(record, exception, topicPartition, consumer);
\t        map.remove(topicPartition);
\t        if (map.isEmpty()) {
\t            this.failures.remove();
\t        }
\t        return true;
\t    }
\t}
Trong đó, giá trị của BackOffExecution.STOP là -1.
@FunctionalInterface
public interface BackOffExecution {

\tlong STOP = -1;
\tlong nextBackOff();

}
Giá trị của nextBackOff được lấy bằng cách gọi function nextBackOff() của class BackOff. Nếu số lần thực thi hiện tại lớn hơn số lần thực thi tối đa thì trả về STOP; chỉ sau khi vượt quá số lần thực thi tối đa mới dừng retry.
public long nextBackOff() {
  this.currentAttempts++;
  if (this.currentAttempts <= getMaxAttempts()) {
    return getInterval();
  }
  else {
    return STOP;
  }
}
Vậy giá trị getMaxAttempts là bao nhiêu? Quay lại từ đầu, khi thực thi xảy ra lỗi, flow sẽ đi vào DefaultErrorHandler. Constructor mặc định của DefaultErrorHandler là:
public DefaultErrorHandler() {
  this(null, SeekUtils.DEFAULT_BACK_OFF);
}
SeekUtils.DEFAULT_BACK_OFF được định nghĩa như sau:
public static final int DEFAULT_MAX_FAILURES = 10;

public static final FixedBackOff DEFAULT_BACK_OFF = new FixedBackOff(0, DEFAULT_MAX_FAILURES - 1);
Giá trị DEFAULT_MAX_FAILURES là 10, currentAttempts chạy từ 0 đến 9, nên tổng cộng thực thi 10 lần; khoảng thời gian giữa mỗi lần retry là 0.
Tóm tắt: với config mặc định, Kafka consumer retry tối đa 10 lần, khoảng thời gian giữa mỗi lần retry là 0, tức retry ngay lập tức. Nếu sau 10 lần retry vẫn không thể consume message thành công thì không retry nữa và message được xem là consume thất bại.
Tùy chỉnh số lần retry và khoảng thời gian như thế nào?
Từ code trên có thể thấy số lần retry và khoảng thời gian của error handler mặc định do FixedBackOff kiểm soát; FixedBackOff được dùng khi DefaultErrorHandler khởi tạo. Vì vậy, để tùy chỉnh số lần retry và khoảng thời gian, chỉ cần truyền FixedBackOff tùy chỉnh khi khởi tạo DefaultErrorHandler. Có thể tạo lại một KafkaListenerContainerFactory, gọi setCommonErrorHandler để đặt error handler tùy chỉnh mới.
@Bean
public KafkaListenerContainerFactory kafkaListenerContainerFactory(ConsumerFactory<String, String> consumerFactory) {
    ConcurrentKafkaListenerContainerFactory factory = new ConcurrentKafkaListenerContainerFactory();
    // Tùy chỉnh khoảng thời gian và số lần retry
    FixedBackOff fixedBackOff = new FixedBackOff(1000, 5);
    factory.setCommonErrorHandler(new DefaultErrorHandler(fixedBackOff));
    factory.setConsumerFactory(consumerFactory);
    return factory;
}
Cảnh báo sau khi retry thất bại như thế nào?
Logic sau khi retry thất bại cần tự triển khai. Dưới đây là một ví dụ đơn giản: override function handleRemaining của DefaultErrorHandler và thêm các thao tác như cảnh báo tùy chỉnh.
@Slf4j
public class DelErrorHandler extends DefaultErrorHandler {

    public DelErrorHandler(FixedBackOff backOff) {
        super(null,backOff);
    }

    @Override
    public void handleRemaining(Exception thrownException, List<ConsumerRecord<?, ?>> records, Consumer<?, ?> consumer, MessageListenerContainer container) {
        super.handleRemaining(thrownException, records, consumer, container);
        log.info("Retry nhiều lần vẫn thất bại");
        // Thao tác tùy chỉnh
    }
}
DefaultErrorHandler chỉ là một error handler mặc định. Spring Kafka còn cung cấp interface CommonErrorHandler. Tự triển khai CommonErrorHandler có thể thực hiện nhiều thao tác tùy chỉnh hơn, với độ linh hoạt cao. Ví dụ, có thể triển khai retry logic và business logic khác nhau theo từng loại lỗi.
Xử lý lại data sau khi retry thất bại như thế nào?
Khi đạt số lần retry tối đa, data sẽ bị bỏ qua trực tiếp và tiếp tục xử lý các message sau. Sau khi sửa code, làm thế nào để consume lại những data retry thất bại này?
Dead Letter Queue (viết tắt là DLQ) là một queue đặc biệt trong middleware message. Nó chủ yếu dùng để xử lý các message không thể được consumer xử lý chính xác, thường do message sai format, xử lý thất bại, consume timeout hoặc các nguyên nhân khiến message bị “bỏ” hay “chết”. Sau khi message vào queue, consumer sẽ thử xử lý. Nếu xử lý thất bại hoặc vẫn không thể xử lý thành công sau một số lần retry nhất định, message có thể được gửi đến dead letter queue thay vì bị bỏ vĩnh viễn. Trong dead letter queue, có thể tiếp tục phân tích và xử lý các message không thể consume bình thường để định vị vấn đề, sửa lỗi và áp dụng biện pháp phù hợp.
@RetryableTopic là một annotation trong Spring Kafka, dùng để config một Topic hỗ trợ retry message. Khuyến nghị dùng annotation này để hoàn thành việc retry.
// Retry 5 lần, khoảng thời gian retry 100 milliseconds, khoảng thời gian tối đa 1 giây
@RetryableTopic(
        attempts = "5",
        backoff = @Backoff(delay = 100, maxDelay = 1000)
)
@KafkaListener(topics = {KafkaConst.TEST_TOPIC}, groupId = "apple")
private void customer(String message) {
    log.info("kafka customer:{}", message);
    Integer n = Integer.parseInt(message);
    if (n % 5 == 0) {
        throw new RuntimeException();
    }
    System.out.println(n);
}
Khi đạt số lần retry tối đa mà vẫn không thể xử lý message thành công, message sẽ được gửi đến dead letter queue tương ứng. Có thể xử lý dead letter queue bằng @DltHandler, hoặc dùng @KafkaListener để consume lại.
Tài liệu tham khảo
- Tài liệu chính thức Kafka: https://kafka.apache.org/documentation/
- Geektime — 《Công nghệ cốt lõi và thực chiến Kafka》 phần 11: Làm thế nào để cấu hình không mất message?
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.