
Tổng hợp các câu hỏi thường gặp về Disruptor
Disruptor là một chủ đề tương đối ít phổ biến. Tuy nhiên, nếu dự án của bạn có sử dụng Disruptor thì bạn rất có thể sẽ được hỏi về nó trong phỏng vấn.
Một bài chia sẻ kinh nghiệm phỏng vấn trước đây của một độc giả cũng có đề cập đến một số câu hỏi về Disruptor: Mơ ước thành hiện thực! Thuận lợi nhận offer từ ByteDance, Taobao, Pinduoduo và các công ty lớn khác! .

Bài viết này có thể xem là phần tổng hợp ngắn gọn về Disruptor. Mỗi câu hỏi sẽ không đi quá sâu, chủ yếu phục vụ phỏng vấn hoặc xem nhanh về Disruptor.
Disruptor là gì?
Disruptor là một memory queue hiệu năng cao mã nguồn mở. Nó ra đời nhằm giải quyết các vấn đề về performance và memory safety của memory queue, do công ty giao dịch ngoại hối LMAX của Anh phát triển.
Theo giới thiệu chính thức của Disruptor, hệ thống LMAX được phát triển dựa trên Disruptor (nền tảng giao dịch tài chính bán lẻ mới) có thể xử lý 6 triệu đơn hàng mỗi giây chỉ với một thread. Martin Fowler đã giới thiệu riêng kiến trúc của hệ thống LMAX trong bài viết The LMAX Architecture năm 2011. Bạn có thể xem nếu quan tâm.
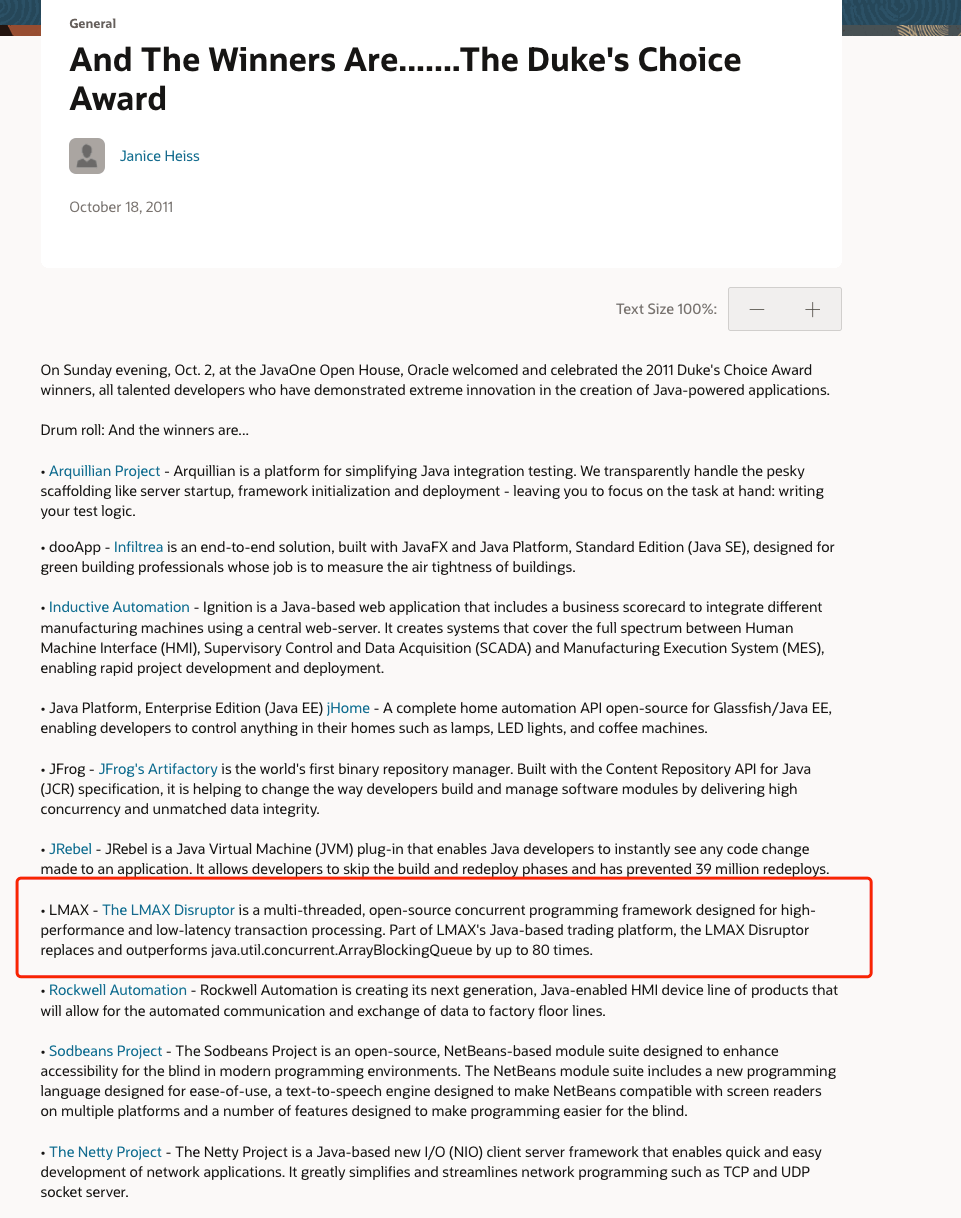
Sau bài thuyết trình tại QCon năm 2010, Disruptor của LMAX được ngành chú ý và giành Duke's Choice Awards của Oracle năm 2011.

“Duke's Choice Awards” nhằm vinh danh các ứng dụng công nghệ Java có ảnh hưởng nhất do cá nhân hoặc công ty trên toàn thế giới phát triển trong năm trước, do Oracle tổ chức. Đây là một giải thưởng rất danh giá!
Tôi đã tìm được bài viết chính thức của Oracle về các dự án nhận Duke's Choice Awards năm đó (địa chỉ bài viết: https://blogs.oracle.com/java/post/and-the-winners-arethe-dukes-choice-award). Qua bài viết có thể thấy những dự án nổi tiếng như Netty và JRebel cũng nhận được giải thưởng này trong cùng năm.
Các chức năng Disruptor cung cấp tương tự những distributed queue như Kafka và RocketMQ, nhưng phạm vi hoạt động của nó là trong JVM (memory).
- Địa chỉ Github: https://github.com/LMAX-Exchange/disruptor
- Tài liệu chính thức: https://lmax-exchange.github.io/disruptor/user-guide/index.html
Để biết cách sử dụng Disruptor trong dự án Spring Boot, bạn có thể xem bài viết này: Nhập môn thực chiến Spring Boot + Disruptor .
Vì sao nên dùng Disruptor?
Disruptor chủ yếu giải quyết các vấn đề về performance và memory safety của các thread-safe queue tích hợp trong JDK.
Các thread-safe queue thường gặp trong JDK:
| Tên queue | Lock | Có bounded không |
|---|---|---|
ArrayBlockingQueue | Có lock (ReentrantLock) | Có |
LinkedBlockingQueue | Có lock (ReentrantLock) | Có |
LinkedTransferQueue | Lock-free (CAS) | Không |
ConcurrentLinkedQueue | Lock-free (CAS) | Không |
Có thể thấy từ bảng trên: các queue này hoặc có lock và bounded, hoặc lock-free và unbounded. Queue có lock chắc chắn ảnh hưởng đến performance, còn queue unbounded có nguy cơ gây out-of-memory.
Vì vậy, trong trường hợp thông thường, chúng ta không khuyến nghị sử dụng thread-safe queue tích hợp trong JDK.
Disruptor thì khác! Nó vẫn bảo đảm queue bounded và thread-safe trong khi không dùng lock.
Hình dưới đây là biểu đồ histogram latency so sánh Disruptor và ArrayBlockingQueue do website chính thức của Disruptor cung cấp.
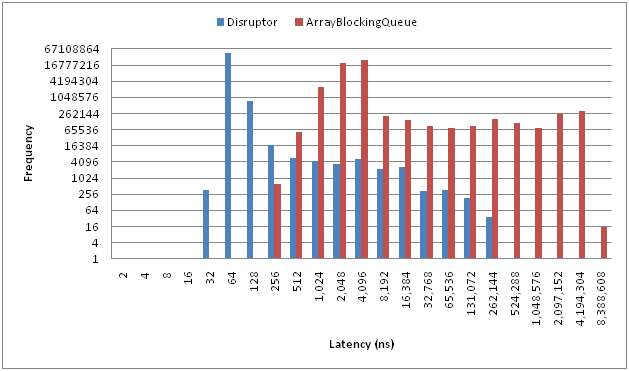
Disruptor thực sự rất nhanh. Phần sau sẽ giải thích vì sao nó nhanh như vậy.
Ngoài ra, Disruptor còn cung cấp nhiều tính năng mở rộng, chẳng hạn hỗ trợ batch operation và nhiều waiting strategy.
Kafka và Disruptor khác nhau thế nào?
- Kafka: distributed message queue, thường dùng để truyền message giữa các hệ thống hoặc service, đồng thời cũng có thể dùng làm stream processing platform.
- Disruptor: message queue ở cấp memory, thường dùng để truyền message giữa các thread bên trong một hệ thống.
Chúng giải quyết các vấn đề ở những cấp độ khác nhau:
| Khía cạnh so sánh | Kafka/RocketMQ/RabbitMQ | Disruptor |
|---|---|---|
| Phạm vi sử dụng | Giữa process, machine và service | Trong một process JVM |
| Có persistence không | Thường hỗ trợ | Không phụ trách persistence |
| Có replay không | Thường hỗ trợ | Không phụ trách replay lịch sử |
| Năng lực trọng tâm | Reliable delivery, peak shaving, decoupling, consumer group | Low latency, ít lock contention, xử lý event throughput cao |
| Trường hợp điển hình | Event đơn hàng, thu thập log, async decoupling | Async log, matching, pipeline trong process |
Vì vậy, Disruptor không thể thay thế các distributed message queue như Kafka và RocketMQ. Nó phù hợp hơn khi đặt bên trong service để tăng tốc một pipeline xử lý event có tần suất cao.
Những component nào sử dụng Disruptor?
Có khá nhiều open-source project sử dụng Disruptor. Dưới đây là một vài ví dụ:
- Log4j2: Log4j2 là một logging framework phổ biến, sử dụng Disruptor để triển khai async log.
- SOFATracer: SOFATracer là công cụ distributed application tracing do Ant Financial phát hành mã nguồn mở, sử dụng Disruptor để triển khai async log.
- Storm: Storm là một distributed real-time computing system mã nguồn mở, sử dụng Disruptor để truyền message trong worker process (giữa các thread trên cùng một node Storm, không cần network communication).
- HBase: HBase là một distributed column-store database system, sử dụng Disruptor để cải thiện write concurrency performance.
- …
Các khái niệm cốt lõi của Disruptor là gì?
- Event: Có thể hiểu Event là message object được lưu trong queue để chờ consumer xử lý.
- EventFactory: Event factory dùng để tạo event, cần dùng khi khởi tạo class
Disruptor. - EventHandler: Event được xử lý trong Handler tương ứng. Có thể hiểu đây là consumer trong mô hình producer-consumer.
- EventProcessor: EventProcessor giữ Sequence của một consumer cụ thể và cung cấp event loop để gọi phần triển khai xử lý event.
- Disruptor: Việc tạo và tiêu thụ event cần dùng object
Disruptor. - RingBuffer: RingBuffer (array dạng vòng) dùng để lưu event.
- WaitStrategy: Waiting strategy. Quyết định cách event consumer chờ event mới khi không có event để consume.
- Producer: Producer chỉ là tên gọi chung cho user code gọi object
Disruptorđể publish event. Disruptor không định nghĩa interface hoặc type cụ thể. - ProducerType: Chỉ định mô hình một publisher hoặc nhiều publisher (publisher và producer có nghĩa tương tự nhau; cá nhân tôi thích dùng publisher hơn).
- Sequencer: Sequencer là core thực sự của Disruptor. Interface này có hai implementation là
SingleProducerSequencervàMultiProducerSequencer, định nghĩa concurrency algorithm để truyền data nhanh và chính xác giữa producer và consumer.
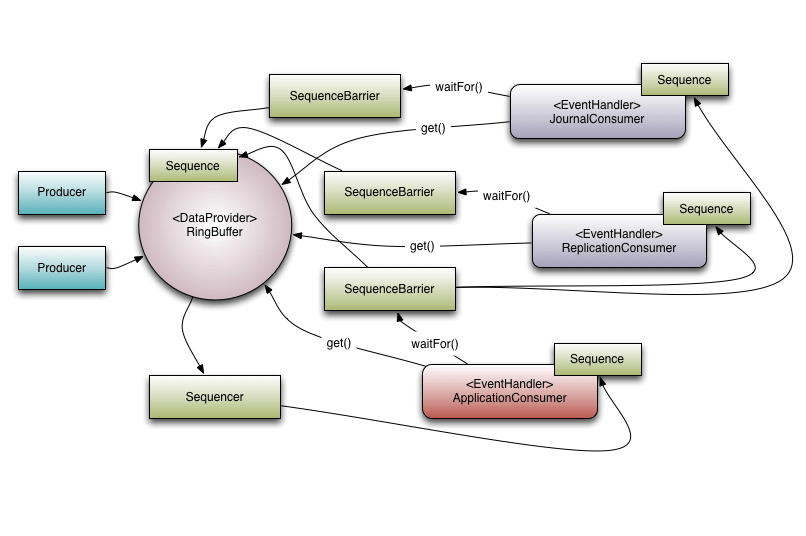
Hình dưới đây được trích từ website chính thức của Disruptor, minh họa ví dụ hệ thống LMAX sử dụng Disruptor.
Disruptor có những waiting strategy nào?
Waiting strategy (WaitStrategy) quyết định cách event consumer chờ event mới khi không có event để consume.
Các waiting strategy thường gặp:
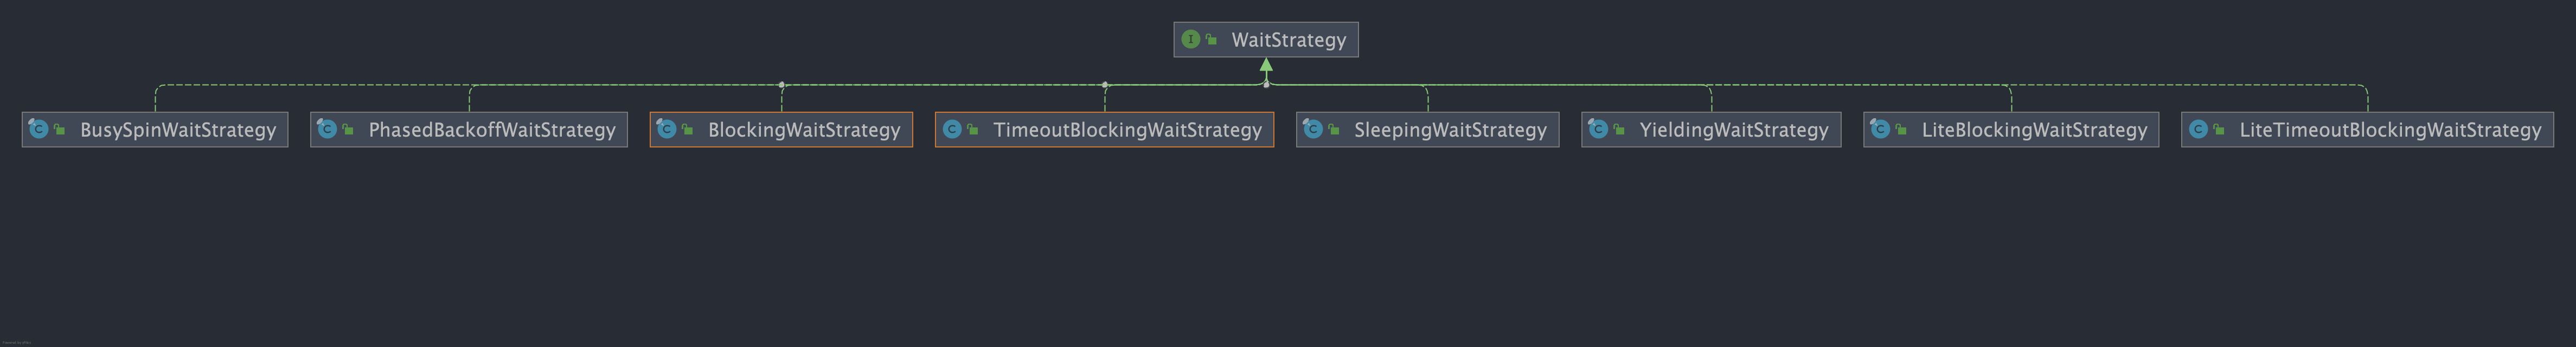
BlockingWaitStrategy: DùngReentrantLock+Conditionđể triển khai thao tác chờ và đánh thức. Code triển khai rất đơn giản, là waiting strategy mặc định của Disruptor. Dù chậm nhất, đây cũng là lựa chọn có CPU usage thấp nhất và ổn định nhất, được khuyến nghị trong production.BusySpinWaitStrategy: Performance tốt nhưng có nguy cơ spin liên tục. Sử dụng không đúng có thể khiến CPU load đạt 100%, cần thận trọng.LiteBlockingWaitStrategy: Waiting strategy nhẹ dựa trênBlockingWaitStrategy. Khi không có lock contention, nó bỏ qua thao tác đánh thức. Tuy nhiên, tác giả cho biết việc kiểm thử chưa đầy đủ nên không khuyến nghị sử dụng.TimeoutBlockingWaitStrategy: Waiting strategy có timeout. Sau khi timeout, nó thực thi business logic do người dùng chỉ định.LiteTimeoutBlockingWaitStrategy: Strategy dựa trênTimeoutBlockingWaitStrategy. Khi không có lock contention, nó bỏ qua thao tác đánh thức.SleepingWaitStrategy: Strategy ba giai đoạn: giai đoạn đầu spin, giai đoạn hai gọiThread.yieldđể nhường CPU, giai đoạn ba sleep trong một khoảng thời gian rồi lặp lại thao tác sleep.YieldingWaitStrategy: Strategy hai giai đoạn: giai đoạn đầu spin, giai đoạn hai gọiThread.yieldđể nhường CPU.PhasedBackoffWaitStrategy: Strategy bốn giai đoạn: giai đoạn đầu spin theo số lần chỉ định, giai đoạn hai spin theo khoảng thời gian chỉ định, giai đoạn ba gọiThread.yieldđể nhường CPU, giai đoạn bốn gọi methodwaitForcủa member variable. Member variable này có thể được đặt thành một trong ba strategy:BlockingWaitStrategy,LiteBlockingWaitStrategyvàSleepingWaitStrategy.
Bản chất của waiting strategy là sự đánh đổi giữa latency và CPU consumption:
- Khi cực kỳ nhạy với latency và machine resource được dành riêng, có thể đánh giá
BusySpinWaitStrategyhoặcYieldingWaitStrategy. - Với business service thông thường, nên bắt đầu từ
BlockingWaitStrategyđể kiểm soát stability và resource usage tốt hơn. - Nếu vừa muốn giảm busy loop vừa muốn phản hồi nhanh trong thời gian ngắn, có thể đánh giá
SleepingWaitStrategyhoặcPhasedBackoffWaitStrategy.
Không nên tùy tiện sử dụng busy-wait strategy trên machine dùng chung cho business, nếu không CPU rất dễ bị dùng hết và ảnh hưởng đến các service khác trên cùng machine.
Vì sao Disruptor nhanh như vậy?
- RingBuffer (array dạng vòng): RingBuffer bên trong Disruptor được triển khai bằng array. Vì mọi element trong array được tạo một lần khi khởi tạo nên địa chỉ memory của các element thường liên tiếp. Lợi ích là khi producer liên tục chèn event object mới vào RingBuffer, địa chỉ memory của các event object này vẫn liên tiếp, từ đó tận dụng locality principle của CPU cache để load các event object liền kề vào cache, cải thiện performance của chương trình. Cách này tương tự cơ chế read-ahead của MySQL, đọc trước một số page liên tiếp vào memory. Ngoài ra, RingBuffer dựa trên array còn hỗ trợ batch operation (xử lý nhiều element trong một lần), đồng thời tránh việc cấp phát memory và garbage collection thường xuyên (RingBuffer là array có kích thước cố định; khi thêm element mới mà array đã đầy, element mới sẽ ghi đè element cũ nhất).
- Tránh vấn đề false sharing: CPU cache được quản lý theo Cache Line (cache line), kích thước Cache Line thường khoảng 64 byte. Để bảo đảm field mục tiêu chiếm độc lập một Cache Line, Disruptor thêm byte padding trước và sau field mục tiêu (56 byte phía trước và 56 byte phía sau), nhờ đó tránh vấn đề false sharing. Đồng thời, để array lưu data trong RingBuffer chiếm độc lập một cache line, thiết kế của array là padding không hợp lệ (128 byte) + data hợp lệ.
- Thiết kế lock-free: Disruptor sử dụng thiết kế lock-free để tránh contention và latency do cơ chế lock truyền thống gây ra. Việc triển khai lock-free của Disruptor khá phức tạp, chủ yếu dựa trên CAS, memory barrier, RingBuffer và các công nghệ khác.
Tóm lại, tốc độ của Disruptor đến từ sự kết hợp của nhiều chiến lược optimization: vừa tận dụng đầy đủ đặc điểm của cấu trúc CPU cache hiện đại, vừa tránh các vấn đề concurrency và performance bottleneck thường gặp.
Tuy nhiên, lợi thế performance của Disruptor có điều kiện: logic xử lý event không được quá nặng, consumer không được block trong thời gian dài, capacity của RingBuffer phải được đánh giá theo peak traffic. Nếu consumer gọi slow API, slow SQL hoặc lock trong thời gian dài, queue dù nhanh đến đâu cũng bị năng lực xử lý của downstream kéo lại.
Để tìm hiểu chi tiết nguyên lý của high-performance queue Disruptor, bạn có thể xem bài viết này: Phân tích sơ lược nguyên lý high-performance queue Disruptor (tham khảo bài viết High-performance queue — Disruptor này của đội ngũ kỹ thuật Meituan).
🌈 Bổ sung thêm một điểm: Vì sao địa chỉ memory liên tiếp của các object element trong array có thể cải thiện performance?
CPU cache lưu data được sử dụng gần đây trong cache tốc độ cao để tăng tốc độ đọc, đồng thời dùng cơ chế prefetch để load trước data ở vùng memory liền kề nhằm tận dụng locality principle.
Trong computer system, CPU chủ yếu truy cập cache tốc độ cao và memory. Cache tốc độ cao là loại memory có tốc độ rất nhanh nhưng capacity tương đối nhỏ, thường được chia thành nhiều cấp. L1, L2 và L3 lần lượt biểu thị cache cấp một, cấp hai và cấp ba. Cache càng gần CPU thì tốc độ càng nhanh nhưng capacity càng nhỏ. Ngược lại, memory có capacity tương đối lớn nhưng tốc độ chậm hơn.
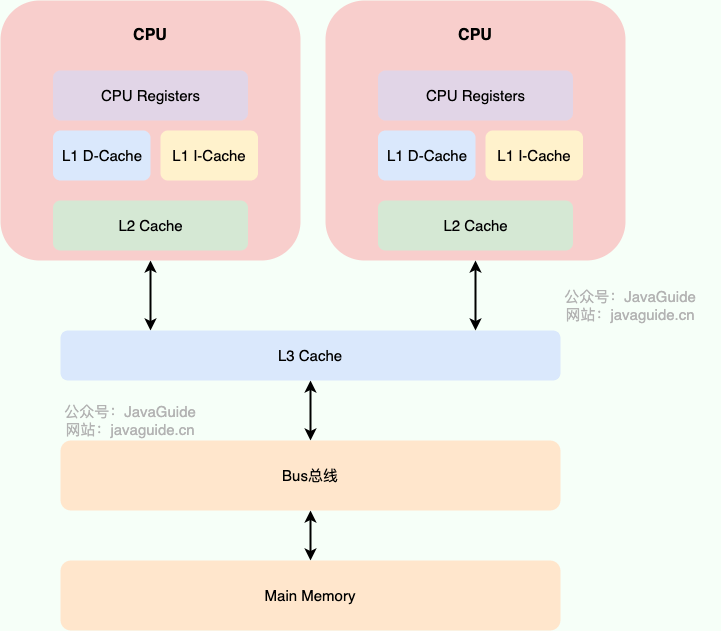
Để tăng tốc quá trình đọc data, CPU trước tiên load data từ memory vào cache tốc độ cao. Nếu lần sau cần truy cập cùng data, CPU có thể đọc trực tiếp từ cache tốc độ cao mà không cần truy cập memory lần nữa. Đây được gọi là cache hit. Ngoài ra, để tận dụng locality principle, CPU còn prefetch data memory liền kề dựa trên địa chỉ memory đã truy cập trước đó, vì các địa chỉ memory liên tiếp thường được truy cập thường xuyên trong chương trình. Cách này có thể tăng cache hit rate của data, từ đó cải thiện performance của chương trình.
Tham khảo
- Con đường high-performance của Disruptor - waiting strategy: http://wuwenliang.net/2022/02/28/Disruptor
- 《Java Concurrency in Practice》 - 40 | Phân tích case (3): High-performance queue Disruptor: https://time.geekbang.org/column/article/98134
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.