
Tổng hợp câu hỏi phỏng vấn hệ thống hiệu năng cao

Phỏng vấn về hệ thống hiệu năng cao thường bắt đầu từ một triệu chứng cụ thể: interface chậm đi, CPU database tăng cao, message bắt đầu tồn đọng hoặc lưu lượng trong đợt khuyến mãi lớn vượt quá capacity hiện tại. Khi trả lời, trước hết hãy xác nhận QPS, P99, data volume và tỷ lệ đọc/ghi, sau đó lần theo request chain để kiểm tra entry point, application, cache, database và message queue. Chỉ trả lời “thêm cache, dùng MQ, sharding” rất dễ bị hỏi tiếp.
Bài viết này là điểm bắt đầu ôn tập chủ đề hiệu năng cao của JavaGuide, được sắp xếp thành bốn phần: traffic entry point, database optimization, message queue và system design tổng hợp. Mỗi phần liệt kê các câu hỏi thường gặp; nguyên lý và cách triển khai cụ thể được trình bày trong các bài viết chuyên đề tương ứng.
Nếu thời gian khá gấp, bạn có thể xem trước Tổng hợp câu hỏi phỏng vấn hệ thống hiệu năng cao, đánh dấu những vấn đề tạm thời chưa giải thích được, rồi quay lại bài này để bổ sung nguyên lý và chi tiết engineering.
Khi ôn tập, trước hết cần nắm rõ những vấn đề nào?
| Module | Nội dung cần giải thích rõ | Hướng hỏi tiếp thường gặp |
|---|---|---|
| Traffic entry point | Làm thế nào rút ngắn khoảng cách truy cập của người dùng và phân phối request đến các node khả dụng | CDN, origin fetch, cache strategy, load balancing layer 4/layer 7, scheduling algorithm |
| Database optimization | Khi lượng đọc/ghi và data volume tăng, làm thế nào xác định và giảm bớt bottleneck của database | SQL, index, read/write separation, sharding, deep pagination, hot/cold data separation |
| Message queue | Những task nào có thể xử lý bất đồng bộ, làm thế nào ứng phó lưu lượng tăng đột biến | reliability, duplicate consumption, ordering, backlog, Kafka, RocketMQ, RabbitMQ |
| System design tổng hợp | Làm thế nào suy ra solution từ metrics, bottleneck và ràng buộc nghiệp vụ | capacity, load testing, consistency, cost, canary release và rollback |
Performance optimization không có một danh sách component cố định. Cùng một slow query có thể bắt nguồn từ thiếu index, deep pagination, hot data, phải chờ connection pool hoặc downstream interface làm chậm toàn bộ chain. Trước hết dùng metrics để xác định bottleneck, sau đó mới thảo luận solution và trade-off.
CDN và load balancing
CDN đặt content có thể cache trên các edge node gần người dùng hơn, giảm truyền tải liên vùng và áp lực lên origin; load balancing phân phối request đi vào hệ thống đến nhiều service instance. Một bên xử lý content delivery, bên kia xử lý request scheduling, nên chúng thường cùng xuất hiện ở entry layer trong câu hỏi system design.
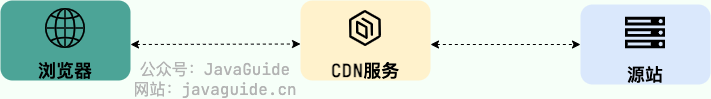
Nội dung liên quan:
- Giải thích chi tiết nguyên lý hoạt động của CDN
- Giải thích chi tiết nguyên lý và algorithm của load balancing
Câu hỏi phỏng vấn thường gặp:
- Vì sao CDN có thể giảm access latency? Những request nào vẫn cần origin fetch?
- HTML, JS/CSS có Hash, image và file download nên thiết lập cache như thế nào?
- Khi cache hit rate giảm hoặc lượng origin fetch đột ngột tăng, cần kiểm tra những config nào?
- Load balancing là gì? Load balancing layer 4 và layer 7 lần lượt hoạt động ở layer nào?
- Nên chọn round-robin, weighted round-robin, random, least connections và consistent hashing như thế nào?
- Health check, connection draining và session persistence ảnh hưởng thế nào đến việc node online/offline?
- Server-side load balancing và client-side load balancing khác nhau ra sao?
Khi trả lời câu hỏi về CDN, đừng mặc định mọi content đều phù hợp để cache dài hạn. Nếu HTML tham chiếu static resource cũ đã bị dọn, thời gian cache quá dài sẽ khiến người dùng nhận được page không thể load; response động liên quan đến identity và permission cũng cần tránh bị cache chéo giữa các user.
Database performance optimization
Sau khi database chậm đi, có thể xem trước slow SQL, execution plan, index hit, lock wait, connection pool và disk I/O. Khi một query đơn vẫn còn khả năng optimization, sharding ngay chỉ làm các vấn đề về query, transaction và vận hành cùng bị phóng đại. Read/write separation và data sharding phù hợp để giải quyết vấn đề capacity và throughput, nhưng không thể thay thế SQL và index optimization.
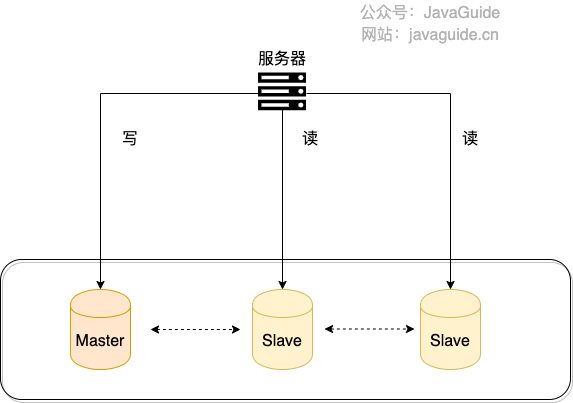
Nội dung liên quan:
- Giải thích chi tiết read/write separation và sharding
- Giải thích chi tiết hot/cold data separation
- Tổng hợp các phương pháp SQL optimization thường gặp
- Giới thiệu deep pagination và đề xuất optimization
Câu hỏi phỏng vấn thường gặp:
- Read/write separation giải quyết vấn đề gì? Master-slave replication phối hợp với read request routing như thế nào?
- Master-slave replication lag có thể gây ra những vấn đề nghiệp vụ nào? Những request nào bắt buộc phải đọc master database?
- Khi nào mới cần sharding? Vertical split và horizontal split khác nhau như thế nào?
- Sau khi sharding, xử lý cross-shard JOIN, pagination, sorting, transaction và scale-out như thế nào?
- Nên chọn shard key như thế nào? Hot tenant hoặc hot merchant sẽ gây ra vấn đề gì?
- SQL optimization nên bắt đầu từ bước nào trong slow query log, execution plan và index?
- Những cách viết nào sẽ khiến index mất hiệu lực? Xác định thứ tự field của composite index như thế nào?
- Vì sao
LIMIT offset, sizechậm hơn theo page number? Nên chọn cursor pagination, delayed association hay covering index như thế nào? - Phân chia hot data và cold data như thế nào? Trong thời gian migration, xử lý dual write, incremental synchronization và data validation ra sao?
Nhóm vấn đề này thường bị hỏi tiếp về consistency. Read/write separation làm lộ ra master-slave replication lag, sharding làm tăng chi phí cross-shard transaction và query, còn hot/cold data migration phải xử lý việc storage cũ và mới cùng tồn tại trong thời gian ngắn. Trong câu trả lời cần nêu rõ nghiệp vụ có thể chấp nhận inconsistency trong bao lâu, cũng như cách validation và compensation sau khi xảy ra lỗi.
Message queue và traffic peak shaving
Message queue có thể đưa các task không cần realtime ra khỏi synchronous call chain và tạm lưu request khi lưu lượng tăng đột biến. Sau khi đưa MQ vào, quan hệ gọi trở thành bất đồng bộ; producer confirmation, Broker persistence, consumer processing và retry strategy đều ảnh hưởng đến kết quả cuối cùng.
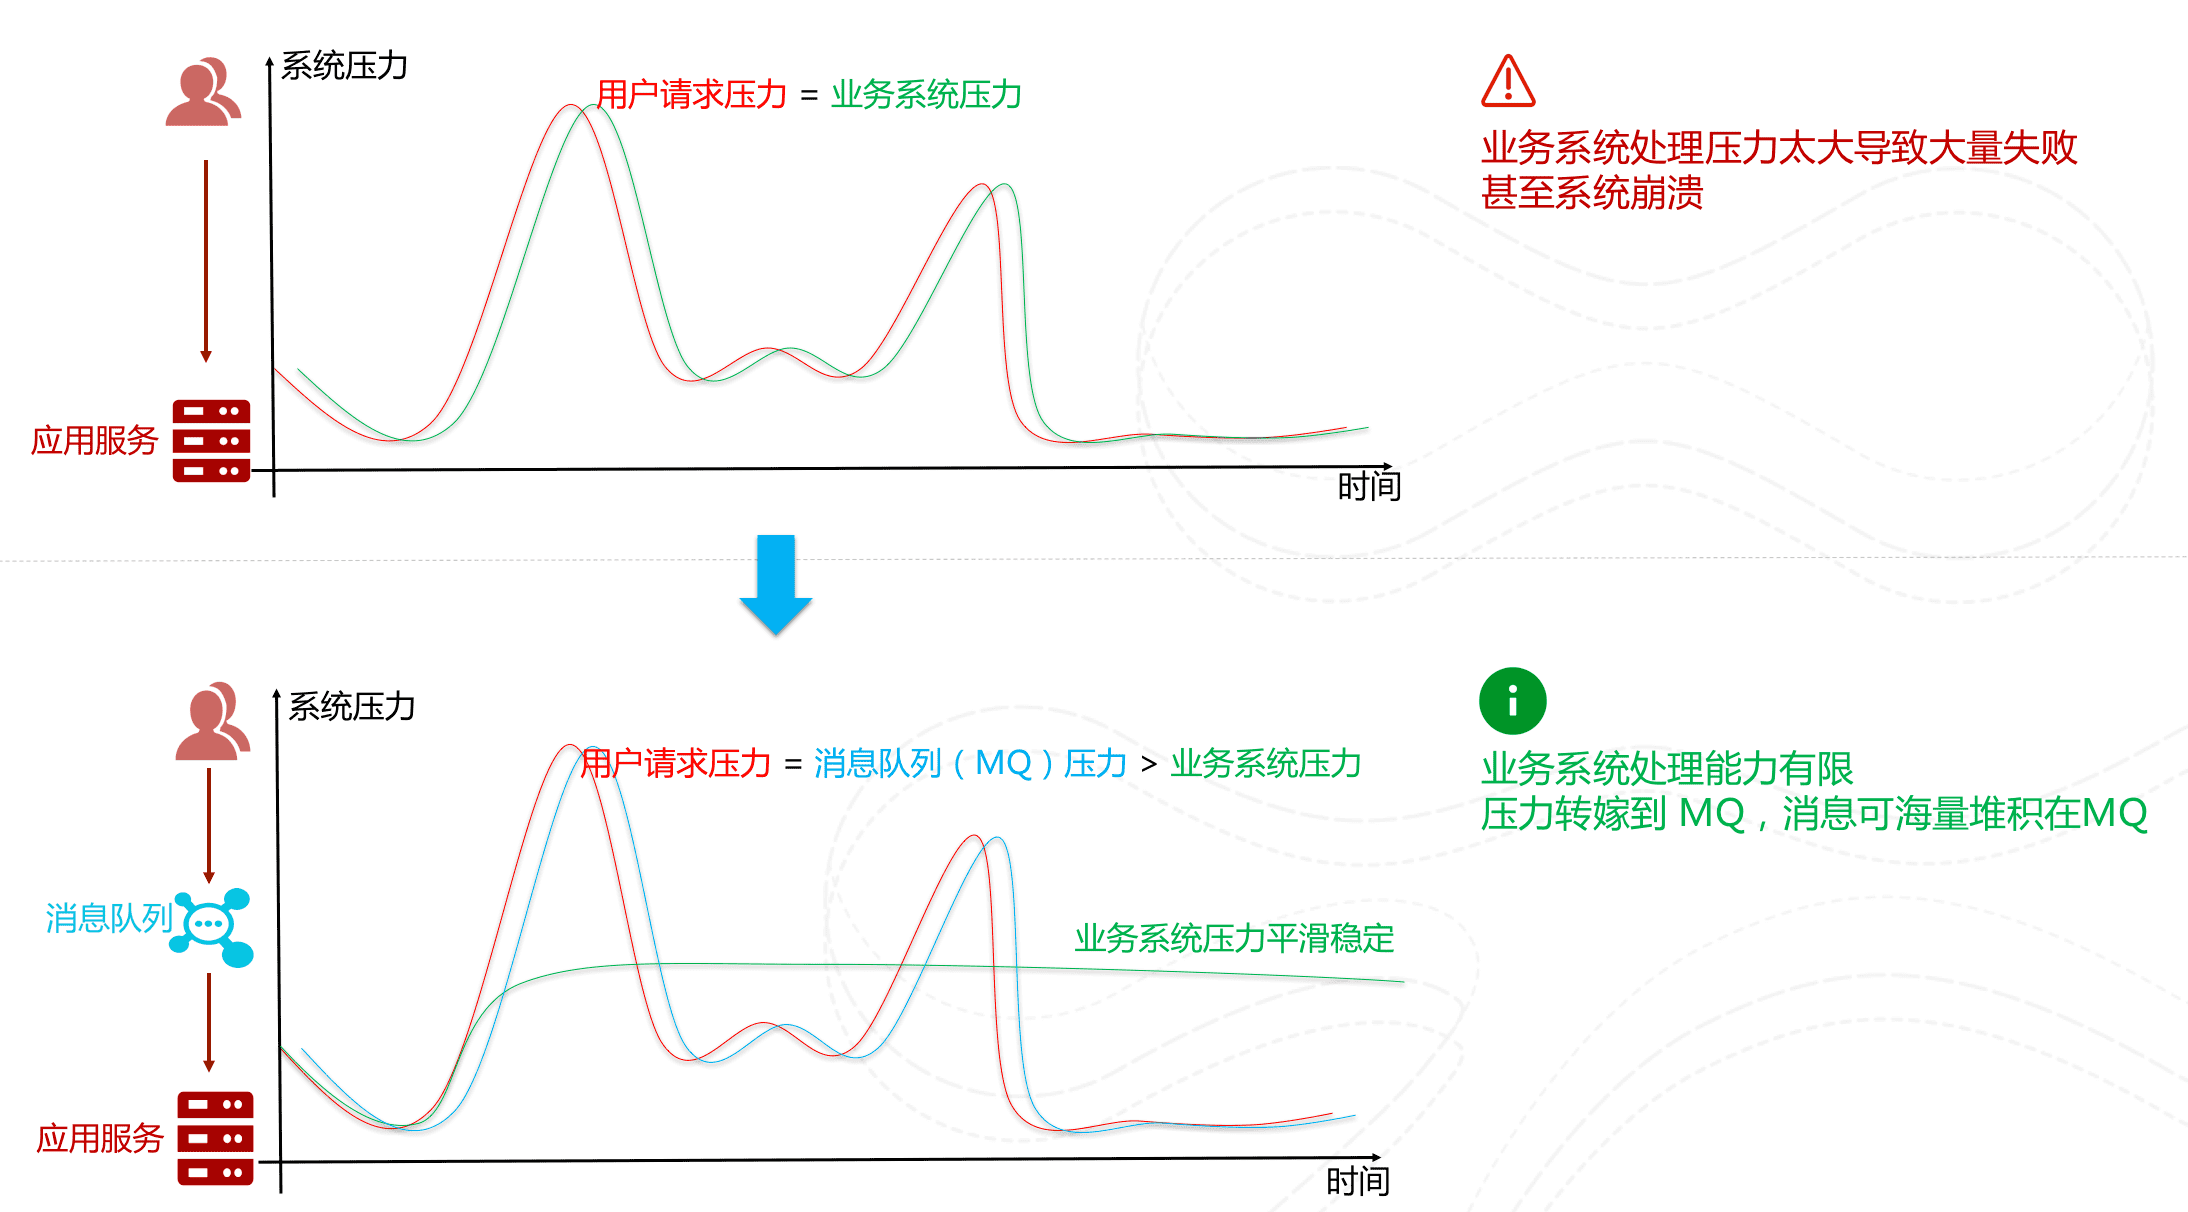
Nội dung liên quan:
- Tổng hợp câu hỏi phỏng vấn message queue
- Tổng hợp các vấn đề cơ bản thường gặp về message queue
- Tổng hợp câu hỏi phỏng vấn Kafka thường gặp
- Tổng hợp câu hỏi phỏng vấn RocketMQ thường gặp
- Tổng hợp câu hỏi phỏng vấn RabbitMQ thường gặp
- Tổng hợp câu hỏi phỏng vấn Disruptor thường gặp
Câu hỏi phỏng vấn thường gặp:
- Message queue thực hiện asynchronous processing, decoupling và traffic peak shaving như thế nào? Sau khi đưa vào sẽ phát sinh thêm những vấn đề gì?
- Một message từ producer đến consumer có thể bị mất ở những khâu nào?
- Vì sao at-least-once delivery có thể tạo ra duplicate message? Consumer bảo đảm idempotency như thế nào?
- Global ordering và partition ordering khác nhau ra sao? Ordered consumption phải đánh đổi những capability nào?
- Khi xảy ra message backlog, làm thế nào phân biệt producer tăng đột biến, consumer xử lý chậm, partition không đủ và downstream failure?
- Vì sao Kafka có throughput cao? Batch processing, sequential write, page cache và zero-copy lần lượt có tác dụng gì?
- ACK, replica và consumer offset của Kafka ảnh hưởng đến message reliability như thế nào?
- Transactional message của RocketMQ giải quyết vấn đề gì? Cơ chế truy vấn lại xử lý unknown state như thế nào?
- Exchange, Queue, Binding và Routing Key của RabbitMQ phối hợp với nhau ra sao?
- Disruptor khác message queue liên process như thế nào? Nó phù hợp đặt trong loại process-internal pipeline nào?
“Message không bị mất” không thể chỉ xét Broker có persistence hay không. Producer không nhận được confirmation sau khi gửi, consumer xử lý thành công nhưng commit offset thất bại, hoặc process crash sau khi business database ghi xong đều có thể khiến message bị mất hoặc bị lặp. Khi chuẩn bị câu trả lời, hãy giải thích từng đoạn dọc theo toàn bộ delivery chain.
Câu hỏi system design tổng hợp
Câu hỏi system design sẽ không nói trước bạn nên dùng component nào. Trước hết hãy xác nhận business goal và capacity, sau đó xác định bottleneck có khả năng nhất; sau khi solution được triển khai, còn phải dùng load testing và monitoring để kiểm chứng. Không thể chỉ dùng average RT hoặc single-node QPS để chứng minh hệ thống đã đáp ứng yêu cầu.
Nội dung liên quan: Nhập môn performance testing
Câu hỏi phỏng vấn thường gặp:
- Làm thế nào thiết kế một order system hiệu năng cao? Query, order placement và asynchronous task lần lượt xử lý như thế nào?
- Khi interface chậm đi, làm thế nào sử dụng Trace, slow SQL, thread pool, connection pool và metrics tài nguyên hệ thống để xác định bottleneck?
- QPS, TPS, concurrency, P95/P99 và error rate lần lượt phản ánh điều gì?
- Làm thế nào ước tính capacity từ business peak, đồng thời chừa safety margin cho database, cache, MQ và downstream interface?
- Cache, read/write separation, sharding và message queue nên được đưa vào theo thứ tự nào?
- Sau khi optimization được release, làm thế nào kiểm chứng hiệu quả bằng canary release, load testing, monitoring và rollback?
- Sau khi performance tăng, consistency, availability, cost và độ phức tạp vận hành sẽ thay đổi ra sao?
Với vị trí tuyển dụng người đã có kinh nghiệm và vị trí trung/cao cấp, thường sẽ tiếp tục hỏi về bằng chứng từ project. Ví dụ “sau optimization interface nhanh hơn” cần bổ sung traffic, latency percentile, error rate, resource utilization, môi trường load testing và observation period trước và sau optimization. Với phần chưa từng tham gia, chỉ cần trả lời theo kết quả học được, không bịa production metrics.
Sắp xếp việc ôn tập theo thời gian chuẩn bị
| Thời gian còn lại | Sắp xếp đề xuất | Mục tiêu ôn tập |
|---|---|---|
| 1–2 ngày | Đọc qua toàn bộ câu hỏi trong bài, ưu tiên bổ sung SQL/index, read/write separation, sharding và message reliability | Có thể trả lời các câu hỏi thường gặp và nêu được hạn chế chính của từng solution |
| 3–7 ngày | Bổ sung CDN, load balancing, deep pagination, hot/cold data separation và một MQ phổ biến, sau đó vẽ một request chain hoàn chỉnh | Có thể suy ra solution từ bottleneck, tiếp tục trả lời khi gặp vấn đề consistency và exception scenario |
| Trên 1 tuần | Đọc toàn bộ bài viết chuyên đề, kết hợp với project để tổng hợp một lần quá trình phát hiện, xác định, optimization và validation vấn đề performance | Có thể dùng metrics thực tế để giải thích lựa chọn, lợi ích, chi phí và cách monitoring tiếp theo |
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.