
Tổng hợp câu hỏi phỏng vấn thiết kế hệ thống high availability mới nhất năm 2026: SLA, rate limiting, circuit breaker, retry, idempotency và disaster recovery

Câu hỏi phỏng vấn về high availability thường bắt đầu bằng câu “Hệ thống làm thế nào để không sập?”, sau đó hỏi tiếp về single point of failure, rate limiting, circuit breaker, timeout, retry, API idempotency và disaster recovery ở nhiều địa điểm. Chỉ liệt kê các component thường chưa đủ; bạn còn phải giải thích cách phát hiện sự cố, cách kiểm soát ảnh hưởng, cách khôi phục service và liệu dữ liệu có giữ được tính chính xác hay không.
Bài viết này là điểm bắt đầu ôn tập chuyên đề high availability của JavaGuide, được tổng hợp thành năm phần: nền tảng high availability, redundancy và disaster recovery, rate limiting, degradation và circuit breaker, timeout, retry và idempotency, performance testing và quản trị sự cố. Câu trả lời và chi tiết triển khai nằm trong các bài chuyên đề tương ứng.
Nếu thời gian khá gấp, bạn có thể đọc trước Tổng hợp câu hỏi phỏng vấn hệ thống high availability thường gặp, đánh dấu những vấn đề chưa giải thích được, rồi quay lại bài này để bổ sung nguyên lý và chi tiết engineering.
Khi ôn tập, trước hết cần nắm những vấn đề nào?
| Module | Nội dung cần giải thích rõ | Hướng hỏi thêm thường gặp |
|---|---|---|
| Nền tảng high availability | Đo availability thế nào, giảm tỷ lệ và phạm vi ảnh hưởng của sự cố ra sao | SLA, chỉ số availability, single point of failure, canary release |
| Redundancy và disaster recovery | Sau khi node hoặc data center gặp sự cố, resource dự phòng tiếp quản traffic và data thế nào | RTO, RPO, cold standby/warm standby, hot standby, multi-active, failover, split-brain |
| Rate limiting, degradation và circuit breaker | Khi traffic vượt capacity hoặc downstream liên tục bất thường, bảo vệ service thế nào | Thuật toán rate limiting, degradation, circuit breaker, isolation, Sentinel |
| Timeout, retry và idempotency | Sau khi remote call thất bại có thể retry không, tránh duplicate write thế nào | Deadline, backoff, Retry Budget, idempotency key, state machine |
| Performance và quản trị sự cố | Xác định capacity, phát hiện bottleneck và kiểm chứng phương án chịu lỗi thế nào | P99, performance testing, capacity assessment, vấn đề cache, fault drill |
Cần hiểu các cơ chế này trong cùng một call chain. Khi traffic đầu vào quá lớn, trước hết phải rate limiting; khi downstream phản hồi quá chậm, cần timeout kịp thời; lỗi transient có thể retry trong phạm vi budget; nếu bất thường kéo dài thì trigger circuit breaker. Với write request, còn phải dùng cơ chế idempotency để tránh side effect lặp lại.
Nền tảng high availability
High availability không có nghĩa là không bao giờ xảy ra sự cố. Thiết kế hệ thống cần trả lời: làm thế nào để giảm sự cố, giới hạn ảnh hưởng sau khi sự cố xảy ra và khôi phục service trong bao lâu. Deploy thêm vài instance chỉ giảm single point ở tầng application; database, cache, message queue, configuration center, DNS và load balancing vẫn có thể trở thành nguồn sự cố.
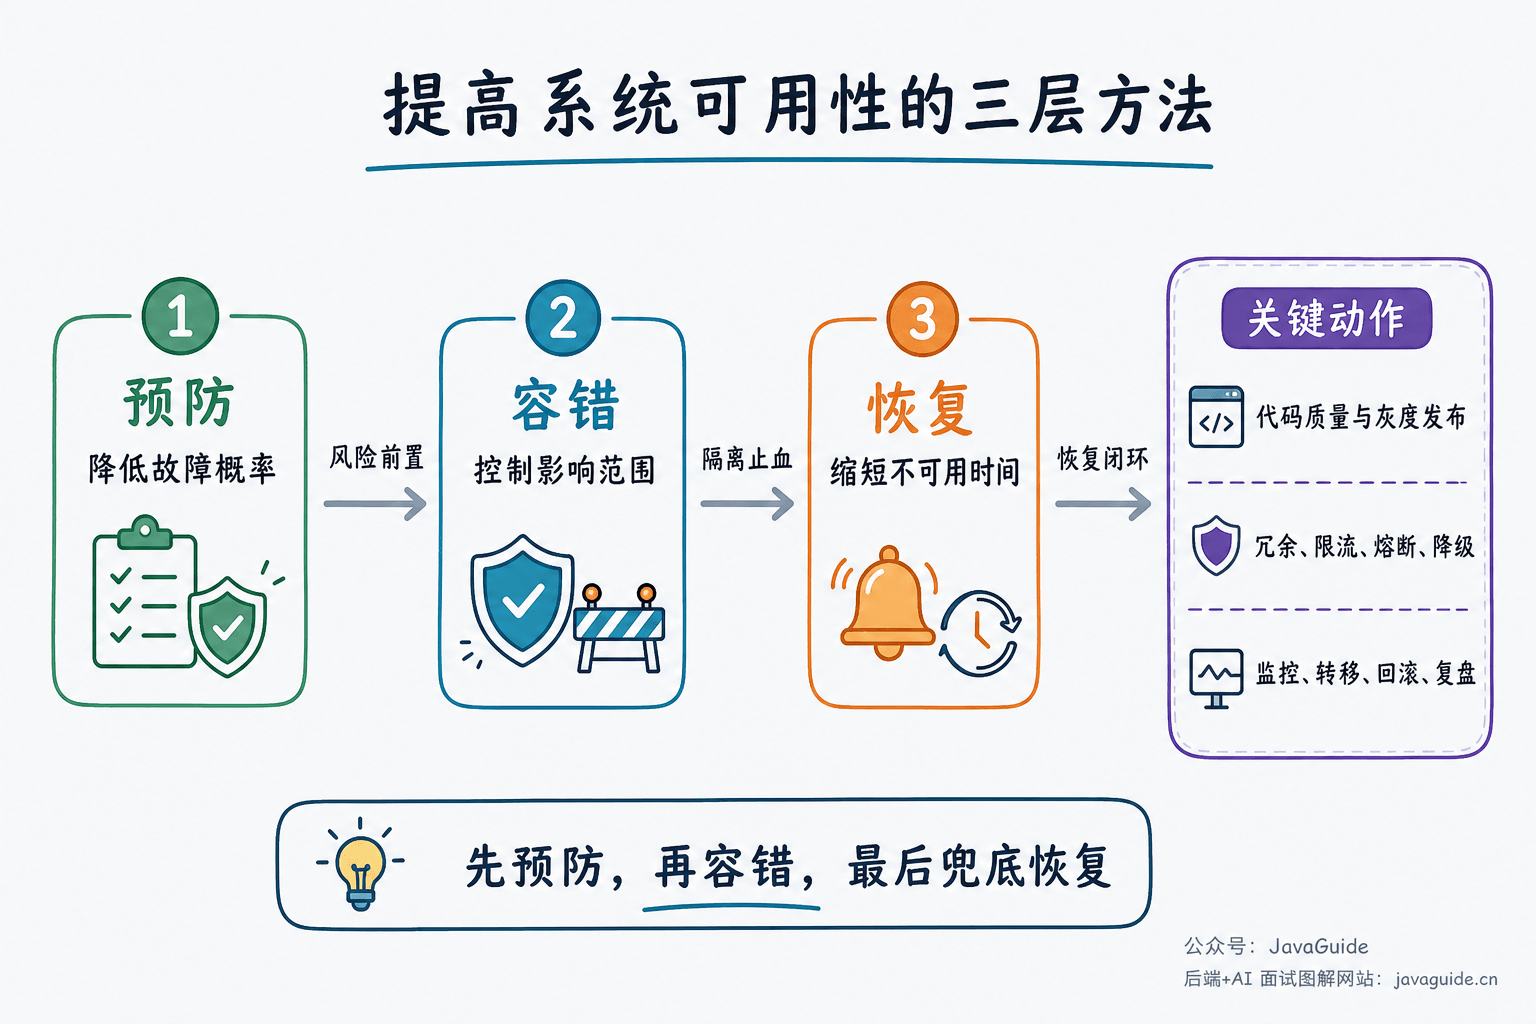
Nội dung liên quan: Hướng dẫn thiết kế hệ thống high availability
Câu hỏi phỏng vấn thường gặp:
- High availability là gì? Nó khác gì với “deploy thêm vài máy”?
- Availability 99.9%, 99.99% và 99.999% lần lượt cho phép gián đoạn trong bao lâu?
- Code, release, traffic, infrastructure và external dependency có thể khiến hệ thống unavailable thế nào?
- Thông thường cần bắt đầu từ những phương diện nào để nâng cao availability của hệ thống?
- Single point of failure là gì? Vì sao có instance dự phòng nhưng vẫn chưa chắc đã loại bỏ single point?
- Canary release kiểm soát rủi ro thay đổi thế nào? Tăng traffic, monitoring và rollback phối hợp ra sao?
Khi trả lời về availability metrics, trước hết phải nói rõ cách thống kê. Tính theo calendar month hay calendar year, maintenance theo kế hoạch có được tính hay không, các API khác nhau có dùng cùng một SLA hay không, tất cả đều ảnh hưởng đến con số cuối cùng. Thêm một số 9 sau dấu thập phân cũng làm tăng chi phí redundancy, vận hành và fault drill.
Redundancy và disaster recovery
Redundancy giải quyết câu hỏi “resource dự phòng ở đâu”, còn disaster recovery phải xử lý thêm việc phát hiện, chuyển đổi, data replication và khôi phục. Với stateless service, tự động loại instance bị lỗi khỏi traffic thường khá dễ; còn database failover, chuyển traffic giữa các region và money flow liên quan đến rủi ro dữ liệu, thường cần phương án xác nhận và failback thận trọng hơn.
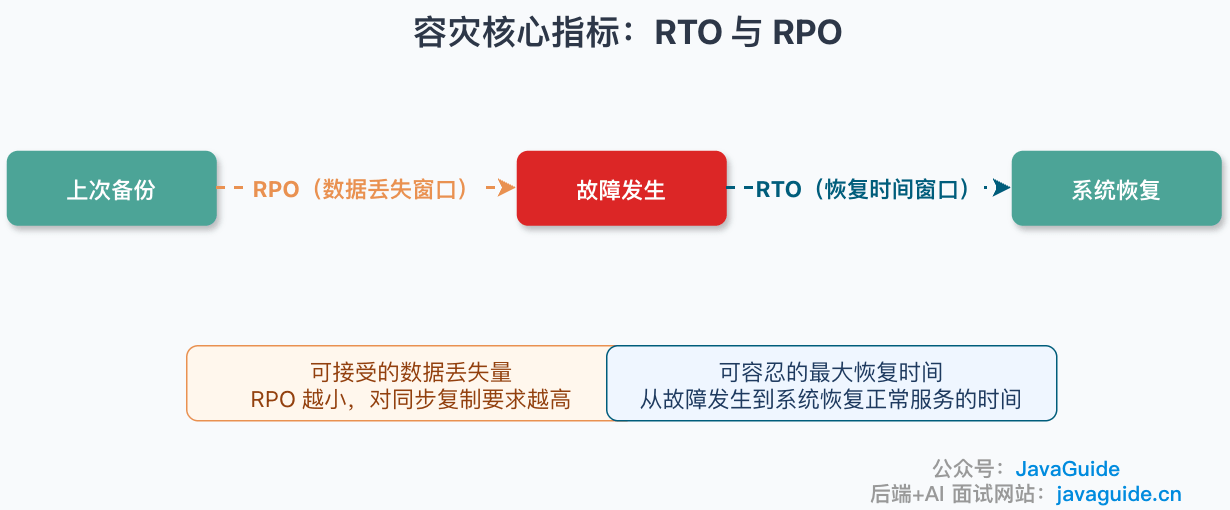
Nội dung liên quan: Giải thích chi tiết về thiết kế redundancy
Câu hỏi phỏng vấn thường gặp:
- Redundancy là gì? Service, database, cache và data center lần lượt làm redundancy thế nào?
- RTO và RPO lần lượt ràng buộc điều gì? RPO=0 đem lại những chi phí nào?
- Cold standby, warm standby, hot standby và multi-active khác nhau thế nào?
- Nên lựa chọn disaster recovery cùng thành phố, multi-active cùng thành phố hay multi-active khác địa điểm thế nào?
- Failover là gì? Automatic switch và manual confirmation lần lượt phù hợp với những scenario nào?
- Phát hiện sự cố quá nhanh hoặc quá chậm sẽ gây ra vấn đề gì?
- Vì sao network partition có thể dẫn đến split-brain? Majority, lease và fencing tránh double-primary write thế nào?
- Redis Sentinel failover có thể bảo đảm RPO=0 không?
quorumcó vai trò gì trong election?
RTO/RPO đưa ra mục tiêu disaster recovery, nhưng hoàn tất configuration không chứng minh hệ thống đã đạt mục tiêu. Backup có khôi phục được hay không, traffic có chuyển đi được hay không, data sau khi chuyển đổi có đầy đủ hay không, tất cả đều phải được kiểm chứng bằng fault drill định kỳ. Mức độ chấp nhận về thời gian khôi phục và mất data của order query và money accounting khác nhau, cũng không cần ép dùng cùng một bộ metrics.
Rate limiting, degradation và circuit breaker
Ba cơ chế này xử lý các vấn đề khác nhau. Rate limiting kiểm soát số request đi vào hệ thống; degradation giảm capability của service theo business priority; circuit breaker dừng call khi downstream liên tục bất thường. Isolation tách thread, connection hoặc concurrency quota, tránh để một dependency chiếm hết toàn bộ resource.
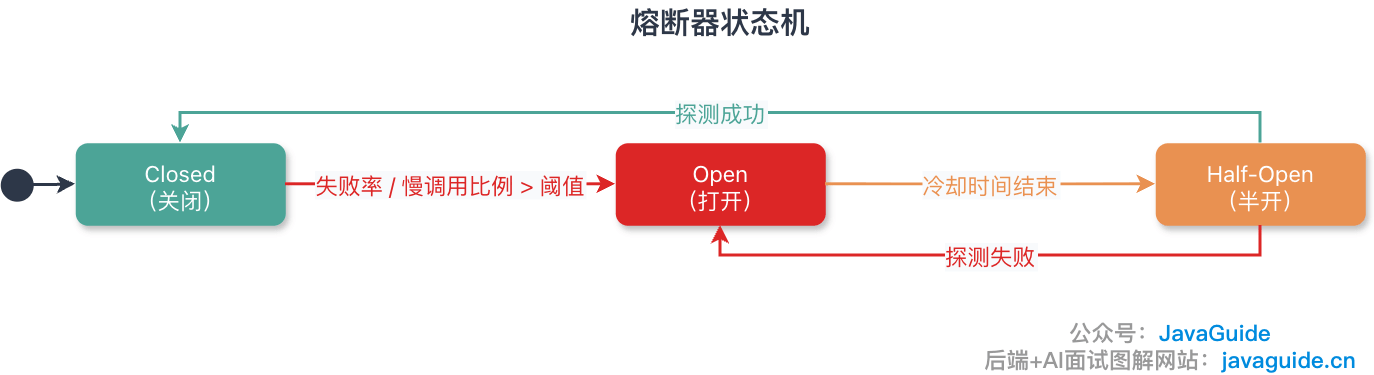
Nội dung liên quan:
Câu hỏi phỏng vấn thường gặp:
- Vì sao cần rate limiting? Request bị rate limiting nên reject, xếp hàng hay trả về degradation result?
- Fixed window, sliding window, leaky bucket và token bucket lần lượt phù hợp với scenario nào?
- Vì sao fixed window tạo ra traffic spike ở ranh giới giữa hai window?
- Single-node rate limiting và distributed rate limiting khác nhau thế nào? Khi Redis rate limiting mất hiệu lực thì fallback thế nào?
- Rate limiting ở gateway, API, user, IP và tenant nên kết hợp ra sao?
RateLimitercủa Guava khác nhau thế nào giữaSmoothBurstyvàSmoothWarmingUp?- Degradation và circuit breaker lần lượt được trigger bởi điều gì? Cách khôi phục khác nhau thế nào?
- Ba state Closed, Open và HalfOpen của circuit breaker chuyển đổi thế nào?
- Timeout, retry, rate limiting, circuit breaker và isolation nên được đưa vào cùng một call chain ra sao?
- Thread pool isolation và semaphore isolation có những chi phí nào?
- Vì sao Fallback nên tránh remote call mới hết mức có thể?
- Nên lựa chọn Hystrix, Sentinel và Resilience4j thế nào?
Phương án không thể chỉ viết threshold mà còn phải giải thích cơ sở của threshold và recovery action. Sau khi circuit breaker mở, bao lâu thì chuyển sang HalfOpen, mỗi lần cho phép bao nhiêu traffic probe; sau khi rate limiting trigger có trả về Retry-After hay không; degradation result được đánh dấu và monitor thế nào: tất cả đều ảnh hưởng đến hành vi trên production.
Timeout, retry và idempotency
Timeout chỉ có nghĩa là caller không nhận được kết quả trong deadline, không chứng minh server execution thất bại. Query request có thể retry có giới hạn trong tổng time budget; còn write request như payment, order creation và inventory deduction bắt buộc phải dùng idempotency key, unique constraint hoặc state machine để kiểm soát execution lặp lại.
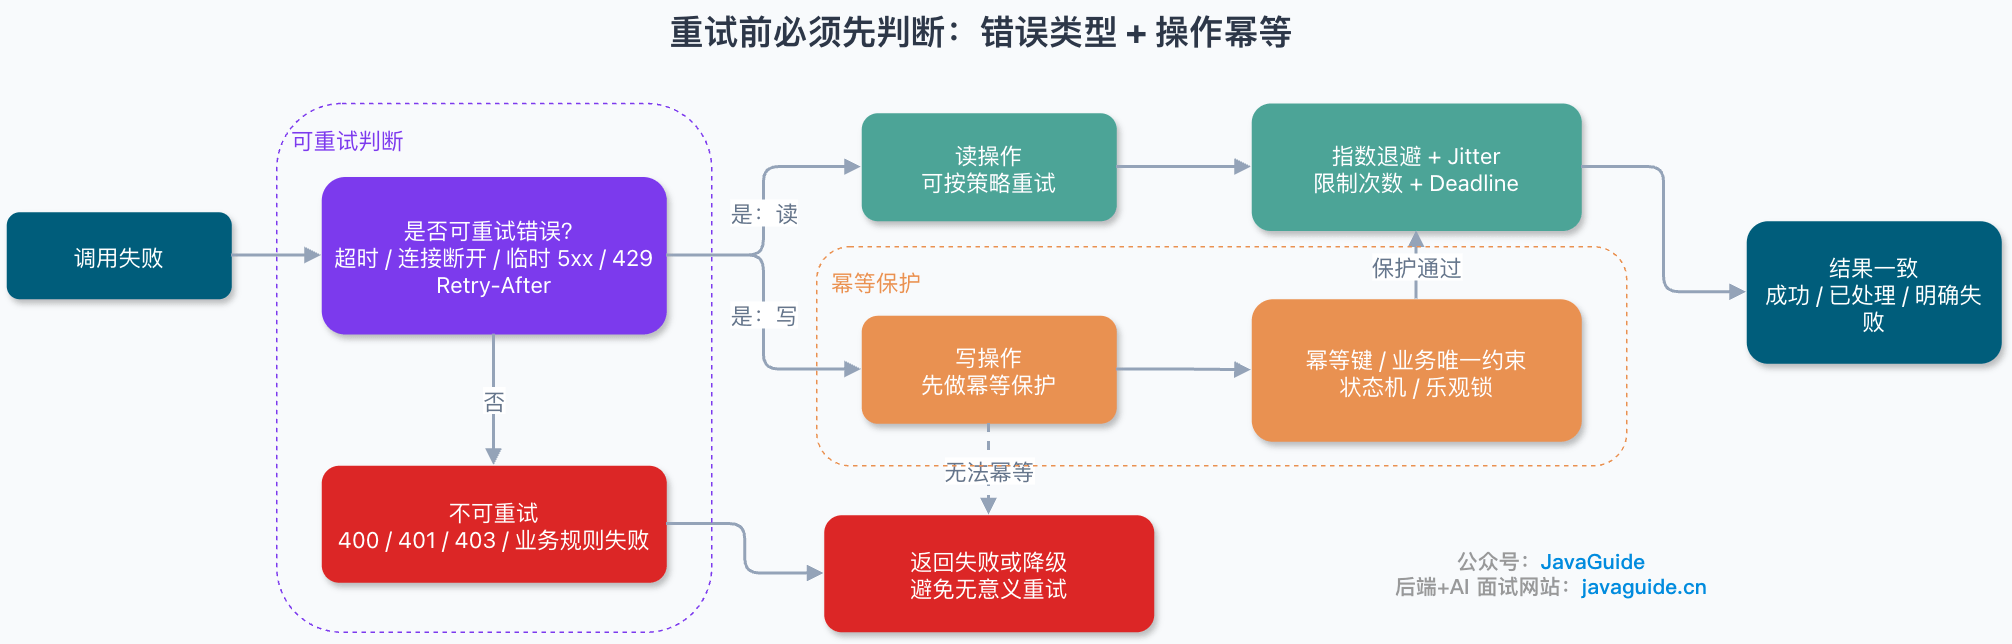
Nội dung liên quan:
Câu hỏi phỏng vấn thường gặp:
- Vì sao remote call bắt buộc phải đặt timeout? Connection, read, connection pool và tổng Deadline lần lượt giới hạn điều gì?
- Timeout nên tham chiếu P99/P999, business wait time hay SLA của downstream?
- Timeout Budget trong call chain được truyền qua từng tầng thế nào?
- Vì sao retry có thể khuếch đại sự cố? Exponential backoff và Jitter giải quyết vấn đề gì?
- Network error và HTTP status nào phù hợp để retry? Lỗi nào nên fail trực tiếp?
- Retry Budget là gì? Điều gì xảy ra khi nhiều tầng SDK đồng thời retry?
- Idempotency là gì? HTTP idempotency semantics khác business idempotency thế nào?
- Idempotency key, unique index, Redis, optimistic lock và state machine lần lượt phù hợp với scenario nào?
- Payment API xử lý initial request, concurrent duplicate request và duplicate notification thế nào?
- Deduplication và idempotency khác nhau thế nào? Vì sao deduplication ở entry point không thể thay thế server-side idempotency?
- Khi dùng Token để chống duplicate submission, thứ tự consume Token và execute business có rủi ro gì?
- Khi dùng pessimistic lock để làm idempotency, tránh range lock, deadlock và long transaction thế nào?
Khi chuẩn bị phần này, cần nói nhiều hơn về các tình huống không xác định được kết quả: server đã hoàn tất việc trừ tiền nhưng response lại mất trên network; sau khi caller timeout, nếu business không có request number ổn định, request lần hai có thể dẫn đến trừ tiền lần thứ hai.
Performance testing và quản trị sự cố
Không có capacity data và kết quả fault drill, phương án high availability chỉ dừng ở bản thiết kế. Performance testing dùng để quan sát latency, throughput và thay đổi resource dưới các mức traffic khác nhau; fault drill kiểm chứng sau khi node down, dependency chậm hoặc network partition, cơ chế bảo vệ và khôi phục có hoạt động đúng như dự kiến hay không.
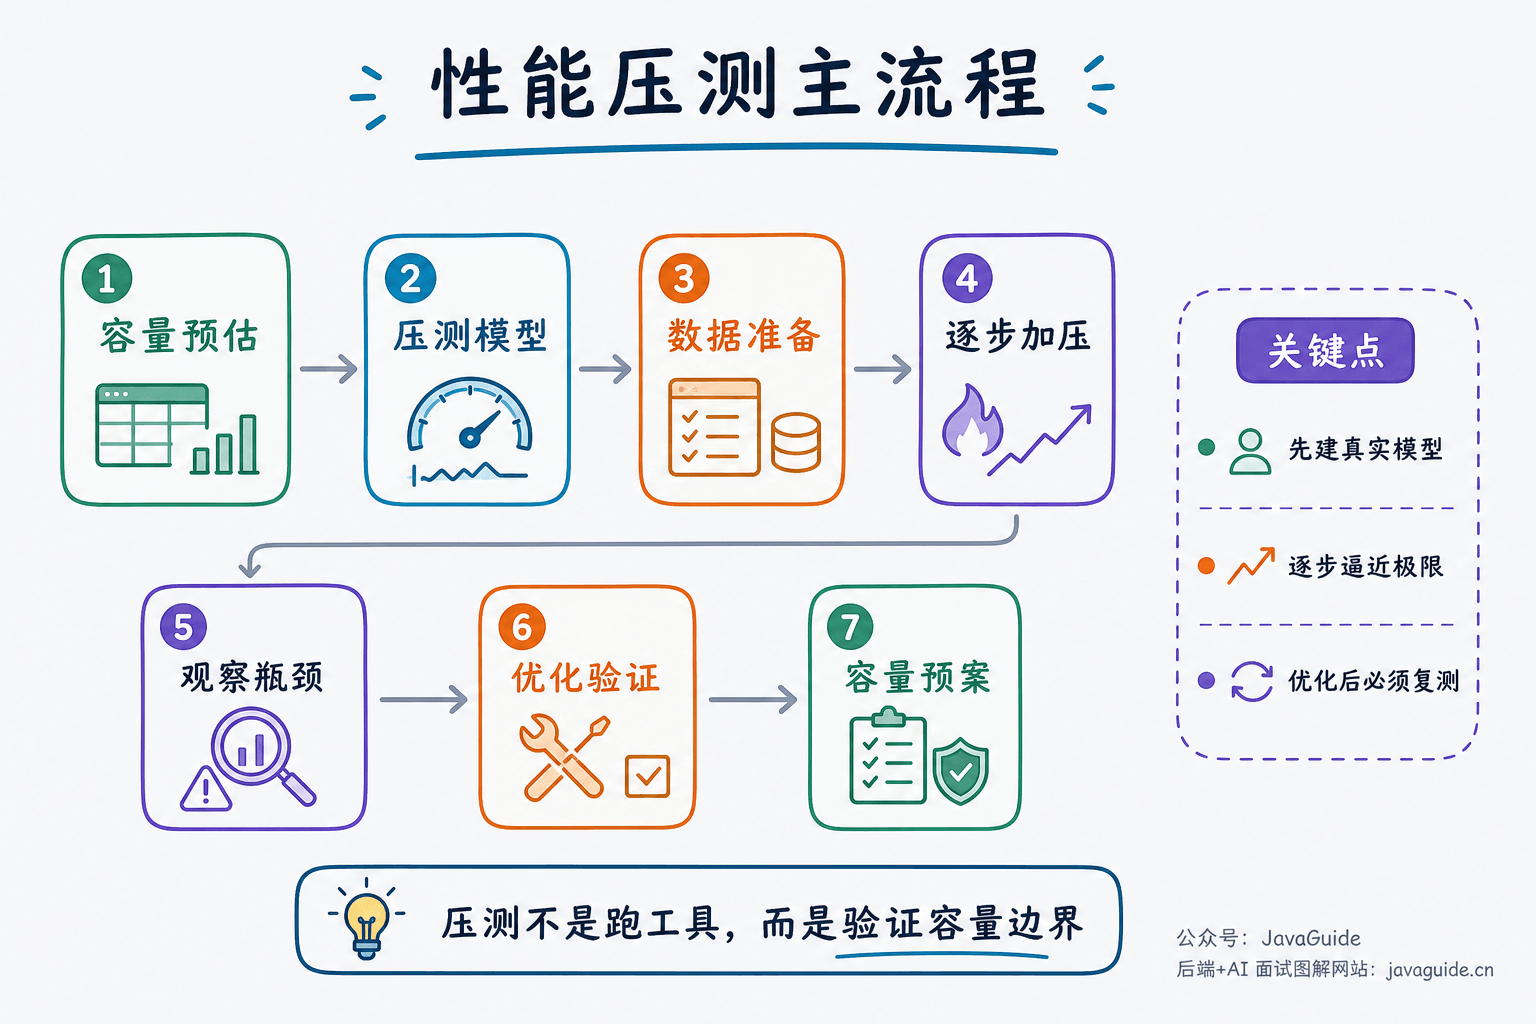
Nội dung liên quan: Nhập môn performance testing
Câu hỏi phỏng vấn thường gặp:
- RT, QPS, TPS, concurrency, throughput và error rate lần lượt phản ánh điều gì?
- Vì sao average RT không đại diện cho tail latency? Nên xem P95, P99 thế nào?
- Performance testing, load testing, stress testing và stability testing khác nhau thế nào?
- Vì sao capacity assessment không thể chỉ xem application server? Tìm bottleneck ở database, cache hoặc connection pool thế nào?
- Cache penetration (cache xuyên thấu), cache breakdown (sập cache) và cache avalanche lần lượt được trigger bởi điều gì?
- Fault drill là gì? Nó khác gì với vấn đề được kiểm chứng bằng performance testing?
- Thiết kế một hệ thống high availability thế nào? Khi trả lời, nối redundancy, rate limiting, circuit breaker, idempotency và observability ra sao?
- Sau khi timeout và retry lên production, vì sao phải đồng thời theo dõi initial success rate và final success rate?
Nếu initial success rate liên tục giảm nhưng final success rate lại ít thay đổi, hệ thống có thể đang dùng retry để che giấu lỗi downstream. Khi đó không chỉ xem final success rate, mà còn phải kiểm tra retry QPS, timeout rate, thread pool queue, connection pool wait time và state của circuit breaker.
Sắp xếp ôn tập theo thời gian chuẩn bị
| Thời gian còn lại | Đề xuất sắp xếp | Mục tiêu ôn tập |
|---|---|---|
| 1-2 ngày | Đọc nhanh Tổng hợp câu hỏi phỏng vấn hệ thống high availability thường gặp, ưu tiên bổ sung rate limiting, circuit breaker, timeout, retry và idempotency | Trả lời được câu hỏi thường gặp, nêu được rủi ro và giới hạn chính |
| 3-7 ngày | Bổ sung RTO/RPO, failover, isolation, capacity assessment và high availability của cache, sau đó vẽ một call chain hoàn chỉnh | Giải thích được các cơ chế phối hợp thế nào, tiếp tục suy luận trong scenario sự cố |
| Trên 1 tuần | Đọc toàn bộ bài chuyên đề, kết hợp project của mình để tổng hợp một case về release, timeout, traffic spike hoặc dependency failure | Trình bày được từ business SLA đến lựa chọn phương án, metrics quan sát, khôi phục và retrospective |
Với vị trí tuyển dụng xã hội và vị trí trung, cao cấp, bạn còn phải chuẩn bị các constraint thực tế trong project. Khi interviewer hỏi “Vì sao đặt timeout là 500ms?”, họ sẽ tiếp tục hỏi về latency distribution, tổng budget của upstream, số lần retry, capacity của downstream và cách điều chỉnh động. Với phần bạn chưa trực tiếp tham gia thiết kế, hãy trả lời theo kết quả học tập và nghiên cứu, không bịa số liệu production.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.