
Dù là hardware failure, mất điện tại data center hay một service đột ngột dừng hoạt động, single point luôn là mắt xích yếu nhất trong hệ thống. Muốn hệ thống vẫn chịu được nhiều tình huống bất ngờ, cách cơ bản và hiệu quả nhất là redundancy — chuẩn bị nhiều bản sao cho tài nguyên quan trọng để khi một bản hỏng, bản khác có thể thay thế.
Bài viết này tổng hợp các khái niệm cốt lõi và phương án phổ biến của redundancy design: từ hai chỉ số disaster recovery là RTO/RPO, đến high availability cluster, same-city disaster recovery, geo multi-active, rồi các phương án failover cụ thể như Redis Sentinel và Keepalived.
Redundancy là gì?
Redundancy là phương pháp phổ biến để nâng cao availability và data durability của hệ thống. Tư tưởng cốt lõi là triển khai nhiều bản sao của cùng một tài nguyên; khi một bản gặp sự cố, các bản khác có thể tiếp quản công việc, từ đó bảo đảm hệ thống tiếp tục hoạt động.
Redundancy là nền tảng để nâng cao availability của hệ thống, nhưng bản thân redundancy không đồng nghĩa với high availability. Chỉ khi kết hợp với failure detection, traffic switching, data replication, recovery drill và monitoring alerting, redundancy mới thực sự giảm được ảnh hưởng của sự cố.
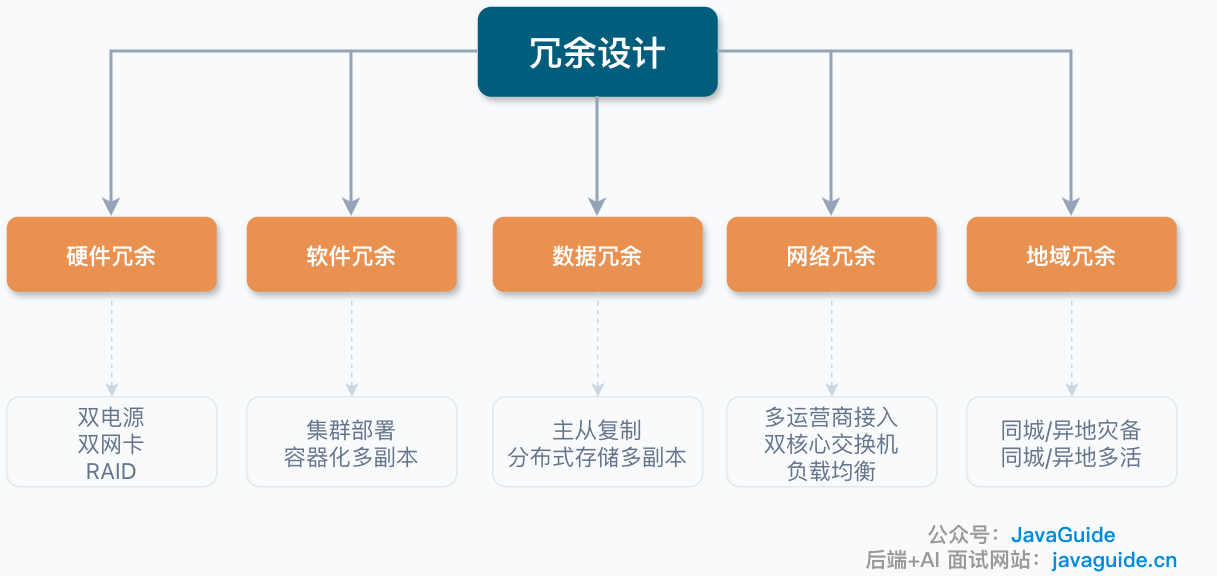
Có thể hiểu redundancy design theo các chiều sau:
| Loại redundancy | Mô tả | Triển khai điển hình |
|---|---|---|
| Hardware redundancy | Triển khai nhiều bản sao hardware quan trọng | Dual power supply, dual NIC, RAID |
| Software redundancy | Triển khai nhiều instance application service | Cluster deployment, nhiều replica container |
| Data redundancy | Lưu trữ nhiều replica của data | Database master-slave replication, nhiều replica của distributed storage |
| Network redundancy | Redundancy của network link và thiết bị | Kết nối nhiều nhà mạng, dual core switch, dual link, active-standby hoặc nhiều instance của load balancing |
| Geographic redundancy | Triển khai hệ thống ở các vị trí địa lý khác nhau | Same-city disaster recovery, geo-disaster recovery, same-city multi-active, geo multi-active |
Service redundancy: triển khai cùng một service thành hai hoặc nhiều instance; khi xảy ra sự cố, tự động chuyển sang instance khỏe, giảm đáng kể thời gian hệ thống không khả dụng và nâng cao availability.
Data redundancy: lưu trữ nhiều replica của cùng một data. Khi mất bất kỳ replica nào, vẫn có thể khôi phục từ các replica khác, nhờ đó nâng cao data durability và availability.
Trong thực tế, đời sống hằng ngày cũng có nhiều ví dụ về redundancy design. Với bản thân tôi, cách lưu các file quan trọng chính là một ứng dụng của tư tưởng redundancy. Các file quan trọng tôi dùng hằng ngày đều được đồng bộ thêm một bản lên GitHub và cloud drive cá nhân. Nhờ vậy, ngay cả khi hard drive của máy tính hỏng, tôi vẫn có thể lấy lại file quan trọng từ GitHub hoặc cloud drive cá nhân.
Chỉ số cốt lõi của disaster recovery: RTO và RPO
Trước khi bàn về disaster recovery architecture, cần hiểu hai chỉ số cốt lõi:
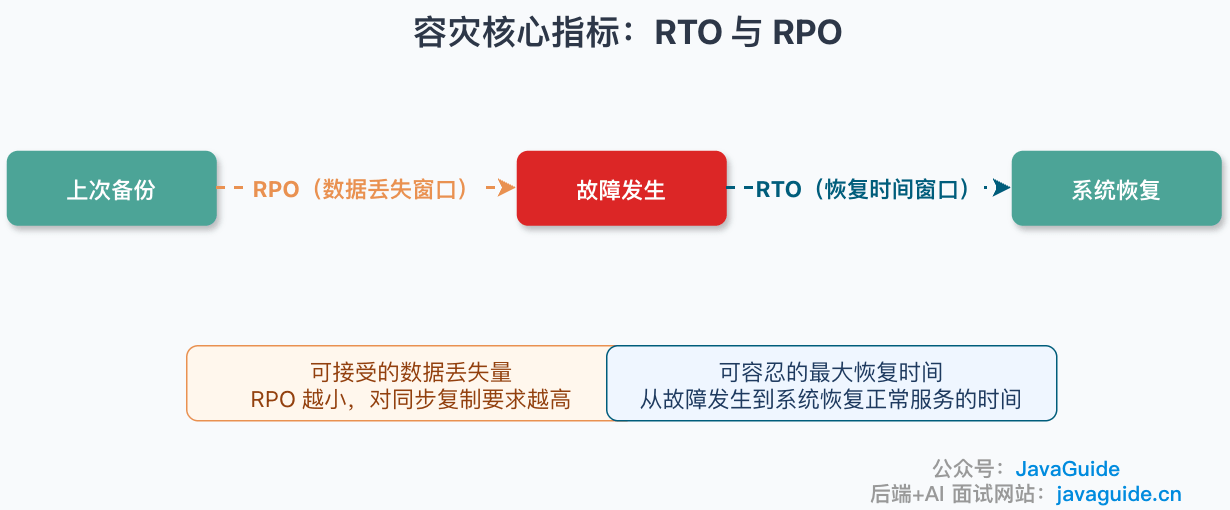
- RPO (Recovery Point Objective, mục tiêu điểm khôi phục): khoảng mất data có thể chấp nhận sau khi thảm họa xảy ra, cũng có thể hiểu là khi khôi phục, data được phép quay về tối đa bao lâu trước đó. RPO càng nhỏ thì yêu cầu về synchronous replication, log replication, consistency giữa các site và write latency càng cao. RPO = 0 thường có nghĩa là write phải được xác nhận ở nhiều failure domain trước khi trả kết quả, hoặc phải có cơ chế commit strong consistency tương đương; cái giá là write latency tăng và khi xảy ra network partition, phải đánh đổi giữa availability và consistency.
- RTO (Recovery Time Objective, mục tiêu thời gian khôi phục): thời gian khôi phục tối đa có thể chịu đựng, tức thời gian từ khi sự cố xảy ra đến khi hệ thống khôi phục service bình thường. RTO=0 nghĩa là về mục tiêu không được có gián đoạn có thể cảm nhận, nhưng trong hệ thống thực tế thường diễn đạt là gần 0 hoặc chuyển đổi mà người dùng không nhận biết; vẫn cần xét failure detection, traffic switching và hành vi retry của client.
RTO/RPO là mục tiêu, không phải kết quả. Đây là ràng buộc của business đối với năng lực disaster recovery; năng lực khôi phục thực tế phụ thuộc vào tốc độ failure detection, mức độ tự động hóa chuyển đổi, replication lag, quy trình thủ công và năng lực vận hành. Tuyên bố một RPO/RTO nào đó không có nghĩa production environment chắc chắn đạt được; phải xác minh bằng recovery drill và stress test định kỳ. Ngoài ra, các business flow khác nhau có thể có yêu cầu RTO/RPO khác nhau, không nhất thiết toàn site phải thống nhất.
RPO/RTO dưới đây là mức tham khảo trong cấu hình điển hình. Kết quả thực tế phụ thuộc vào cách replication (synchronous/asynchronous), ngưỡng failure detection, mức độ tự động hóa chuyển đổi và năng lực vận hành của team. Multi-active có đạt được RTO/RPO ở mức giây hay không phụ thuộc vào traffic scheduling, data replication, failure detection, client retry, conflict resolution và mức độ trưởng thành của recovery drill.
| Architecture | RPO | RTO | Chi phí |
|---|---|---|---|
| Single machine không backup | Có thể mất toàn bộ | Không thể ước tính | Thấp |
| Local backup | Phụ thuộc chu kỳ backup | Mức giờ | Thấp |
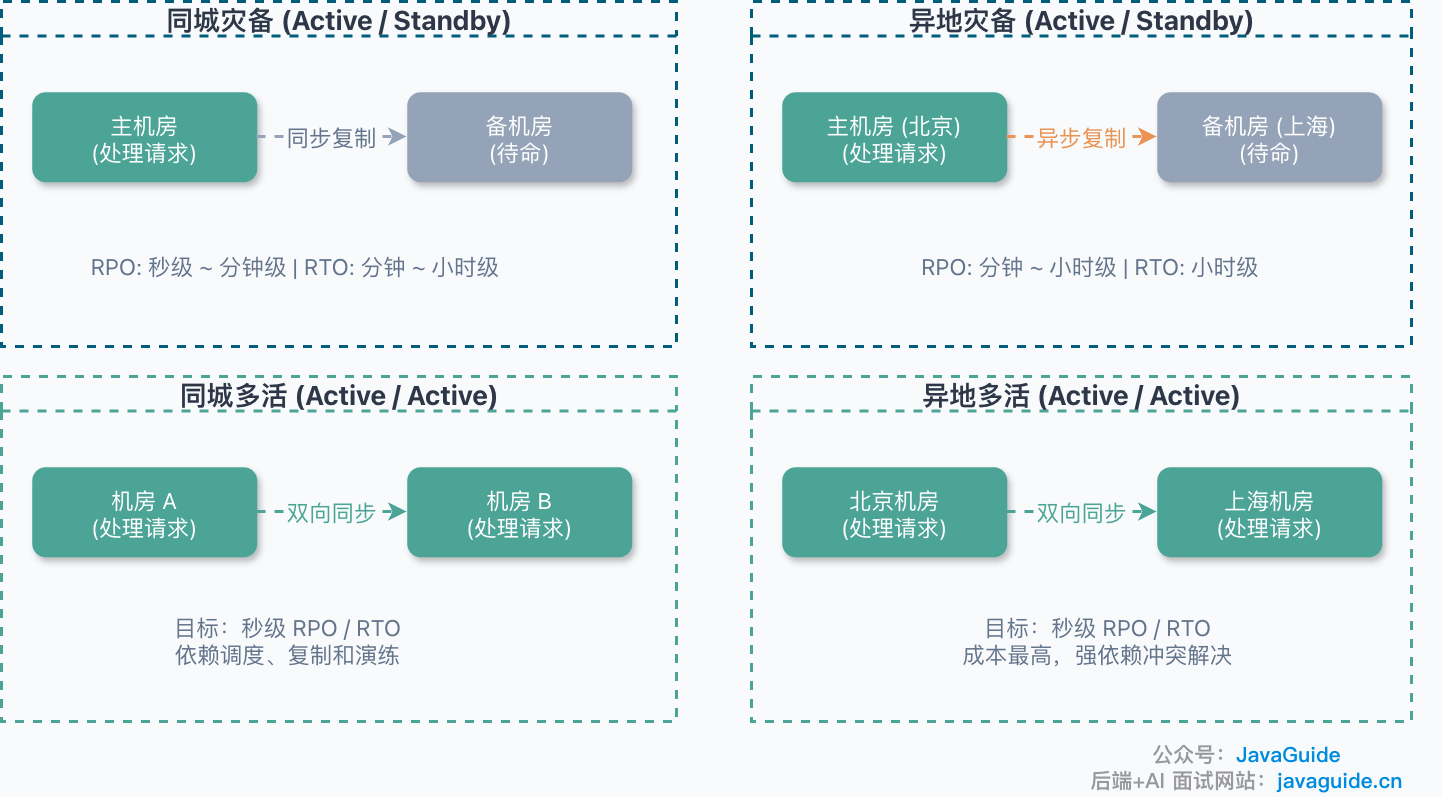
| Same-city disaster recovery | Mức giây~phút | Mức phút~giờ | Trung bình |
| Geo-disaster recovery | Mức phút~giờ | Mức giờ | Trung bình đến cao |
| Same-city multi-active | Mức giây | Mức giây | Cao |
| Geo multi-active | Mức giây | Mức giây | Rất cao |
So sánh các redundancy architecture
High Availability Cluster (viết tắt là HA Cluster), same-city disaster recovery, geo-disaster recovery, same-city multi-active và geo multi-active là những ứng dụng điển hình nhất của tư tưởng redundancy trong high availability system design.
High availability cluster
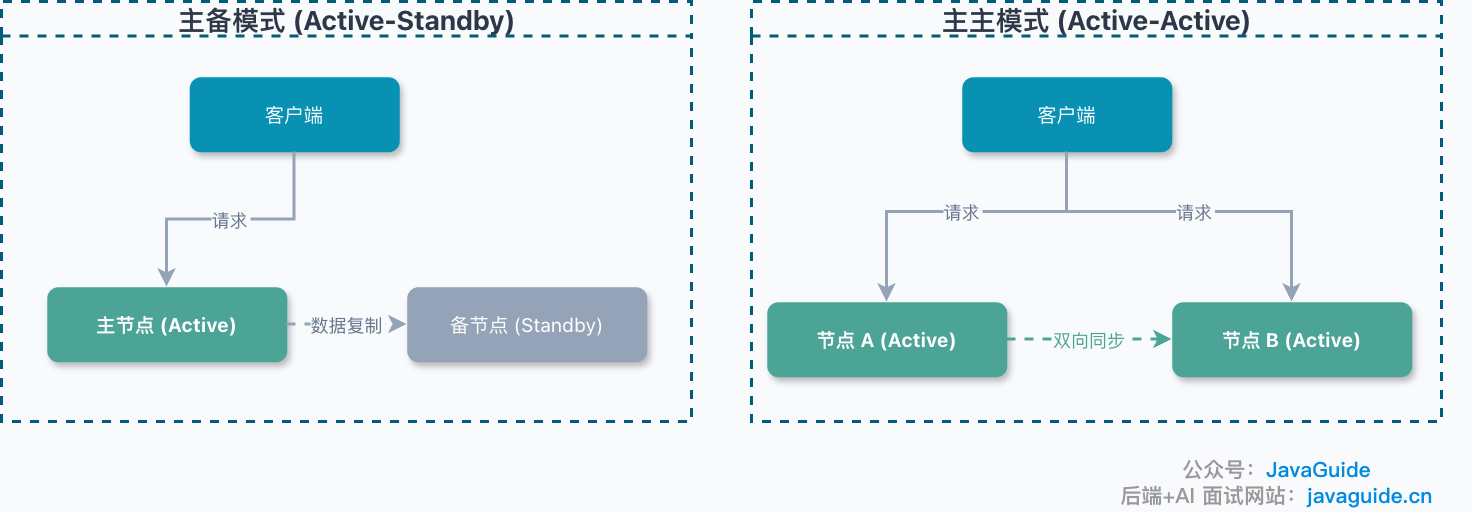
High availability cluster là việc triển khai hai hoặc nhiều instance của cùng một service. Khi service đang được sử dụng đột ngột dừng hoạt động, hệ thống có thể chuyển sang service khác để bảo đảm high availability của service.
High availability cluster có hai mode phổ biến:
| Mode | Mô tả | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Active-Standby | Primary node cung cấp service, standby node chờ | Dễ triển khai, dễ kiểm soát single-primary write | Resource utilization thấp, standby node nhàn rỗi |
| Active-Active | Nhiều node cùng cung cấp service | Resource utilization cao, không có single point of failure | Write conflict cần được giải quyết ở application layer; auto-increment ID, unique constraint có thể xung đột |
Active-standby thường dễ kiểm soát write path hơn. Nếu là synchronous replication, consistency tốt hơn nhưng write latency cao hơn; nếu là asynchronous replication, khi chuyển đổi có thể mất data chưa kịp replication. High availability cluster chỉ đơn thuần là redundancy của service, không nhấn mạnh yếu tố địa lý. Same-city disaster recovery, geo-disaster recovery, same-city multi-active và geo multi-active mới thực hiện redundancy về địa lý.
Same-city disaster recovery
Same-city disaster recovery không phải đơn giản là triển khai redundancy của service trong cùng một data center, mà là triển khai primary service và standby service ở các data center khác nhau trong cùng một thành phố. Same-city disaster recovery thường chỉ site primary và standby nằm ở các data center khác nhau trong cùng thành phố, với hình thức phổ biến là active/passive: primary site xử lý production traffic, standby site bình thường không nhận traffic hoặc chỉ nhận một lượng nhỏ traffic để xác minh, khi có sự cố sẽ tiếp quản. Là cold standby, warm standby hay hot standby phụ thuộc vào chi phí và yêu cầu RTO.
Cách này tránh việc service hoàn toàn không khả dụng khi một data center gặp sự cố như mất điện hoặc hỏa hoạn.
- Trường hợp sử dụng: doanh nghiệp có yêu cầu RTO cao (mức phút) nhưng ngân sách giới hạn.
- Cấu hình điển hình: khoảng cách và latency giữa hai data center trong cùng thành phố không có tiêu chuẩn thống nhất; thường cần đánh giá dựa trên latency của dedicated line, sự tách biệt failure domain, tính độc lập của nguồn điện và route nhà mạng. Synchronous replication có chấp nhận được hay không phải căn cứ vào RTT thực tế và ngân sách write latency.
Geo-disaster recovery
Geo-disaster recovery tương tự same-city disaster recovery, điểm khác là cùng một service được triển khai ở các data center khác nhau tại khu vực khác (thường cách xa nhau, thậm chí ở các thành phố hoặc quốc gia khác nhau).
- Trường hợp sử dụng: core business system cần phòng ngừa thảm họa trên diện rộng (động đất, lũ lụt).
- Thách thức: network latency lớn, data synchronization thường dùng asynchronous replication nên có thể mất data.
Same-city multi-active
Same-city multi-active tương tự same-city disaster recovery nhưng không còn phân biệt thuần túy primary và standby. Nhiều data center trong cùng thành phố đều có thể nhận production traffic, nhờ đó tận dụng đầy đủ system resource và nâng cao concurrency của hệ thống.
- Trường hợp sử dụng: hệ thống yêu cầu cao cả về performance lẫn availability.
- Điểm kỹ thuật chính: cần giải quyết các vấn đề như data synchronization, traffic scheduling và session management.
Geo multi-active
Geo multi-active triển khai service ở các data center khác nhau tại những khu vực khác nhau, đồng thời các data center này có thể cùng cung cấp service ra bên ngoài.
So với disaster recovery design truyền thống, thay đổi rõ ràng nhất của same-city multi-active và geo multi-active nằm ở "multi-active", tức tất cả site đều đồng thời cung cấp service ra bên ngoài. Geo multi-active nhằm ứng phó với các tình huống đột xuất như hỏa hoạn, động đất và các thảm họa tự nhiên hoặc do con người, cũng như network outage trên diện rộng, sự cố cấp data center và yêu cầu compliance.
Khác biệt chính giữa cùng thành phố và khác khu vực là khoảng cách giữa các data center. Khác khu vực thường cách xa hơn, thậm chí ở các thành phố hoặc quốc gia khác nhau.
Cấp độ cold standby / warm standby / hot standby / multi-active
Xét theo cấp độ disaster recovery, có thể hình thành một phổ liên tục từ thấp đến cao như sau:
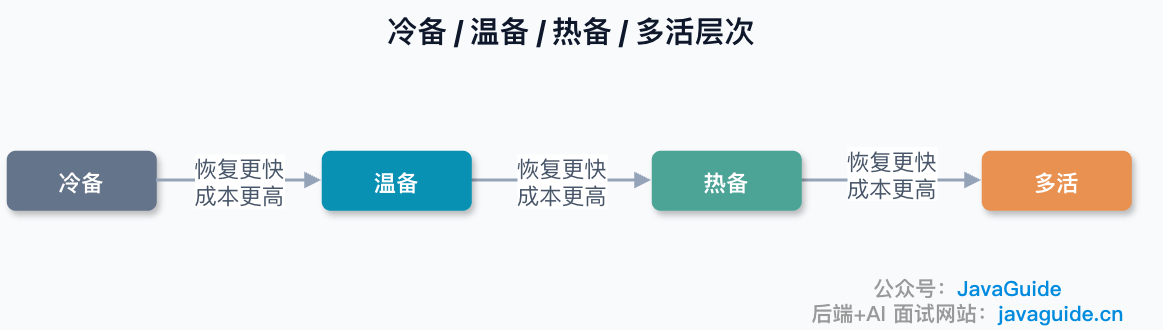
| Cấp độ disaster recovery | Trạng thái resource | Tốc độ khôi phục | Chi phí | Trường hợp điển hình |
|---|---|---|---|---|
| Cold standby | Standby resource chưa chạy, cần khởi động thủ công | Mức giờ~ngày | Thấp | Non-core business |
| Warm standby | Một phần resource chạy thường trực, cần scale up để tiếp quản | Mức phút | Trung bình | Disaster recovery cho business thông thường |
| Hot standby | Resource và data được đồng bộ liên tục, có thể chuyển đổi nhanh | Mức giây~phút | Cao | Core business |
| Multi-active | Nhiều site cùng nhận production traffic | Gần realtime | Rất cao | Core business có yêu cầu cực cao về availability |
Các business khác nhau có thể dùng cấp độ khác nhau, không cần toàn hệ thống đều theo đuổi multi-active. Điểm mấu chốt là cân nhắc dựa trên phạm vi ảnh hưởng của business, xác suất sự cố và chi phí xây dựng.
Cơ chế failover
Chỉ có redundancy là chưa đủ, còn cần kết hợp với cơ chế failover. Nói đơn giản, failover là nhanh chóng chuyển traffic từ failed node sang healthy node.
Failover có thể tự động, hoặc do con người xác nhận sau khi hệ thống tự động phát hiện. Với stateless service và cache system, thông thường sẽ ưu tiên tự động chuyển đổi. Với các tình huống rủi ro cao như database primary switch, traffic switching giữa các khu vực và money flow, nhiều team vẫn giữ bước xác nhận hoặc phê duyệt thủ công.
Failover thường gồm các bước sau:
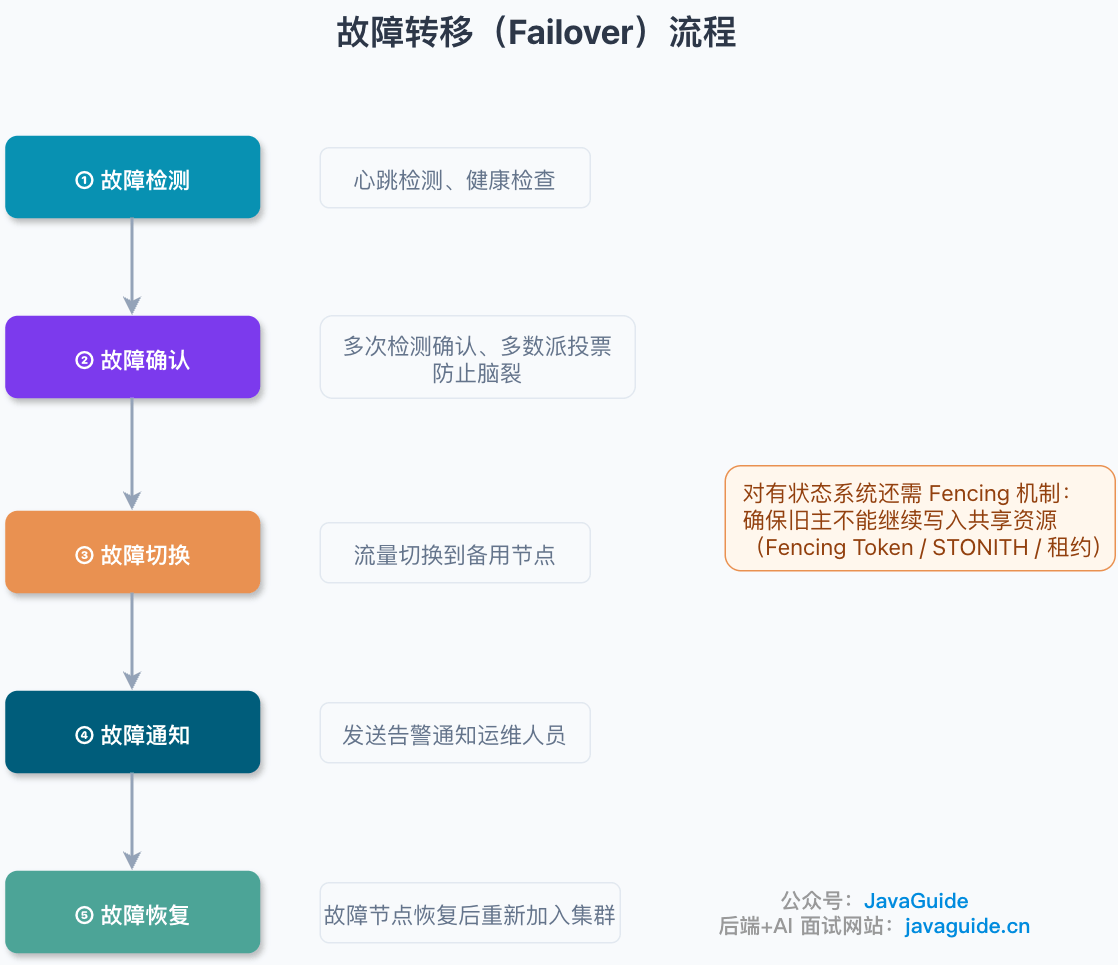
- Failure detection: phát hiện failed node thông qua heartbeat check, health check và các cơ chế khác. Ngưỡng detection cần cân bằng giữa false positive và false negative; quá nhạy dễ chuyển đổi nhầm, quá thận trọng sẽ kéo dài thời gian sự cố.
- Failure confirmation: tránh phán đoán nhầm; thường cần nhiều lần detection để xác nhận, đồng thời dùng majority vote, arbitration node hoặc lease để ngăn split-brain.
- Failure switching: chuyển traffic sang standby node.
- Failure notification: gửi alert cho nhân viên vận hành.
- Failure recovery: sau khi failed node khôi phục, cho node đó gia nhập cluster trở lại.
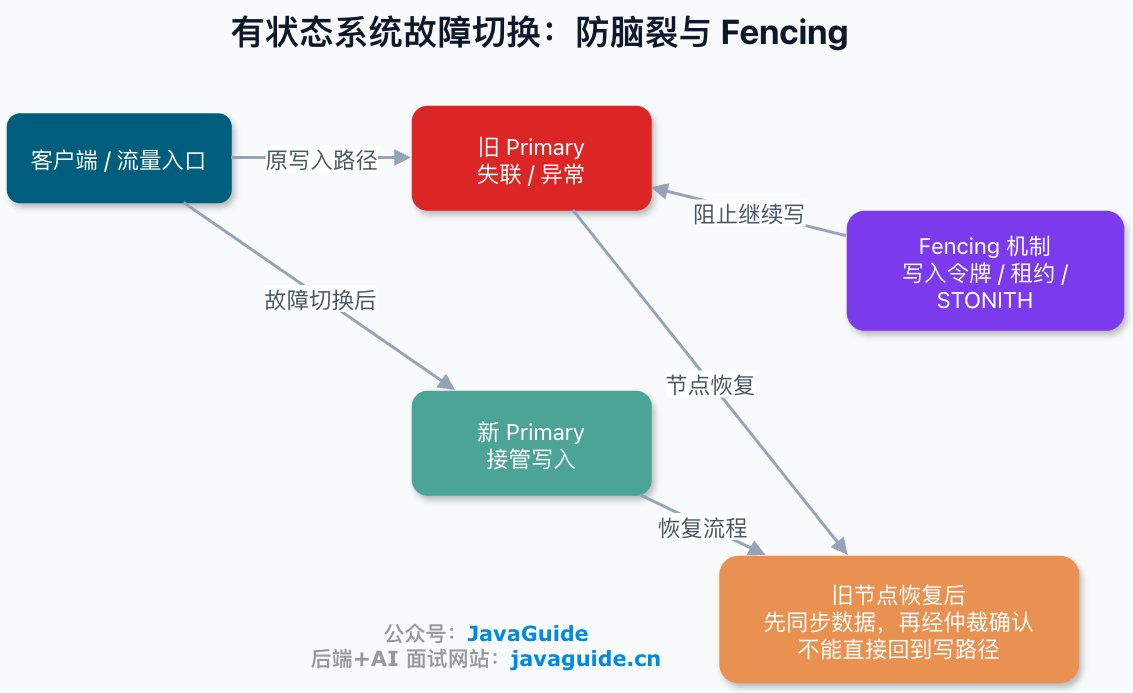
Với stateful system, còn cần fencing mechanism để bảo đảm old primary không thể tiếp tục ghi vào shared resource sau khi mất kết nối hoặc khôi phục. Nếu không, ngay cả khi new primary đã chuyển đổi thành công, vẫn có thể xảy ra dual-primary write và split-brain. Các cách thường dùng gồm fencing token, STONITH (Shoot The Other Node In The Head), write token và lease. Sau khi khôi phục, old primary không được trực tiếp gia nhập write path trở lại; trước hết cần đồng bộ data và được arbitration xác nhận.
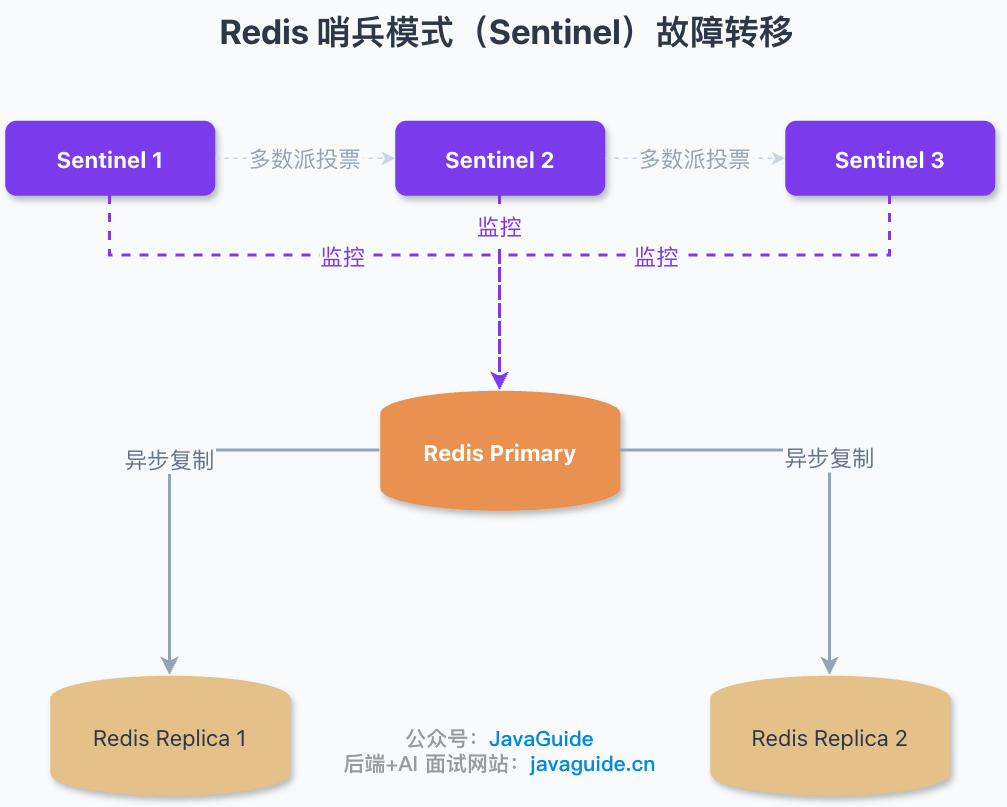
Ví dụ Redis Sentinel mode
Redis Sentinel có thể monitor primary (trong tài liệu cũ cũng thường gọi là master). Sau khi đa số Sentinel xác định primary bị lỗi, Sentinel sẽ bầu chọn và promote một replica (trong tài liệu cũ cũng thường gọi là slave) thành primary mới; tuy nhiên Redis Sentinel không bảo đảm RPO=0. Do Redis replication thường là asynchronous, khi failover có thể mất data chưa kịp replication sang replica.
Trong production, thường triển khai ít nhất 3 Sentinel. Cần lưu ý quorum chỉ biểu thị số Sentinel đồng ý rằng primary đã objective down; việc thực sự khởi động failover còn liên quan đến majority của Sentinel và leader election. Vì vậy, không nên hiểu đơn giản quorum là một nửa tổng số Sentinel. Cần chú ý các parameter như down-after-milliseconds (sau bao lâu instance không thể truy cập thì được xem là down), failover-timeout (thời gian timeout của failover).
Khi dùng Redis Sentinel trong production environment, nên theo dõi các metric sau:
| Nhóm metric | Metric cụ thể |
|---|---|
| Replication lag | replication lag của replica so với primary |
| Failure detection | Số lần trigger down-after-milliseconds |
| Thời gian chuyển đổi | Thời gian từ lúc trigger failover đến khi hoàn tất |
| Client perception | Thời gian client reconnect, tỷ lệ write failure trong lúc primary-standby switch |
| Cluster status | Trạng thái Sentinel quorum / majority, trạng thái sống của Sentinel node |
Ví dụ Nginx + Keepalived
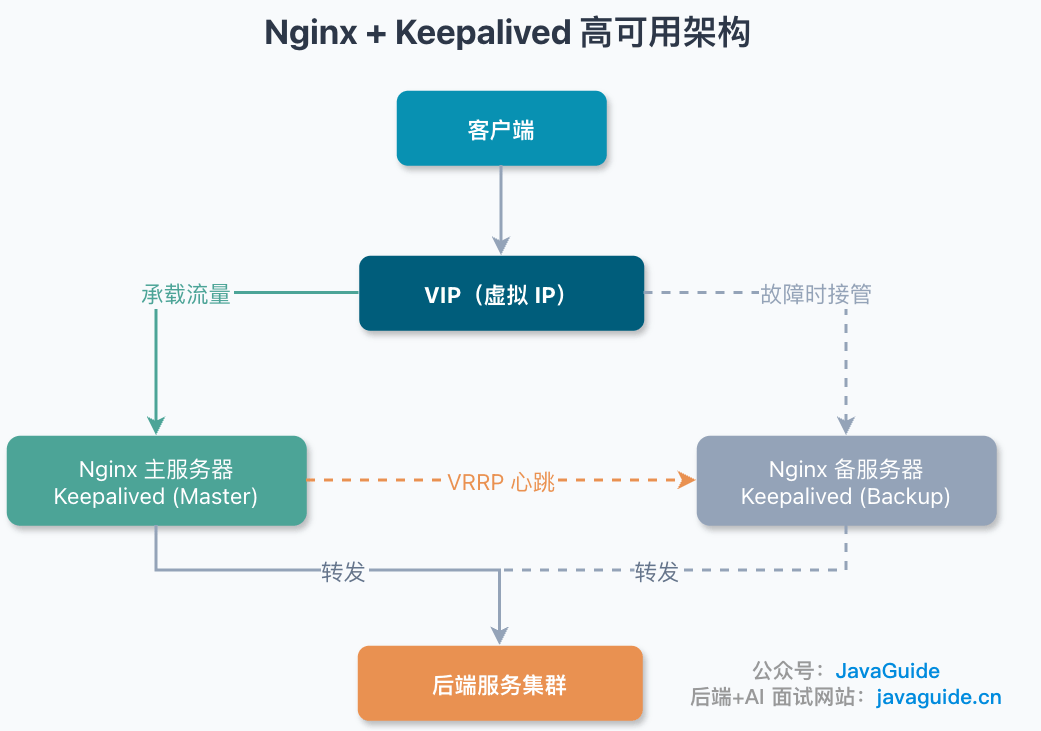
Nginx có thể kết hợp với Keepalived để triển khai high availability. Keepalived dùng VRRP để quản lý VIP, cho phép VIP di chuyển giữa primary và standby node, giải quyết vấn đề high availability của entry IP. Nếu Nginx primary server dừng hoạt động, Keepalived có thể tự động failover dựa trên VRRP protocol, đưa standby Nginx server lên làm primary service. Do sử dụng virtual IP (VIP), IP đối ngoại không thay đổi.
Cần lưu ý:
- Keepalived không bảo đảm các TCP connection hiện có được di chuyển không mất mát; việc chuyển đổi còn chịu ảnh hưởng của ARP / neighbor table refresh, layer-2 network, hỗ trợ VIP của cloud provider và health check script.
- Phù hợp với VIP migration trong cùng một data center hoặc cùng layer-2 network, không phù hợp để trực tiếp giải quyết traffic scheduling giữa các khu vực.
- Trong cloud environment, cần xác nhận có hỗ trợ custom VIP và ARP / route switching hay không.
- Health check script phải kiểm tra Nginx process và business port, không chỉ kiểm tra chính Keepalived process.
- Trong production, còn cần chọn preempt hoặc non-preempt mode theo business để tránh chuyển đổi lần hai không cần thiết sau khi primary node khôi phục.
Thách thức của geo multi-active
Việc triển khai geo multi-active architecture rất khó và cần cân nhắc nhiều yếu tố:
| Thách thức | Mô tả | Hướng giải quyết |
|---|---|---|
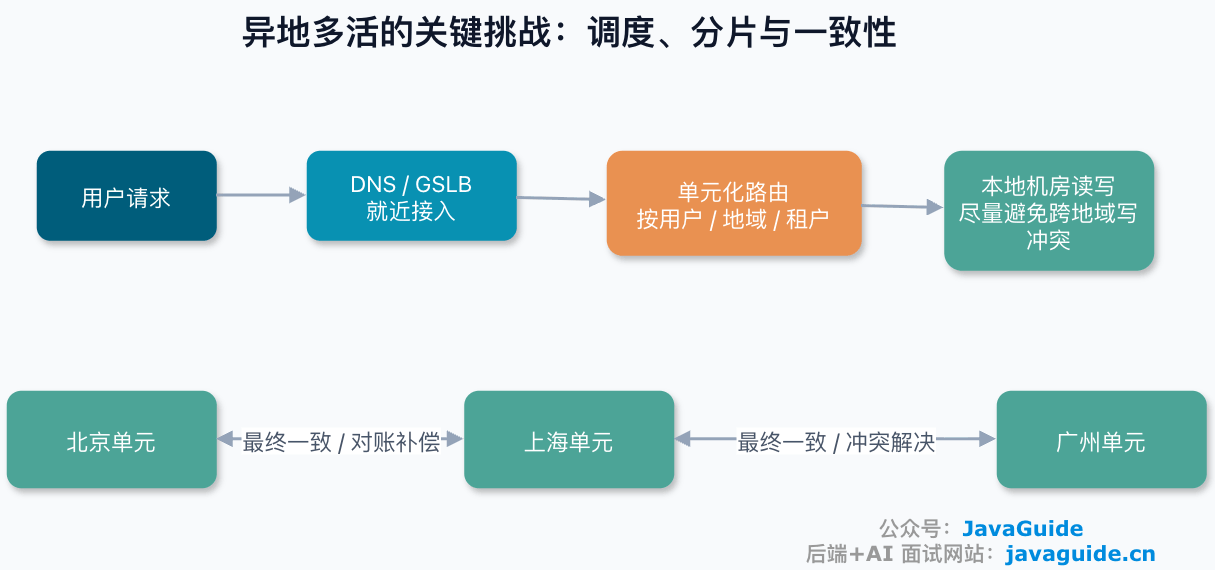
| Data consistency | Làm thế nào để data ở nhiều data center nhất quán | Unit-based routing, eventual consistency, TCC/Saga, conflict resolution mechanism |
| Network latency | Network latency giữa các data center khác khu vực lớn | Kết nối gần nhất, data partition |
| Traffic scheduling | Phân phối user request đến data center phù hợp | Intelligent DNS resolution, GSLB |
| Session management | Chia sẻ user session giữa nhiều data center như thế nào | Ưu tiên stateless design hoặc route theo user unit, cố định về cùng một site; chia sẻ session giữa các khu vực tuy khả thi nhưng sẽ thêm latency, consistency issue và vấn đề failure isolation |
| Chi phí | Chi phí xây dựng và vận hành nhiều data center cao | Phân cấp triển khai theo mức độ quan trọng của business |
Trade-off cốt lõi của geo multi-active có thể được hiểu bằng CAP: network latency và partition giữa các khu vực là không thể tránh, hệ thống phải đánh đổi giữa strong consistency và availability. Tuy nhiên, khó khăn engineering của geo multi-active không chỉ giới hạn ở CAP, mà còn gồm latency giữa các khu vực, traffic scheduling, data sharding, conflict resolution, chi phí, compliance và độ phức tạp của recovery drill. Cách làm phổ biến là sharding theo user hoặc khu vực thành các unit, để phần lớn read/write nằm trong cùng một data center; thao tác giữa các unit được bảo đảm eventual consistency thông qua TCC / Saga, reconciliation compensation hoặc business conflict resolution.
Không phải business nào cũng cần geo multi-active. Cần thận trọng đánh giá các loại business sau:
- Business có strong consistency write thường xuyên và nhiều conflict giữa các khu vực
- Data model không thể chia theo user / khu vực / tenant
- Money flow thiếu năng lực reconciliation compensation
- Team không có recovery drill và năng lực vận hành hỗ trợ
- Hệ thống có chi phí xây dựng cao hơn mức thiệt hại do sự cố dự kiến
Thông thường cần đánh giá tổng hợp dựa trên phạm vi ảnh hưởng của business, xác suất sự cố và chi phí xây dựng.
Nếu muốn học sâu hơn về geo multi-active, có thể tham khảo các tài liệu sau:
- Tìm hiểu geo multi-active, đọc bài này là đủ - Waterdrop and Silver Bullet - 2021
- Xây dựng geo multi-active qua bốn bước
- 《Học system design từ con số 0》— 28 | Bảo đảm high availability cho business: geo multi-active architecture
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.