
Dù là website mua sắm bạn thường truy cập, dịch vụ thanh toán online bạn sử dụng hay hệ thống nghiệp vụ cốt lõi trong công ty, người dùng ngày càng khó chấp nhận việc "dịch vụ không khả dụng". Một sự cố kéo dài vài phút có thể khiến nhiều người dùng rời bỏ dịch vụ, thậm chí gây thiệt hại kinh tế trực tiếp.
Vì vậy, làm thế nào để hệ thống vẫn cung cấp dịch vụ ổn định trong nhiều tình huống bất thường đã trở thành vấn đề không thể tránh trong phát triển backend và thiết kế kiến trúc. Bài viết này tổng hợp các tư duy cốt lõi và giải pháp thường gặp khi thiết kế hệ thống High Availability, gồm chỉ số SLA, xử lý single point of failure, rate limiting/circuit breaker, service degradation, cache High Availability, xử lý bất đồng bộ để dàn đều tải, redundancy/disaster recovery, gray release và khôi phục sự cố.
High Availability là gì? Tiêu chuẩn đánh giá availability là gì?
High Availability (viết tắt là HA) là khả năng hệ thống liên tục cung cấp dịch vụ bình thường trong phần lớn thời gian. High Availability nghĩa là dịch vụ vẫn khả dụng ngay cả khi hệ thống gặp lỗi phần cứng hoặc đang được nâng cấp.
Thông thường, chúng ta dùng các mức 9 để đánh giá availability của hệ thống. Ví dụ, 99.9999% nghĩa là trong toàn bộ thời gian vận hành, hệ thống chỉ không khả dụng 0.0001% thời gian; đây là một hệ thống có High Availability rất cao. Hệ thống có availability kém có thể còn chưa đạt 90% (1 mức 9).
| Mức availability | Tỷ lệ availability | Thời gian downtime mỗi năm | Trường hợp điển hình |
|---|---|---|---|
| 1 mức 9 | 90% | 36,5 ngày | Blog cá nhân |
| 2 mức 9 | 99% | 3,65 ngày | Hệ thống doanh nghiệp thông thường |
| 3 mức 9 | 99,9% | 8,76 giờ | Dịch vụ online |
| 4 mức 9 | 99,99% | 52,6 phút | Hệ thống giao dịch tài chính |
| 5 mức 9 | 99,999% | 5,26 phút | Hệ thống cấp viễn thông |
Ngoài ra, availability của hệ thống còn có thể được đo bằng tỷ lệ giữa số lần một chức năng thất bại và tổng số request. Ví dụ, trong 1.000 request đến website có 10 request thất bại thì availability là 99%.
SLA (Service Level Agreement, thỏa thuận mức dịch vụ) là cam kết chính thức giữa nhà cung cấp dịch vụ và khách hàng, thường quy định rõ mục tiêu availability. Ví dụ, nhà cung cấp cloud cam kết SLA 99,95%, nghĩa là mỗi tháng chỉ cho phép downtime tối đa khoảng 22 phút.
Những tình huống nào khiến hệ thống không khả dụng?
Nguyên nhân khiến hệ thống không khả dụng có thể được phân tích theo hai khía cạnh yếu tố nội bộ và yếu tố bên ngoài:
Yếu tố nội bộ:
- Lỗi code: Các vấn đề về chất lượng code như memory leak, deadlock, circular dependency, null pointer exception là một trong những nguyên nhân phổ biến nhất gây ra sự cố production.
- Lỗi thiết kế kiến trúc: Các vấn đề kiến trúc như single point of failure, thiếu cơ chế bảo vệ rate limiting, coupling chặt giữa các service sẽ bộc lộ khi traffic đạt đỉnh.
- Cạn kiệt resource: Cạn kiệt các resource như CPU, memory, disk, connection pool có thể trực tiếp khiến service không khả dụng.
- Sai cấu hình: Thay đổi cấu hình sai, chẳng hạn connection string của database hoặc cấu hình timeout không phù hợp, có thể khiến service bất thường.
Yếu tố bên ngoài:
- Lỗi phần cứng: Server bị down, disk hỏng, thiết bị mạng gặp lỗi và các tình huống tương tự.
- Traffic tăng đột biến: Lượng request đột ngột từ người dùng, chẳng hạn trong sự kiện flash sale, vượt quá khả năng chịu tải của hệ thống.
- Tấn công mạng: Các cuộc tấn công độc hại như DDoS, CC có thể làm cạn kiệt resource của hệ thống.
- Lỗi service phụ thuộc: Các service phụ thuộc như database, cache, message queue, API bên thứ ba không khả dụng.
- Thiên tai: Các yếu tố bất khả kháng như mất điện tại data center, hỏa hoạn, động đất.
Có những cách nào để nâng cao availability của hệ thống?
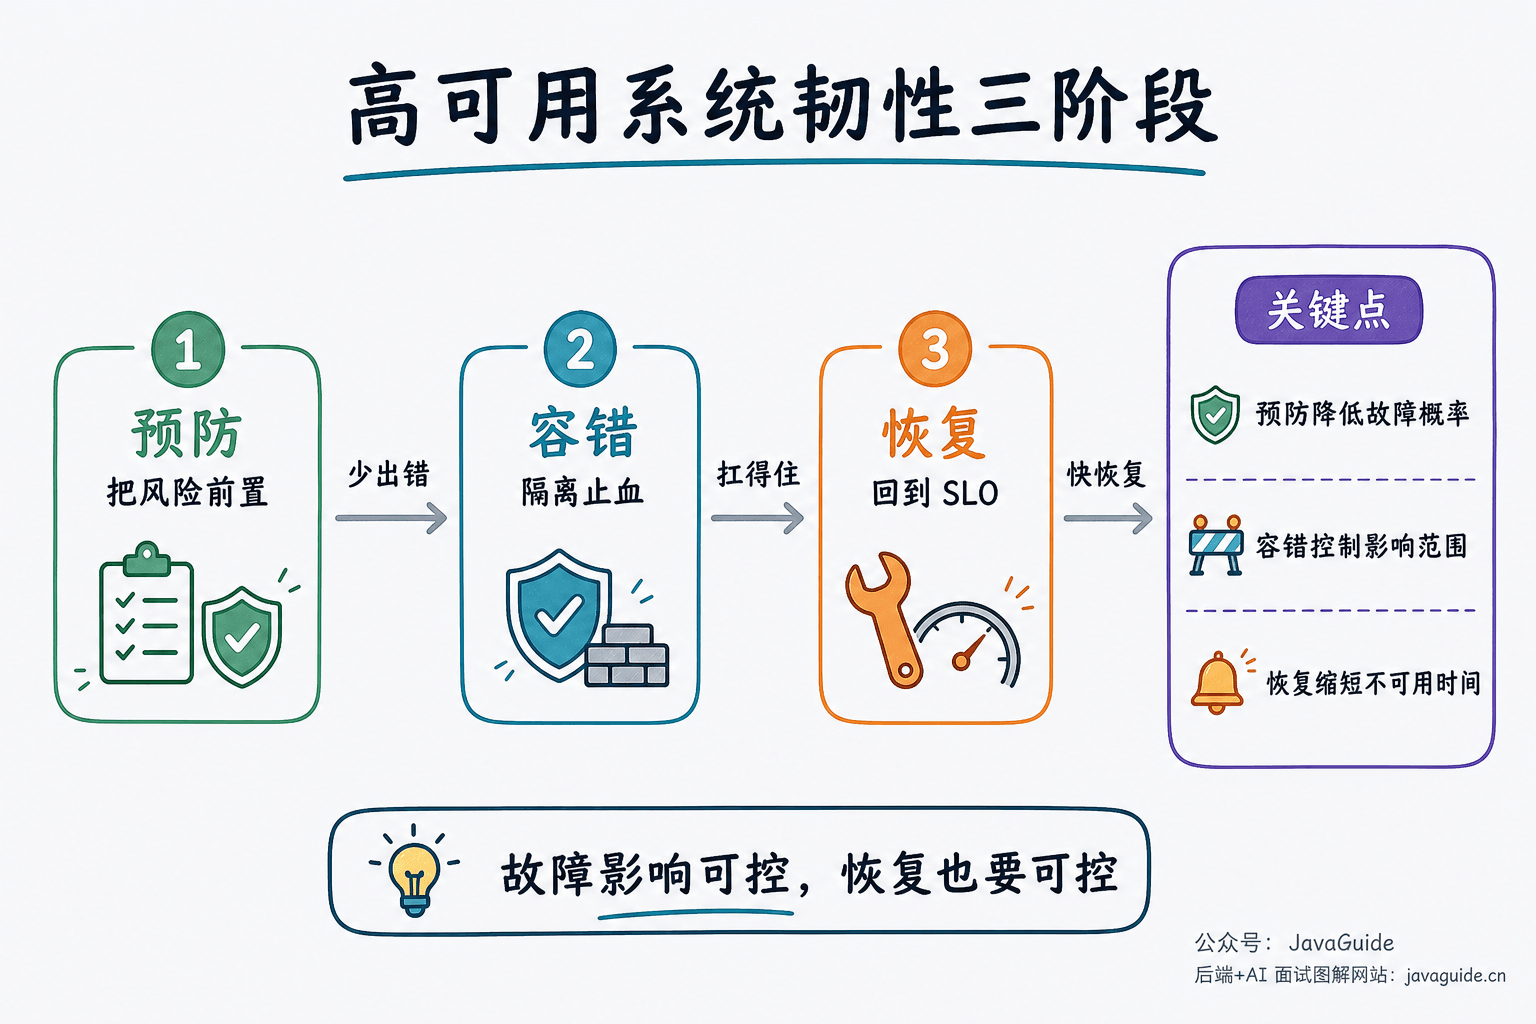
Các cách nâng cao availability của hệ thống có thể được xem xét theo ba giai đoạn phòng ngừa, fault tolerance và khôi phục:
Chú trọng chất lượng code, kiểm thử nghiêm ngặt
Chất lượng code là nền tảng của availability hệ thống. Các vấn đề khá phổ biến như memory leak và circular dependency gây tổn hại lớn đến availability. Mọi người thường nói về rate limiting, degradation, circuit breaker, nhưng kiểm soát chất lượng code ngay từ đầu cũng là việc rất quan trọng cần làm trước tiên.
Làm thế nào để nâng cao chất lượng code? Cách thực tế và hiệu quả là Code Review. Đừng quá để tâm đến khoảng 1 giờ phải dành thêm mỗi ngày; tác dụng của việc này rất đáng kể!
Ngoài ra, dưới đây là một số công cụ thực sự hiệu quả trong việc nâng cao chất lượng code:
- SonarQube: Nền tảng static code analysis, có thể phát hiện code smell, lỗ hổng bảo mật và Bug.
- Công cụ chẩn đoán Java mã nguồn mở của Alibaba là Arthas: Có thể kiểm tra vấn đề JVM trực tiếp trên production và hỗ trợ hot update code.
- Quy chuẩn code Java của Alibaba (Alibaba Java Code Guidelines): Plugin cho IDEA, kiểm tra quy chuẩn code theo thời gian thực.
- Các công cụ phân tích code tích hợp sẵn trong IDEA.
Sử dụng cluster để giảm single point of failure
Single Point of Failure (SPOF) là kẻ thù lớn của High Availability. Lấy Redis cache làm ví dụ: sử dụng cluster mode để tránh single point of failure là biện pháp then chốt bảo đảm High Availability.
Khi dùng một Redis instance làm cache, nếu instance đó bị down thì toàn bộ cache service có thể không khả dụng. Sau khi dùng cluster, ngay cả khi một Redis instance bị down, các instance khác vẫn có thể tiếp quản thông qua failover. Thời gian chuyển đổi phụ thuộc vào deployment mode và cấu hình tham số; Redis Sentinel/Cluster thường cần từ vài giây đến vài chục giây, không nên hiểu đơn giản là “chưa đến một giây”.
Các cluster mode thường gặp:
- Master-Slave replication: Một master, nhiều slave; master phụ trách write, slave phụ trách read. Khi master gặp lỗi, cần failover thủ công hoặc nhờ Sentinel.
- Sentinel mode: Bổ sung các Sentinel node trên nền tảng Master-Slave replication để tự động phát hiện và chuyển đổi khi có lỗi.
- Redis Cluster mode: Giải pháp data sharding được Redis 3.0+ chính thức hỗ trợ. Mỗi shard có replica master-slave, vừa bảo đảm High Availability vừa hỗ trợ mở rộng theo chiều ngang.
Rate limiting
Rate limiting là tuyến phòng thủ đầu tiên để bảo vệ hệ thống. Nguyên lý là giám sát các chỉ số như QPS hoặc số thread concurrent của application. Khi đạt threshold đã định, traffic sẽ được kiểm soát để tránh bị đỉnh traffic tức thời làm sập, từ đó bảo đảm availability của application. — theo wiki của alibaba-Sentinel.
Các thuật toán rate limiting thường gặp gồm:
- Fixed window counter: Dễ triển khai nhưng có vấn đề traffic spike tại điểm chuyển tiếp.
- Sliding window counter: Giải quyết vấn đề tại điểm chuyển tiếp của fixed window và mượt hơn.
- Leaky bucket: Xử lý request với tốc độ cố định, phù hợp để traffic shaping.
- Token bucket: Cho phép traffic burst ở mức độ nhất định, linh hoạt hơn.
Thiết lập cơ chế timeout và retry
Khi request của người dùng không nhận được phản hồi sau một khoảng thời gian nhất định, hệ thống sẽ ném exception. Đây là việc rất quan trọng; nhiều sự cố production xảy ra do không thiết lập timeout hoặc thiết lập timeout không đúng cách.
Khi gọi service bên thứ ba, đặc biệt nên thiết lập cơ chế timeout và retry. Các framework RPC thường tích hợp sẵn cấu hình timeout và retry. Nếu không thiết lập timeout, request có thể phản hồi chậm, thậm chí bị dồn ứ khiến hệ thống không thể tiếp tục xử lý request.
Số lần retry thường được đặt là 3, retry nhiều hơn không những không có lợi mà còn làm tăng áp lực lên server. (Một số trường hợp không phù hợp với cơ chế retry khi thất bại.) Đồng thời, retry cần kết hợp với chiến lược exponential backoff để tránh retry storm.
Đặc biệt cần lưu ý rằng API được retry phải có tính idempotent. Với các thao tác write không idempotent như tạo order hoặc trừ tiền, cần dùng request ID duy nhất, business unique key, state machine và các cách khác để ngăn thực thi trùng lặp, thay vì đơn giản gửi lại request thất bại. Có thể retry read tích cực hơn; trước khi retry write, tốt nhất nên kiểm tra request trước đó đã có hiệu lực hay chưa.
Circuit breaker
Ngoài việc thiết lập cơ chế timeout và retry, circuit breaker cũng rất quan trọng. Circuit breaker tự động thu thập tình trạng sử dụng resource và các chỉ số performance của service phụ thuộc. Khi service phụ thuộc suy giảm hoặc số lần call thất bại đạt threshold, circuit breaker chuyển sang trạng thái Open; các request tiếp theo sẽ fail nhanh mà không call downstream, tránh để sự cố tiếp tục lan rộng. Circuit breaker thường kết hợp với chiến lược degradation, chẳng hạn trả về dữ liệu dự phòng hoặc gọi service dự phòng.
Circuit breaker có ba trạng thái:
- Closed: Trạng thái bình thường, request đi qua như thường.
- Open: Trạng thái circuit breaker, request fail ngay và không call downstream.
- Half-Open: Trạng thái thử khôi phục, cho phép một lượng nhỏ request đi qua để kiểm tra downstream đã khôi phục hay chưa.
Trong lịch sử, các framework kiểm soát traffic và circuit breaker/degradation được sử dụng rộng rãi gồm Netflix Hystrix (đã chuyển sang maintenance mode) và Alibaba Sentinel. Với project mới, thông thường nên ưu tiên Sentinel hoặc Resilience4j.
Degradation
Degradation là tạm thời tắt một số chức năng non-core khi hệ thống chịu áp lực quá lớn hoặc một phần service không khả dụng, nhằm bảo đảm availability của chức năng cốt lõi.
Các chiến lược degradation gồm:
- Functional degradation: Tắt các chức năng non-core như recommendation và comment.
- Data degradation: Trả về dữ liệu cache hoặc dữ liệu mặc định thay vì query theo thời gian thực.
- Page degradation: Trả về static page hoặc page phiên bản đơn giản.
Gọi bất đồng bộ
Gọi bất đồng bộ nghĩa là sau khi caller gửi request, caller không block để chờ kết quả xử lý mà trả về ngay; phần xử lý cụ thể có thể thực hiện sau. Cách này được dùng khá nhiều trong các kịch bản flash sale.
Tuy nhiên, sau khi sử dụng bất đồng bộ, có thể cần điều chỉnh business flow cho phù hợp. Ví dụ, sau khi người dùng submit order, không thể lập tức trả về rằng submit order thành công; cần chờ consumer xử lý order trong message queue, thậm chí chờ xuất kho, rồi mới thông báo order thành công qua email hoặc SMS.
Ngoài việc triển khai bất đồng bộ trong application, chúng ta thường sử dụng message queue. Message queue có thể nâng cao performance của hệ thống thông qua xử lý bất đồng bộ (dàn đều tải, giảm thời gian cần để phản hồi), đồng thời giảm coupling của hệ thống.
Sử dụng cache
Trong kịch bản concurrent cao, nếu mọi request đều đánh thẳng vào database, database rất có thể sập do áp lực quá lớn. Sử dụng cache để cache dữ liệu hot; vì cache được lưu trong memory nên tốc độ rất nhanh!
Các trường hợp sử dụng cache điển hình:
- Cache dữ liệu hot: Đưa dữ liệu được truy cập thường xuyên vào cache như Redis.
- Cache page: Cache page sau khi render để giảm áp lực lên server.
- Local cache: Sử dụng local cache như Caffeine và Guava Cache để giảm network overhead.
Bản thân cache cũng cần tính đến các failure mode điển hình trong High Availability:
- Cache penetration: Query dữ liệu không tồn tại khiến mọi request xuyên tới database. Các cách xử lý thường gặp gồm validation tham số, cache giá trị rỗng và Bloom filter.
- Cache breakdown: Khi hot Key hết hạn, một lượng lớn request đồng thời đánh vào database. Các cách xử lý thường gặp gồm mutex lock, logical expiration, hot Key không bao giờ hết hạn kết hợp với refresh bất đồng bộ.
- Cache avalanche: Một lượng lớn Key đồng thời hết hạn hoặc cache cluster không khả dụng. Các cách xử lý thường gặp gồm thêm độ lệch ngẫu nhiên vào expiration time, multi-level cache và High Availability cho cache cluster.
Khác
- Core application và service ưu tiên sử dụng hardware tốt hơn: Core service sử dụng server có cấu hình cao hơn, SSD và các hardware khác.
- Giám sát việc sử dụng resource của hệ thống và bổ sung cảnh báo: Sử dụng các giải pháp monitoring như Prometheus + Grafana, thiết lập threshold cảnh báo hợp lý.
- Chú ý backup, rollback khi cần: Backup database định kỳ, bảo đảm version code có thể truy vết và hỗ trợ rollback nhanh.
- Gray release: Chia server cluster thành nhiều phần, mỗi ngày chỉ release một phần server, theo dõi xem hệ thống có vận hành ổn định và không gặp lỗi hay không; ngày hôm sau tiếp tục release một phần, thực hiện liên tục vài ngày cho đến khi release toàn bộ cluster. Nếu phát hiện vấn đề trong thời gian này, chỉ cần rollback phần server đã release.
- Kiểm tra/thay hardware định kỳ: Nếu không sử dụng cloud service, vẫn cần kiểm tra hardware định kỳ. Với hardware cần thay hoặc upgrade, phải kịp thời thay hoặc upgrade.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.