
Trong kiến trúc microservice, một request thường phải đi qua call chain của nhiều service. Nếu một service trên chain gặp vấn đề, chẳng hạn response chậm, timeout hoặc thậm chí dừng hẳn, tài nguyên của upstream rất dễ bị kéo sập, cuối cùng biến thành avalanche trên toàn bộ chain. Service degradation và circuit breaker là hai tuyến phòng thủ để xử lý loại vấn đề này: degradation chủ động "bỏ phần phụ để giữ phần chính" khi hệ thống chịu tải lớn, còn circuit breaker kịp thời "ngắt mạch" để giảm thiệt hại khi downstream liên tục bất thường.
Bài viết này giải thích các nguyên lý cốt lõi của degradation và circuit breaker, gồm Fallback, degradation switch, state machine của circuit breaker, chiến lược isolation và so sánh lựa chọn Sentinel, Hystrix, Resilience4j.
Degradation là gì?
Service degradation nói đơn giản là: khi hệ thống sắp không chịu nổi, tạm hy sinh chức năng không quan trọng để dành tài nguyên cho core chain.
Ví dụ trong đợt khuyến mãi lớn của e-commerce, module recommendation, vị trí quảng cáo và ảnh tạo không khí sự kiện có thể tắt trước, nhưng chain đặt hàng, thanh toán và trừ tồn kho phải cố gắng giữ lại. Người dùng có thể chấp nhận xem ít recommendation hơn, nhưng không đặt được hàng mới là sự cố thực sự.
Vì vậy, degradation là một phương án fallback được thiết kế trước, không phải sau khi hệ thống sập mới tùy tiện trả về một giá trị mặc định. Khi nào kích hoạt, tắt chức năng nào, trả nội dung gì và khôi phục ra sao đều cần được xác định trước.
Degradation thường được kích hoạt khi nào?
Nhiều người hiểu degradation là "chỉ degradation khi machine load quá cao", nhưng thực tế không chỉ có trường hợp này.
Các tình huống kích hoạt thường gặp gồm:
- Áp lực tổng thể của hệ thống quá lớn, chẳng hạn CPU tăng vọt, thread pool đầy, thời gian response của API tăng rõ rệt;
- Một downstream service bất thường, chẳng hạn inventory service, price service hoặc recommendation service đột nhiên timeout hàng loạt;
- Một data center, khu vực hoặc network chain gặp vấn đề;
- Trước khi mở khuyến mãi lớn, flash sale hoặc event, chủ động tắt một số chức năng không core theo phương án đã định;
- Bộ phận vận hành tạm thời cần kiểm soát một số entry của chức năng.
Dù nguyên nhân kích hoạt là gì, mục tiêu cốt lõi của degradation vẫn giống nhau: giữ core, bỏ non-core.
Degradation có thể áp dụng đến mức độ nào?
Phạm vi degradation có thể rộng hoặc hẹp.
Ở mức rộng, có thể degradation toàn bộ service. Ví dụ khi recommendation service bất thường, mọi kết quả recommendation đều trả về empty list.
Ở mức hẹp hơn, chỉ degradation một block trên page. Ví dụ product detail page vẫn hiển thị bình thường, nhưng khu vực "Có thể bạn thích" tạm thời ẩn đi.
Hẹp hơn nữa, chỉ degradation một API, một feature switch, thậm chí một nhóm user hoặc một business scenario.
Trong dự án thực tế, thường cần phân priority cho các chức năng. Ví dụ:
- Recommendation, quảng cáo, ranking: priority thấp, có vấn đề thì tắt trước;
- Product detail, shopping cart: priority cao, cố gắng giữ lại;
- Đặt hàng, thanh toán, tồn kho: core chain, chỉ xem xét degradation sau cùng.
Các mức L0-L4 và cấp 1-10 ở đây chỉ là quy ước nội bộ của team, không phải standard thống nhất của industry. Điều quan trọng không phải cách đặt tên, mà là phải xác định trước: chức năng nào có thể hy sinh, chức năng nào bắt buộc phải giữ.
Có những cách degradation nào?
1. Xử lý trễ
Một số thao tác không cần hoàn tất đồng bộ, có thể đưa vào MQ để xử lý từ từ.
Ví dụ cộng điểm sau khi bình luận, thống kê hành vi user, tạo report. Những thao tác này hoàn tất chậm vài giây thường không khiến user nhận ra. Chỉ cần main flow trả success trước, các việc còn lại giao cho async task xử lý.
Nhưng có một điểm cần lưu ý: MQ cũng có thể bị tích tụ. Nếu consumer đã xử lý không kịp mà producer vẫn retry liên tục, hệ thống còn bị đánh nặng hơn. Vì vậy retry cần thêm backoff và random jitter, khi cần còn phải rate limiting.
2. Degradation một phần page
Đây là một cách trực quan nhất: giữ lại phần chính của page, tắt block non-core.
Ví dụ trong product detail page, title sản phẩm, giá và tồn kho phải giữ; khu recommendation, vị trí quảng cáo và widget event có thể tạm ẩn.
Cách này đơn giản và hiệu quả, nhưng tiền đề là phải chuẩn bị switch và logic fallback từ trước. Khi thật sự xảy ra vấn đề mới sửa code rồi release thì gần như không kịp.
3. Degradation bằng Fallback cho API
Một số API trên page được load bất đồng bộ, chẳng hạn thời gian giao hàng, dự đoán giá và recommendation list. Khi chúng timeout, có thể trả trực tiếp giá trị mặc định hoặc giá trị từ cache.
Ví dụ khi API thời gian giao hàng bất thường, có thể hiển thị trước "Dự kiến giao trong 2-3 ngày"; khi API recommendation bất thường, có thể trả về các sản phẩm phổ biến trong cache.
Cần lưu ý rằng dữ liệu fallback nên được chuẩn bị trước. Đừng chờ API đã sập mới tạm thời query database hoặc tạo lại cache, vì như vậy rất có thể làm sự cố tiếp tục lan rộng.
4. Degradation bằng chuyển page
Nếu full page quá nặng, có thể chuyển user sang một page rút gọn hoặc static page.
Ví dụ khi lượng truy cập event page quá lớn, có thể tạm thời chuyển sang static event page; khi system maintenance, có thể chuyển đến maintenance notice page.
Giải pháp này có vẻ đơn giản, nhưng nhất định phải chuẩn bị trước static page, routing rule và switch chuyển đổi. Sau khi sự cố xảy ra mới làm tạm thời thì gần như không thực tế.
5. Degradation khi ghi
Write degradation phù hợp với những scenario "có thể ghi vào database muộn hơn".
Ví dụ các thao tác cộng điểm, gửi notification và ghi inventory flow có thể ghi trước vào Redis, message table hoặc local persistent queue, sau đó đồng bộ từ từ vào database bằng MQ hoặc scheduled task.
Nhưng cái giá của write degradation cũng khá rõ: phải xử lý vấn đề eventual consistency. Ví dụ message có bị mất không, data có bị ghi trùng không, đồng bộ thất bại thì compensate thế nào và reconciliation ra sao đều phải thiết kế trước.
Đặc biệt cần lưu ý, in-memory queue thuần túy không phù hợp để lưu data quan trọng. Node restart một lần là data mất.
6. Degradation khi đọc
Read degradation thường là "chỉ đọc cache, không truy cập backend service nữa".
Các data đọc nhiều ghi ít như product detail, shop information và hot ranking rất phù hợp để làm cache fallback. Khi backend service bất thường, trước hết trả về data cũ trong cache, ít nhất page vẫn có thể mở.
Nếu cache cũng không hit, đừng tiếp tục cố gọi downstream. Có thể trả trực tiếp giá trị mặc định, empty result hoặc degradation page. Nếu không, một request của user có thể kéo theo cả chuỗi backend service.
Làm degradation switch thế nào?
Degradation phải có thể bật và tắt nhanh. Không thể lần nào cũng sửa code, release rồi restart.
Các phương án thường gặp:
| Phương án | Đặc điểm | Scenario phù hợp |
|---|---|---|
| Config file + restart | Đơn giản nhưng có hiệu lực chậm | Switch không khẩn cấp, ít thay đổi |
| Bảng switch trong database | Có thể audit nhưng tính realtime trung bình | Cần ghi nhận ai sửa và sửa lúc nào |
| Config center | Tính realtime tốt, thường dùng trong production | Core degradation switch, dynamic switch |
| Redis switch | Nhẹ, tích hợp nhanh | Business đơn giản, kiểm soát tạm thời |
Trong production, nên dùng config center như Nacos hoặc Apollo để làm degradation switch. Chúng đáng tin cậy hơn nhiều so với "sửa config file rồi restart", đồng thời phù hợp hơn với scenario khẩn cấp.
Tuy nhiên, không nên hiểu "realtime push" là "mọi machine có hiệu lực cùng lúc ngay lập tức". Lấy Nacos làm ví dụ, Nacos 2.x thêm gRPC long connection, config change có thể được push đến client qua long connection, nhưng hiệu lực thực tế vẫn chịu ảnh hưởng của số lượng client, network, server load, việc refresh local cache và các yếu tố khác.
Vì vậy khi thiết kế degradation switch, cần mặc định chấp nhận một thực tế: giữa các machine có thể tồn tại trạng thái không nhất quán trong thời gian ngắn.
Cần lưu ý gì khi dùng Nacos làm degradation switch?
Nếu project dùng Nacos, có một số điểm cần biết trước.
Thứ nhất, cách giao tiếp của Nacos 2.x và 1.x không hoàn toàn giống nhau. Nacos 2.x thêm giao tiếp gRPC, nên ngoài main port 8848 còn dùng các port như 9848, 9849. Tài liệu chính thức cũng nêu rõ 9848 là port để client gửi gRPC request đến server, còn 9849 là port giao tiếp giữa các server.
Thứ hai, cần chú ý compatibility khi upgrade. Nacos 2.0 server có thể tương thích với 1.x client, nhưng 2.x client không thể kết nối 1.x server vì 2.x client sẽ dùng gRPC.
Thứ ba, nếu ở giữa có network layer như Docker, firewall, security group, Nginx hoặc VIP, phải xử lý port mapping từ trước. Đặc biệt khi port 9848 chưa được mở, client có thể không connect được hoặc không kéo được config. Tài liệu chính thức cũng nêu rằng khi dùng VIP/Nginx cần cấu hình TCP forwarding, không thể xử lý như forwarding HTTP thông thường.
Thứ tư, khi có network partition hoặc long connection của client bất thường, client có thể chỉ tiếp tục dùng local config cũ. Vì vậy phương án dự phòng phải ghi rõ: nếu degradation switch chưa kịp push đến mọi node thì hệ thống nên xử lý thế nào.
Đó cũng là lý do degradation không thể chỉ phụ thuộc vào một switch. Core chain tốt nhất còn phải kết hợp timeout, circuit breaker, rate limiting và cache fallback.
Service degradation được phân loại thế nào?
Theo việc có tự động hóa hay không, degradation có thể chia thành:
- Degradation bằng switch tự động (được kích hoạt bởi rule engine, circuit breaker, rate limiter hoặc monitoring alert)
- Degradation bằng switch thủ công (được on-call hoặc phương án vận hành kích hoạt qua config platform, chẳng hạn flash sale và e-commerce promotion)
Auto degradation thường có các loại theo điều kiện kích hoạt:
- Timeout degradation: RT liên tục vượt threshold (threshold có thể tham khảo monitoring baseline P99/P999, nhưng framework cụ thể kích hoạt theo RT của từng request + window aggregation, không trực tiếp lấy P99 để so sánh), sau khi kích hoạt thì trả giá trị mặc định. Cần chú ý idempotency protection, nếu không retry storm còn rắc rối hơn sự cố ban đầu.
- Failure degradation: kích hoạt khi error rate vượt threshold (chẳng hạn 50%), trả dữ liệu fallback. Dữ liệu fallback phải được warm up trước vào cache.
- Fault degradation: kích hoạt khi downstream trả HTTP 5xx, RPC exception, DNS resolution failure và các hard error khác, trả data trong cache. Nếu cache không hit thì trả trực tiếp giá trị mặc định, đừng gọi tiếp xuống dưới.
- Rate limiting degradation: kích hoạt khi QPS vượt threshold, trả queue page, thông báo hết hàng hoặc error page. Queue page cần chống re-entry (idempotency token), nếu không user refresh liên tục sẽ làm mất ý nghĩa.
Retry storm: service vừa khôi phục, mọi client đồng thời retry khiến service lại bị đánh sập. Cách xử lý: exponential backoff có Jitter, rate limiting bằng token bucket, khôi phục theo nhóm và từng batch.
Degradation trong distributed system quy mô lớn
Trong distributed system quy mô lớn thường có hàng trăm hoặc hàng nghìn service. Trước đợt promotion lớn, thường cần degradation theo batch dựa trên mức độ quan trọng của business và quan hệ giữa các business.
Năng lực của degradation platform
Các công ty Internet lớn thường có degradation platform thống nhất, cần có các năng lực sau:
- Quản lý theo cấp: phân cấp service theo priority (cấp 1-10 hoặc L0-L4, tùy quy ước của team), core business phải qua review, quan hệ dependency cần được phân tích trước.
- Degradation theo batch: thực thi theo batch dựa trên cấp hoặc group, sắp xếp execution order, push theo version và rollback một lần. Hoàn tất gray release, preview và approval rồi mới thực hiện, đừng tắt tất cả một lần rồi mới phát hiện đã chạm vào core chain. Thông thường không yêu cầu tính atomic của 2PC nghiêm ngặt.
- Dynamic switch: config center (Nacos 2.x gRPC hoặc Apollo) push realtime, không cần restart.
- Xác minh hiệu quả: gray release + monitoring, so sánh metrics để xác nhận degradation có hiệu lực và không gây ảnh hưởng nhầm.
- Rollback một lần: version hóa config, audit change, nhanh chóng quay lại khi có vấn đề.
Lập phương án degradation
- Phân cấp business: trước hết xác định service nào không được động vào (như đặt hàng, thanh toán), service nào có thể tắt (như recommendation, bình luận), rồi định nghĩa priority
- Phân tích dependency: vẽ call chain, tìm critical path và single-point dependency, xác định service nào sập sẽ liên lụy cả vùng
- Chiến lược degradation: thiết kế phương án degradation cho từng non-core service, đừng quên cách xử lý failure path
- Diễn tập và xác minh: định kỳ chạy degradation drill, phương án trên giấy chưa chạy thử thì chưa thể yên tâm
Khi network partition, đừng sa vào tranh luận lý thuyết; chỉ cần làm rõ các việc sau: trong thời gian partition, mỗi service đọc local cache hay từ chối request, có dừng ghi cross-region không, làm sao giữ core chain và có chuyển sang read-only mode không.
Giới thiệu chi tiết: Giải thích chi tiết lý thuyết CAP & BASE.
Fallback là gì?
Fallback có thể hiểu là: kết quả fallback.
Trong điều kiện bình thường, request sẽ gọi business logic thật, chẳng hạn query recommendation, product detail hoặc user information. Nhưng nếu lần gọi này thất bại, hoặc bị rate limiting hay circuit breaker rule chặn, hệ thống không thể trực tiếp ném exception cho user mà phải trả về một kết quả đã chuẩn bị trước.
Ví dụ recommendation service sập thì trả empty list trước; product detail API timeout thì trả data cũ trong cache; event page API bất thường thì chuyển sang static page.
Đó là tác dụng của Fallback: đừng để một failure kéo sập toàn bộ chain.
Tuy nhiên cần lưu ý, Fallback không dùng để "sửa vấn đề", mà chỉ giúp hệ thống còn có thể hoạt động tạm trong tình huống bất thường. Nội dung user nhìn thấy có thể không đầy đủ hoặc chưa phải mới nhất, nhưng ít nhất page không sập hẳn.
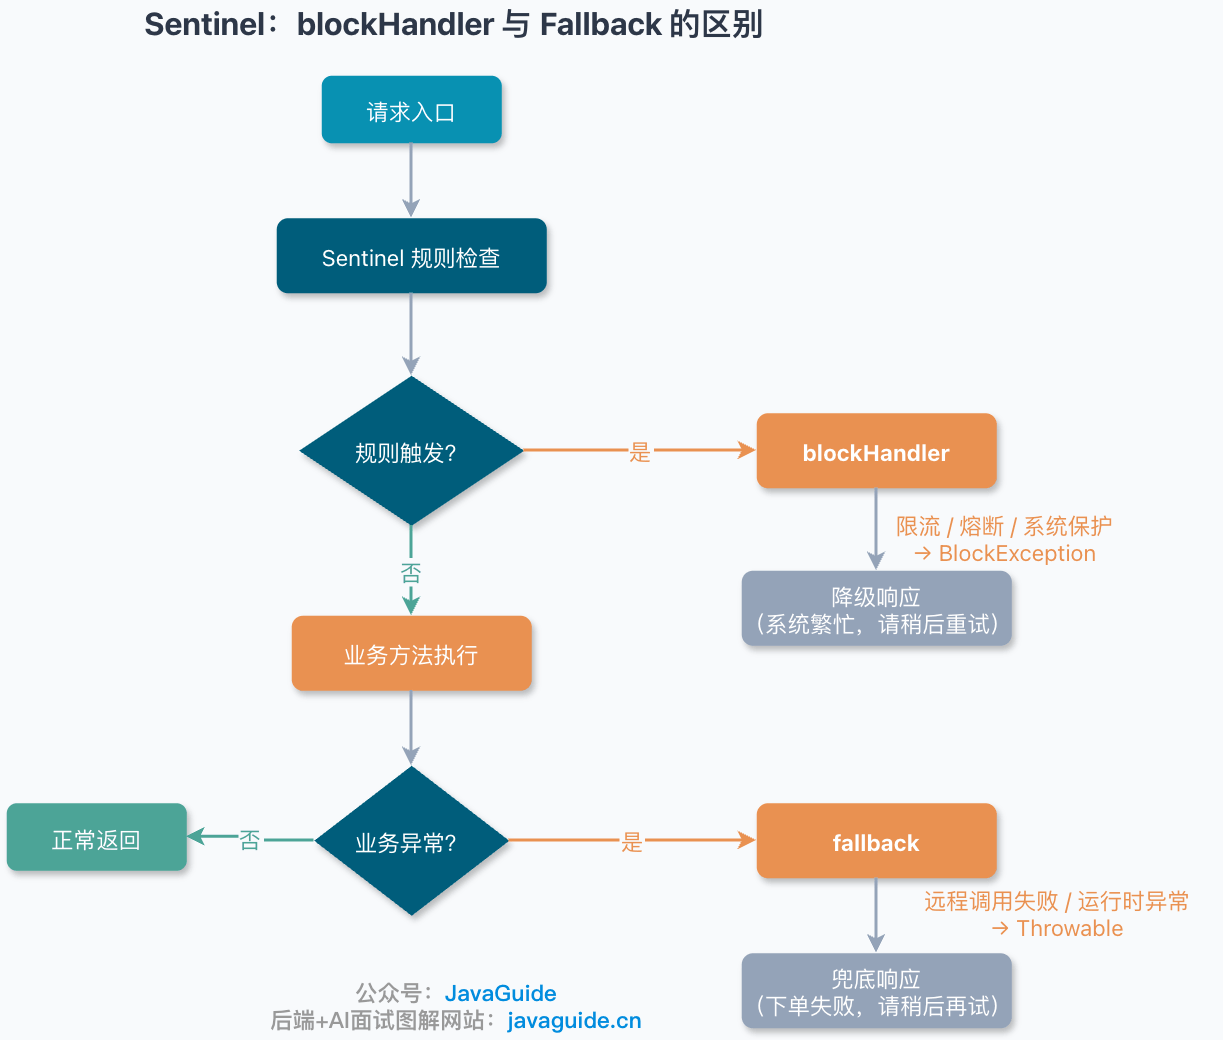
blockHandler và fallback trong Sentinel khác nhau thế nào?
Trong Sentinel, blockHandler và fallback rất dễ bị trộn lẫn. Cả hai đều giống như đang "fallback", nhưng nguyên nhân kích hoạt khác nhau.
Nói ngắn gọn:
| Scenario | Đi vào method nào | Exception thường gặp |
|---|---|---|
| Bị Sentinel rule chặn, chẳng hạn rate limiting, circuit breaker, system protection | blockHandler | BlockException |
| Chính business code ném exception, chẳng hạn null pointer, remote call failure, runtime exception | fallback | Throwable |
Ví dụ.
Khi API bị rate limiting, Sentinel xác định request không thể tiếp tục đi xuống, lúc này sẽ vào blockHandler.
Nếu request đã vào business method nhưng việc gọi inventory service trong business thất bại và ném RuntimeException, lúc này mới vào fallback.
Nếu cấu hình cả blockHandler và fallback, exception do Sentinel rule kích hoạt sẽ ưu tiên vào blockHandler; chỉ business exception mới vào fallback. Đừng nhầm điểm này, nếu không việc điều tra sự cố production sẽ rất vòng vèo.
Các cách Fallback thường gặp
Các cách Fallback thường gặp gồm:
- Trả giá trị mặc định: trả trực tiếp một static default object. Nếu recommendation list rỗng thì trả
[], nếu không query được config thì trả default config. Lưu ý cấu trúc của default value phải nhất quán với response bình thường, đừng trả null khiến upstream nhận null rồi NPE. - Cache fallback: đọc kết quả thành công gần nhất trong local cache hoặc Redis. Những read scenario như product detail và user information rất phù hợp. Cache có thể hết hạn, khi trả về tốt nhất nên đánh dấu thời hạn của data; khi cache penetration xảy ra đừng cố chịu, hãy fallback về giá trị mặc định.
- Degradation page: trả static HTML hoặc page rút gọn, event page và marketing module thường dùng cách này. Nhưng bản thân static resource cũng cần disaster recovery, phải tính trước cách xử lý khi CDN không origin được.
- Write degradation: ghi trước vào Redis hoặc local message table, rồi async sync đến DB. Thường dùng trong write scenario concurrency cao như trừ tồn kho flash sale và cộng điểm. Cái giá là phải bảo đảm eventual consistency (reconciliation/compensation); in-memory queue thuần túy sẽ làm mất data khi node dừng.
Các lỗi thường gặp của Fallback
Bản thân Fallback cũng có thể gặp vấn đề, hơn nữa loại vấn đề này khó phát hiện hơn failure thông thường. Một số lỗi thường gặp:
- Ẩn remote call trong Fallback: logic fallback gọi Redis, DB hoặc service khác, kết quả các dependency này cũng sập, avalanche còn nghiêm trọng hơn. Ưu tiên dùng Caffeine, local Map hoặc static default value; nếu buộc phải truy cập Redis, dùng connection pool riêng, timeout riêng và circuit breaker riêng, cache không hit thì trả giá trị mặc định, đừng nối tiếp xuống dưới nữa.
- Fallback trả về null: upstream nhận null rồi NPE, tạo ra exception chain mới. Structure trả về phải nhất quán với bình thường, dùng empty object thay vì null.
- Logic Fallback quá phức tạp: bản thân fallback chậm đi và kéo sập calling thread. Logic Fallback phải cực kỳ tối giản, cấm xử lý business phức tạp.
- Nhiều Fallback dùng chung một cache: cache bị lấp đầy, mọi fallback đồng thời mất hiệu lực. Cô lập cache theo business dimension, core chain dùng cache instance riêng.
Nói đơn giản: Fallback là tuyến phòng thủ cuối cùng, phải nhanh và đơn giản hơn normal call. Nếu bên trong fallback còn có synchronous remote call mà không có timeout protection, đó không phải fallback mà là quả bom hẹn giờ.
Circuit breaker là gì?
Circuit breaker nghe có vẻ trừu tượng, nhưng có thể hiểu đơn giản là giảm thiệt hại kịp thời. Đây là một cơ chế bảo vệ chain để ứng phó với hiệu ứng avalanche trong microservice, tương tự fuse trong mạch điện.
Trong microservice, một service thường phải gọi service khác. Ở trạng thái bình thường, request đi xuống lần lượt:
Service A -> Service B -> Service CNếu Service C đột nhiên chậm, thread mà Service B dùng để gọi C sẽ chờ liên tục. Khi thread của B bị chiếm hết, A gọi B cũng bắt đầu timeout. Đi tiếp lên trên, service gọi A cũng bị kéo theo.
Cuối cùng xuất hiện tình huống rất điển hình: rõ ràng chỉ Service C có vấn đề, nhưng cả chain lại bị kéo sập.
Circuit breaker được tạo ra để giải quyết vấn đề này.
Ý tưởng rất đơn giản: nếu phát hiện downstream đã rõ ràng bất thường, tạm thời đừng đánh tiếp vào nó, hãy trả trực tiếp kết quả fallback. Sau một khoảng thời gian, cho một lượng nhỏ request đi qua để thăm dò. Nếu downstream đã khôi phục, từ từ khôi phục normal call.
Điều này giống fuse trong mạch điện: khi dòng điện bất thường thì ngắt trước, tránh làm cháy các thiết bị phía sau.
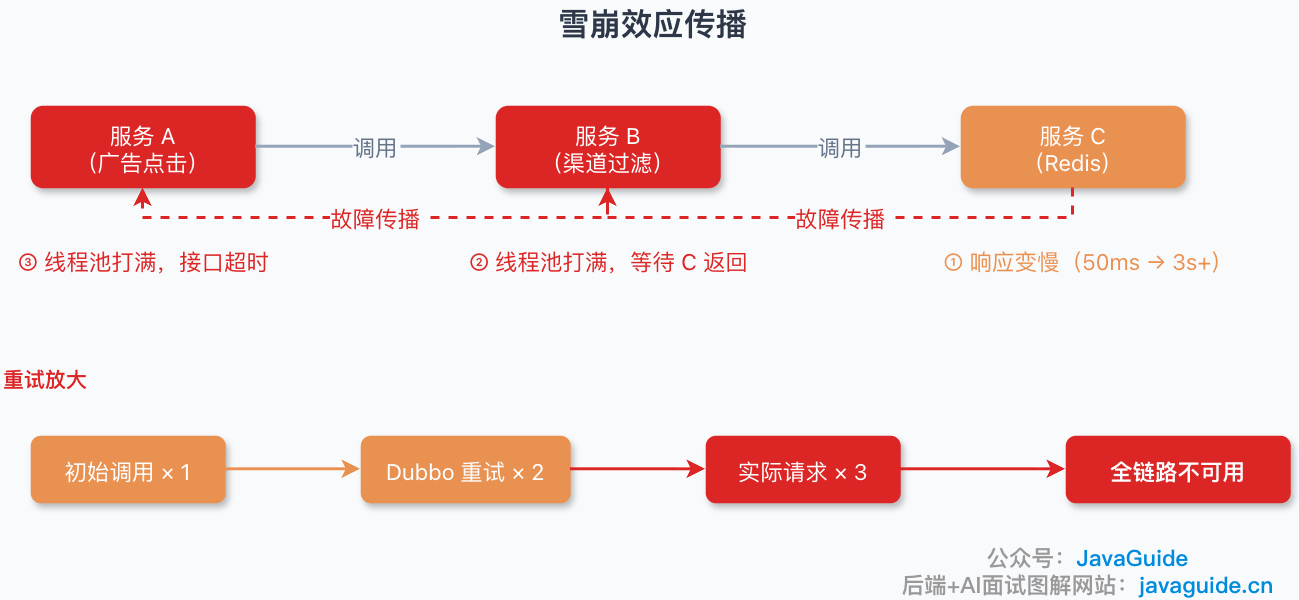
Avalanche xảy ra thế nào?
Nhiều avalanche trong production không xảy ra trong chớp mắt mà lan truyền từng tầng.
Vẫn lấy chain này làm ví dụ:
Service A -> Service B -> Service CBan đầu có thể chỉ Service C response chậm. Ví dụ trước đây trả về trong 50ms, giờ cần 3 giây.
Tiếp theo, thread của Service B gọi C bắt đầu xếp hàng. Các thread trong thread pool đều chờ C trả về, request mới chỉ có thể tiếp tục xếp hàng.
Sau đó, A gọi B cũng bắt đầu timeout. Thread của A cũng bị chiếm, response của API ngày càng chậm.
Nếu lúc này client, RPC framework hoặc business code vẫn retry liên tục, request volume sẽ tiếp tục bị khuếch đại. Cuối cùng không chỉ một service chậm mà cả chuỗi service đều chậm, toàn bộ chain bắt đầu không khả dụng.
Đó chính là hiệu ứng avalanche.
Một ví dụ gần với thực tế hơn
Giả sử có một ad click chain:
Ad click service A -> Channel filtering service B -> RedisỞ trạng thái bình thường, A xử lý 30-40 nghìn click mỗi phút. Một ngày nọ traffic đột nhiên tăng lên hơn 80 nghìn.
Vấn đề ban đầu nằm ở B. B cần đọc một đoạn filtering data từ Redis, nhưng value này quá lớn, mỗi lần get mất hơn 3 giây.
Vì vậy A gọi B bắt đầu timeout hàng loạt.
Nếu RPC API như Dubbo còn cấu hình failure retry, chẳng hạn sau một lần gọi ban đầu lại retry 2 lần, một lần gọi ban đầu có thể thành 3 lần gọi. Cần lưu ý việc này có xảy ra cụ thể hay không còn phụ thuộc vào version Dubbo, API config và loại call. Đặc biệt với write API, thông thường không nên retry mặc định, ít nhất phải hết sức thận trọng.
Retry càng nhiều, B nhận càng nhiều request, thread pool nhanh chóng đầy rồi bắt đầu reject request. Phía A tiếp tục nhận timeout và exception, connection, file handle và thread resource cũng bị tiêu hao.
Cuối cùng, ban đầu chỉ là Redis đọc chậm nhưng đã kéo sập A, B và chain upstream.
Trong các sự cố kiểu này, retry thường là "bộ tăng tốc". Khi không có rate limiting và circuit breaker, nó sẽ khuếch đại một failure cục bộ thành failure trên toàn chain.
Vì vậy không phải production không được retry, mà retry phải có giới hạn: phải có timeout, số lần tối đa, backoff strategy, đồng thời kết hợp rate limiting và circuit breaker.
Circuit breaker có những state nào?
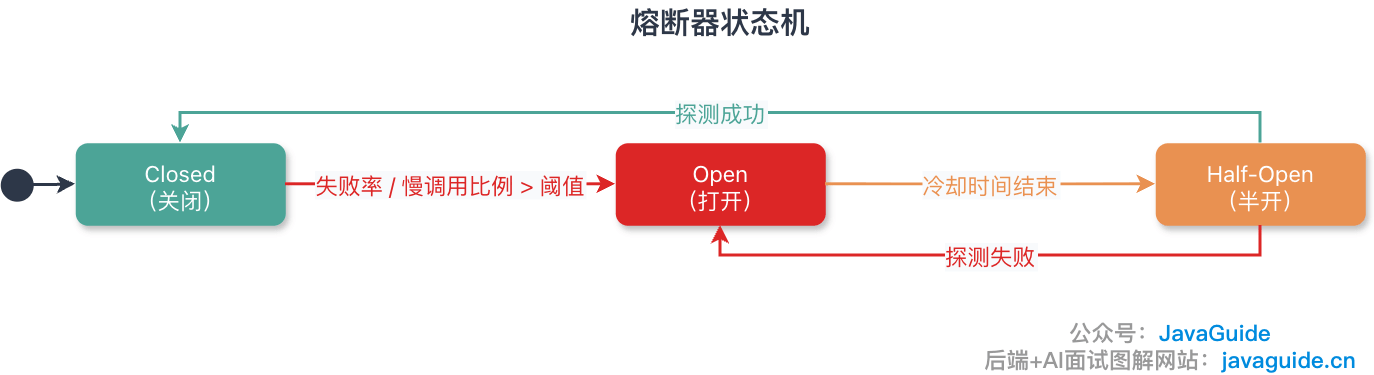
Circuit breaker gồm ba state:
| State | Giải thích | Hành vi | Điều kiện chuyển state |
|---|---|---|---|
| Closed (đóng) | State bình thường, cho request đi qua | Ghi nhận failure rate/slow call ratio | Failure rate/slow call ratio > threshold → Open |
| Open (mở) | Circuit breaker được kích hoạt, reject request | Trả nhanh Fallback, không gọi downstream nữa | Sau cooling time (tên gọi khác nhau tùy framework, như sleepWindow của Hystrix, waitDurationInOpenState của Resilience4j, giá trị điển hình 10s) → HalfOpen |
| HalfOpen (bán mở) | Thăm dò service đã khôi phục chưa | Cho một lượng nhỏ probe request đi qua (số lượng tùy implementation của framework) | Probe request đạt điều kiện success → Closed; failure → Open |
Half-Open không phải Warm Up
Hai khái niệm này rất dễ nhầm.
Half-Open giải quyết câu hỏi: downstream đã khôi phục chưa?
Warm Up giải quyết câu hỏi: sau khi khôi phục, có nên tăng traffic từ từ không?
Nói cách khác, Half-Open giống "thăm dò" hơn, còn Warm Up giống "warm up và tăng traffic" hơn.
Ví dụ service vừa restart, cache chưa warm, JIT cũng chưa hoàn toàn ổn định, connection pool của database vừa bắt đầu được tạo. Lúc này dù probe thành công cũng không có nghĩa service lập tức chịu được toàn bộ traffic.
Vì vậy cách ổn định hơn là:
- Half-Open trước hết cho một lượng nhỏ request đi qua để thăm dò;
- Sau khi probe thành công, không lập tức đẩy full traffic;
- Tiếp tục dùng Warm Up, rate limiting hoặc tăng traffic theo batch để service từ từ khôi phục.
Warm Up của Sentinel thuộc chiến lược cold start trong flow control, coldFactor mặc định là 3, tức ban đầu QPS tăng từ từ từ khoảng threshold / 3 đến configured threshold.
Trong thời gian khôi phục, đừng chỉ nhìn average latency. Average rất dễ che khuất một số ít request cực chậm. Nên đồng thời theo dõi P99, P999, số thread active của thread pool, số connection active của database connection pool và error rate.
Sentinel hỗ trợ những circuit breaker strategy nào?
Sau Sentinel 1.8.0, circuit breaker degradation chủ yếu có ba strategy: slow call ratio, error ratio và error count. DegradeRule trong tài liệu chính thức cũng nêu các field này, chẳng hạn count, timeWindow, minRequestAmount, statIntervalMs, slowRatioThreshold.
1. Slow call ratio
Strategy này xem tỷ lệ slow request.
Ví dụ đặt RT tối đa là 500ms, request vượt 500ms được xem là slow call. Tiếp đó Sentinel tính slow call ratio trong một statistics window.
Nếu số request trong window đạt min request amount và slow call ratio vượt threshold thì circuit breaker được kích hoạt.
Strategy này phù hợp để xử lý tình huống "downstream không báo lỗi nhưng ngày càng chậm".
2. Error ratio
Strategy này xem tỷ lệ failure request.
Ví dụ trong một khoảng thời gian gần đây, số request đạt yêu cầu tối thiểu và error ratio vượt 50% thì kích hoạt circuit breaker.
Nó phù hợp với scenario downstream bắt đầu báo lỗi hàng loạt, chẳng hạn RPC exception, runtime exception hoặc server 5xx.
3. Error count
Strategy này xem số lần exception.
Ví dụ nếu số exception trong 1 phút vượt 50 lần thì kích hoạt circuit breaker.
Cách này trực quan hơn error ratio nhưng khá nhạy với traffic volume. Không thể áp dụng cùng một threshold cho API QPS cao và API QPS thấp.
Có thể dùng P99 trực tiếp làm điều kiện circuit breaker không?
Không nên hiểu như vậy.
P99 là monitoring metric, phù hợp để quan sát performance tổng thể của API và hỗ trợ thiết lập circuit breaker threshold.
Nhưng khi Sentinel kích hoạt circuit breaker, nó không đơn giản lấy P99 so với threshold. Logic gần với:
- Trước hết xem từng request có phải slow call hoặc exception không;
- Sau đó đưa vào statistics window để tính ratio hoặc count;
- Khi số request đạt min threshold, mới phán đoán có kích hoạt circuit breaker hay không.
Vì vậy P99 phù hợp hơn để trả lời câu hỏi: threshold của tôi đặt có hợp lý không?
Ví dụ P99 bình thường của một API là 120ms, nếu đặt slow call threshold là 100ms thì rất có thể gây ảnh hưởng nhầm.
Nếu P99 bình thường là 120ms rồi đột nhiên tăng lên 800ms, điều đó cho thấy downstream có thể thật sự gặp vấn đề, circuit breaker threshold cũng cần được đánh giá dựa trên baseline này.
Đặc biệt phải cẩn thận với API QPS thấp. Nếu window quá ngắn và min request amount quá nhỏ, một hai slow request ngẫu nhiên có thể kích hoạt circuit breaker. Cách ổn định hơn là kéo dài statistics window vừa phải hoặc tăng min request amount.
Degradation và circuit breaker khác nhau thế nào?
Degradation và circuit breaker thường được nói cùng nhau, nhưng chúng giải quyết các vấn đề khác nhau.
Degradation quan tâm: sau khi hệ thống gặp vấn đề, còn có thể tiếp tục phục vụ user bằng cách nào.
Ví dụ recommendation service sập thì product detail page không nên trắng theo, có thể tạm ẩn khu recommendation; event API timeout thì tạm hiển thị static event page; không query được user tag thì tạm xử lý như normal user.
Nói cách khác, degradation giống sự lựa chọn ở business layer hơn: chức năng nào có thể hy sinh trước, core chain nào phải giữ lại.
Circuit breaker quan tâm: downstream đã bất thường rồi thì có nên tiếp tục gọi không.
Ví dụ order service gọi inventory service, inventory service đã timeout hàng loạt. Nếu lúc này vẫn tiếp tục đánh request, inventory service chỉ càng chậm hơn, đồng thời thread pool của chính order service cũng bị kéo sập. Sau khi phát hiện downstream bất thường, circuit breaker trước hết chặn request, trả nhanh kết quả fallback, sau một khoảng thời gian mới cho một lượng nhỏ request đi qua để thăm dò.
Nhớ bằng một câu: degradation là "sau khi có vấn đề thì tiếp tục phục vụ thế nào", circuit breaker là "có tiếp tục gọi dependency bất thường hay không".
Rate limiting, circuit breaker và degradation lần lượt quản lý gì?
Ba khái niệm này cũng rất dễ nhầm.
Rate limiting quản lý entry. Nó giải quyết câu hỏi "traffic quá nhiều thì có cho tất cả vào không". Ví dụ khi flash sale có 100 nghìn request đồng thời đánh vào nhưng hệ thống chỉ chịu được 10 nghìn, bắt buộc phải chặn một phần.
Circuit breaker quản lý downstream. Nó giải quyết câu hỏi "downstream đã chậm hoặc sập thì có tiếp tục gọi không". Nếu tiếp tục gọi, downstream không thể khôi phục mà chính mình cũng sẽ bị kéo sập.
Degradation quản lý kết quả. Nó giải quyết câu hỏi "request bị rate limiting, downstream bị circuit breaker hoặc business ném exception thì tiếp theo trả gì cho user". Có thể trả giá trị mặc định, data trong cache, static page hoặc tắt một chức năng non-core.
Nói đời thường hơn:
- Rate limiting: đừng cho quá nhiều request vào
- Circuit breaker: đừng tiếp tục đánh vào downstream đã bất thường
- Degradation: sau khi có vấn đề, đổi cách khác để tiếp tục phục vụ
- Fallback: kết quả fallback thực sự được trả về
Fallback không phải một governance strategy độc lập, nó giống "fallback action" sau khi rate limiting, circuit breaker hoặc degradation được kích hoạt hơn.
Ví dụ: hãy hình dung hệ thống như một trung tâm thương mại. Rate limiting là kiểm soát số người vào trung tâm, quá đông thì xếp hàng trước cửa; degradation là trung tâm tạm đóng khu ẩm thực và rạp chiếu phim, nhưng siêu thị và nhà thuốc, những khu vực core, vẫn tiếp tục hoạt động; circuit breaker là phát hiện một nhà cung cấp gặp vấn đề thì tạm dừng đặt hàng từ họ, một lúc sau thử đặt vài đơn nhỏ để xem đã khôi phục chưa.
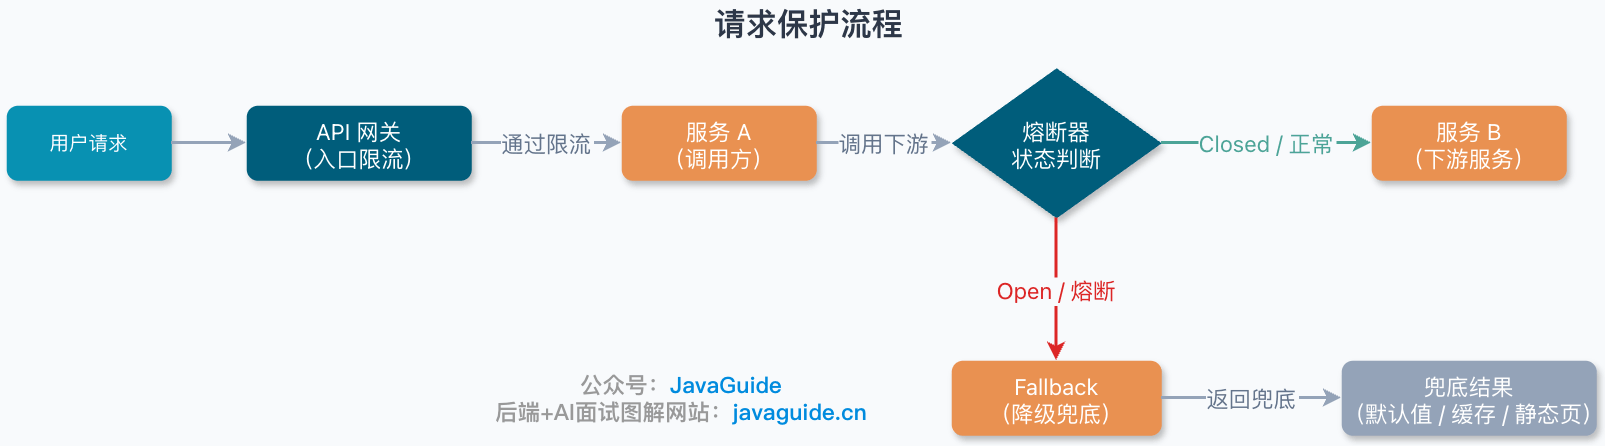
Chúng phối hợp thế nào trong một request?
Trong một request chain thực tế, rate limiting, circuit breaker và degradation thường có hiệu lực theo từng layer.
- Rate limiting ở gateway/entry: khi request vừa đi vào, trước hết kiểm tra entry traffic có vượt năng lực chịu tải của hệ thống không. Nếu vượt thì trả trực tiếp "Hệ thống đang bận, vui lòng thử lại sau", không để traffic tiếp tục đánh xuống dưới.
- Rate limiting trong service: một số request đã qua gateway nhưng thread pool, connection pool hoặc database của service nào đó sắp không chịu nổi, lúc này bên trong service cũng có thể rate limiting để bảo vệ resource quan trọng của mình.
- Circuit breaker phán đoán: trước khi service chuẩn bị gọi downstream, kiểm tra downstream có đang ở circuit breaker state không. Nếu đã circuit breaker thì đừng tiếp tục gọi, đi thẳng vào logic fallback.
- Business execution và Fallback: downstream call thất bại, business code ném exception hoặc rule chặn request thì trả kết quả fallback đã chuẩn bị trước. Ví dụ empty list, data trong cache, default object hoặc static page.
Tóm lại một câu: rate limiting chặn entry, circuit breaker ngắt downstream, degradation giữ core, Fallback cung cấp kết quả fallback.
Ví dụ tối thiểu dùng annotation của Sentinel
Trong ví dụ dưới đây, chỉ cần hiểu vai trò khác nhau của blockHandler và fallback:
@RestController
public class OrderController {

    @SentinelResource(
        value = "createOrder",
        blockHandler = "createOrderBlockHandler",
        fallback = "createOrderFallback",
        exceptionsToIgnore = {IllegalArgumentException.class}
    )
    @PostMapping("/order")
    public OrderVO createOrder(@RequestBody OrderDTO dto) {
        return orderService.create(dto);
    }

    // Khi Sentinel rule như rate limiting, circuit breaker hoặc system protection được kích hoạt, đi vào blockHandler
    public OrderVO createOrderBlockHandler(OrderDTO dto, BlockException ex) {
        return OrderVO.degraded("Số người đặt hàng hiện quá nhiều, vui lòng thử lại sau");
    }

    // Business exception đi vào fallback
    // Method signature cần giống method gốc hoặc có thêm một parameter Throwable
    public OrderVO createOrderFallback(OrderDTO dto, Throwable t) {
        return OrderVO.failure("Đặt hàng thất bại, vui lòng thử lại sau");
    }
}
Có một số điểm cần làm rõ:
blockHandler xử lý exception thuộc nhóm bị Sentinel chặn, chẳng hạn BlockException sau khi rate limiting, circuit breaker hoặc system protection được kích hoạt. fallback xử lý exception do business code ném ra, chẳng hạn remote call failure hoặc runtime exception. Method của nó phải có signature giống method gốc hoặc thêm một parameter Throwable.
Nếu cấu hình đồng thời blockHandler và fallback, exception do Sentinel rule kích hoạt chỉ vào blockHandler, không vào fallback. Điểm này rất dễ viết sai.
Ngoài ra, không phải business exception nào cũng nên fallback. Ví dụ validation parameter thất bại, không đủ quyền hoặc không đủ tồn kho vốn nên thông báo rõ cho upstream, không nên đồng nhất fallback thành "Hệ thống đang bận". Có thể dùng exceptionsToIgnore để loại trừ các exception này.
Có những giải pháp sẵn có nào?
Trong hệ Spring Cloud, các giải pháp circuit breaker, rate limiting và degradation thường gặp chủ yếu gồm:
- Hystrix 1.5.18: component lâu đời, nhiều project Spring Cloud Netflix thời kỳ đầu từng dùng. Nhưng nó đã vào maintenance mode và không còn chủ động phát triển, thường không được khuyến nghị cho project mới.
- Sentinel 1.8.x: traffic governance component mã nguồn mở của Alibaba, rất phổ biến trong các project Spring Cloud Alibaba ở Trung Quốc. Nó không chỉ có circuit breaker mà còn có rate limiting, traffic shaping, hot parameter rate limiting và system adaptive protection.
- Resilience4j 2.x: fault tolerance library nhẹ, chia module khá nhỏ, gồm circuit breaker, rate limiting, retry và bulkhead isolation. Các project Spring Boot 3 / Java 17 thường cân nhắc nó.
- Spring Retry: chủ yếu giải quyết vấn đề retry, bản thân nó không phải framework circuit breaker degradation hoàn chỉnh. Thường dùng cùng Spring Cloud CircuitBreaker hoặc business timeout strategy.
Tốt nhất không hard-code version number. Sentinel và Resilience4j vẫn đang được cập nhật, bài viết dựa trên Release có thể tra cứu tại thời điểm viết, còn cụ thể phải theo GitHub Release page và version matrix của từng project.
Chọn Hystrix, Sentinel hay Resilience4j thế nào?
Đừng vội học thuộc feature table, trước hết hãy phán đoán theo tình hình project.
Project cũ dùng Hystrix: nếu chạy ổn định thì chưa cần vội thay, nhưng phải lên kế hoạch migration.
Hystrix từng rất phổ biến, thread pool isolation, circuit breaker và Fallback đều được nó đưa lên trước. Nhưng Netflix chính thức cho biết Hystrix hiện đang ở maintenance mode, không còn active development.
Nếu project cũ đã dùng Hystrix thì không cần vì chữ "mới" mà lập tức làm lại từ đầu. Chỉ cần hệ thống ổn định, có thể tiếp tục dùng trước, đồng thời đưa migration vào kế hoạch upgrade Spring Boot / Spring Cloud sau này. Nhưng project mới không cần bắt đầu từ Hystrix, vì khi upgrade Java, Spring Boot và Spring Cloud sau này, chi phí compatibility sẽ ngày càng cao.
Project Spring Cloud Alibaba / Dubbo: ưu tiên xem xét Sentinel.
Ưu thế của Sentinel không chỉ là "có circuit breaker", mà là traffic governance tương đối hoàn chỉnh. Nó hỗ trợ rate limiting, circuit breaker degradation, hot parameter rate limiting và system adaptive protection, đồng thời có console để xem monitoring realtime và config rule. Với project Spring Cloud Alibaba hoặc Dubbo, chi phí tích hợp thường thấp hơn.
Nhưng cũng đừng xem Sentinel Dashboard là production config center. Dashboard phù hợp hơn để quản lý rule và xem hiệu quả; production thường còn cần kết nối Nacos, Apollo hoặc data source khác để persist rule, nếu không rule có thể mất sau restart.
Project mới dùng Spring Boot 3 / Java 17+: có thể ưu tiên xem xét Resilience4j.
Đặc điểm của Resilience4j là nhẹ và modular. Cần circuit breaker thì import CircuitBreaker; cần rate limiting thì import RateLimiter; cần retry thì import Retry; cần isolation thì import Bulkhead.
Nó kết hợp tự nhiên hơn với functional programming, Reactor và Spring Boot 3. Nếu project dùng Spring Boot 3, Java 17+ và không phụ thuộc hệ sinh thái Spring Cloud Alibaba, Resilience4j thường là lựa chọn gọn hơn.
So sánh đơn giản
| Dimension | Sentinel | Hystrix | Resilience4j |
|---|---|---|---|
| Trạng thái maintenance | Active maintenance | Maintenance mode | Active maintenance |
| Định vị chính | Traffic governance component | Circuit breaker degradation component | Lightweight fault tolerance library |
| Năng lực circuit breaker | Slow call ratio, error ratio, error count | Chủ yếu error ratio | Error ratio, slow call, error count và các loại khác |
| Năng lực rate limiting | Mạnh, hỗ trợ QPS, concurrent thread, hot parameter và các loại khác | Khá yếu | Có module RateLimiter |
| Năng lực isolation | Kiểm soát số concurrent thread | Thread pool isolation / semaphore isolation | SemaphoreBulkhead / ThreadPoolBulkhead |
| Traffic shaping | Hỗ trợ Warm Up, xếp hàng với tốc độ đều | Không nổi bật | Không nổi bật |
| System adaptive protection | Có hỗ trợ | Không hỗ trợ | Không hỗ trợ |
| Console | Có Sentinel Dashboard | Hystrix Dashboard đã lỗi thời | Thường tự tích hợp vào monitoring system |
| Scenario phù hợp | Spring Cloud Alibaba, Dubbo, Java project trong nước | Project cũ đang tồn tại | Spring Boot 3, Java 17+, project lightweight |
Người mới chỉ cần nhớ ba điểm: project cũ dùng Hystrix chạy ổn thì chưa cần vội thay; project Spring Cloud Alibaba / Dubbo ưu tiên xem Sentinel; project mới dùng Spring Boot 3 / Java 17+ có thể ưu tiên xem Resilience4j.
Hiểu isolation strategy thế nào?
Circuit breaker chỉ là "không tiếp tục gọi downstream bất thường", còn isolation giải quyết việc "đừng để một dependency ăn hết mọi resource".
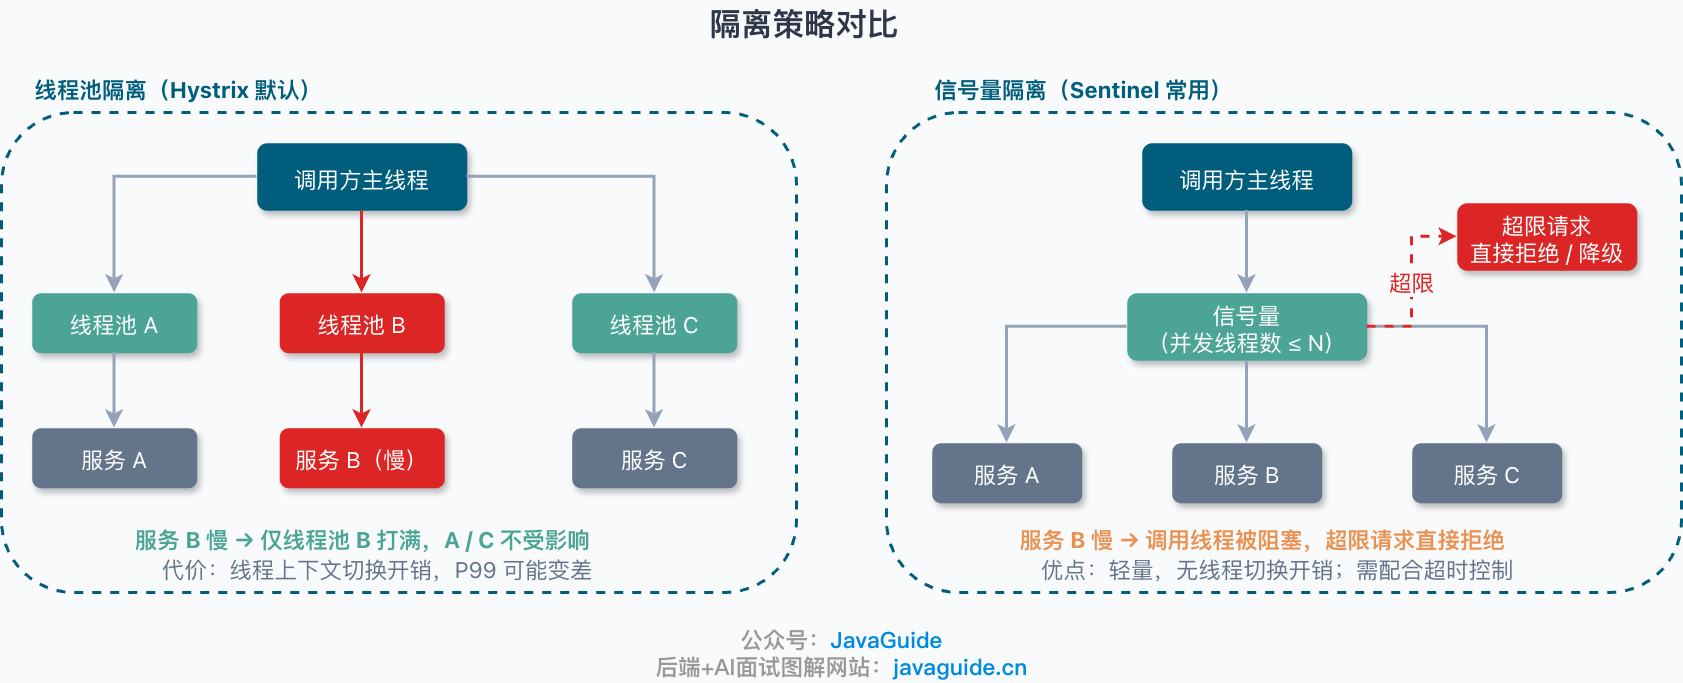
Thread pool isolation: cấp một thread pool riêng cho một downstream dependency. Ví dụ order service cần gọi inventory service thì để việc gọi inventory đi qua thread pool riêng. Inventory service chậm thì nhiều nhất chỉ làm đầy thread pool này, không kéo sập thread pool chính của order service. Ưu điểm là isolation triệt để hơn, nhược điểm là chi phí cao hơn, vì khi có nhiều thread sẽ phát sinh context switch overhead, đồng thời khó ước lượng kích thước thread pool và P99 có thể xấu đi. Hystrix mặc định dùng thread pool isolation.
Semaphore isolation: giới hạn số request đi vào đồng thời. Ví dụ cho phép tối đa 100 request đồng thời gọi inventory service, vượt quá thì reject hoặc degradation trực tiếp. Ưu điểm là nhẹ, không cần chuyển business call sang thread pool khác. Nhược điểm là nếu bản thân downstream call cứ blocking, business thread vẫn bị chiếm, nên thường phải kết hợp timeout control. Cách kiểm soát concurrent thread thường gặp của Sentinel gần với ý tưởng semaphore isolation.
Cái giá của thread pool isolation không phải "GC scan" như nhiều người nghĩ, mà là context switch. Khi có nhiều thread, CPU thường xuyên schedule, wake up và suspend giữa các thread, sy tăng vọt, tail latency P99 xấu đi theo. Mức độ nghiêm trọng phải xem số thread, tỷ lệ CPU sy/us, queue wait time và P99 metric, đừng chỉ dựa vào cảm giác.
System adaptive protection của Sentinel là gì?
Rate limiting thông thường là đặt threshold thủ công, chẳng hạn QPS vượt 1000 thì rate limiting. Nhưng hệ thống thực tế không đơn giản như vậy; CPU, Load, RT, số thread và entry QPS đều ảnh hưởng đến việc hệ thống đã gần giới hạn hay chưa.
System adaptive protection của Sentinel muốn giải quyết vấn đề này: không chỉ nhìn một API mà phán đoán từ góc độ load của toàn hệ thống xem có nên reject một phần request không. Tài liệu chính thức nói rằng ý tưởng này lấy cảm hứng từ TCP BBR, mục tiêu là duy trì throughput cao khi vẫn bảo đảm reliability của hệ thống. Nhưng đừng hiểu nó là TCP BBR hoàn chỉnh; Sentinel chỉ tham khảo ý tưởng, kết hợp realtime statistics và rule threshold để bảo vệ, không dynamic probe bandwidth và điều chỉnh congestion window như TCP.
Có thể hiểu sơ bộ là:
Current concurrent request count > system max QPS × min RT
Nếu số request đang in-flight vượt năng lực chịu tải ước tính của hệ thống, hệ thống bắt đầu reject một phần traffic. System rule còn có thể cấu hình theo các metric sau:
| Metric | Giải thích | Cách dùng thường gặp |
|---|---|---|
| Load | Giá trị load1 của Linux | Kích hoạt protection khi Load cao hơn rõ rệt số CPU core |
| Average RT | Average response time của entry traffic | Bảo vệ hệ thống khi average latency liên tục tăng |
| Concurrent thread count | Số request đang được xử lý | Tránh thread resource bị dùng hết |
| Entry QPS | Kích thước entry traffic | Kiểm soát áp lực tổng thể ở entry |
Cần chú ý một điểm: system rule của Sentinel xem average RT, không phải P99. Average che khuất tail latency, nên production tốt nhất vẫn kết nối thêm monitoring cho P99, P999, thread pool, connection pool và error rate.
Gợi ý lựa chọn
| Scenario | Phương án đề xuất | Lý do |
|---|---|---|
| Project Hystrix đang tồn tại | Tiếp tục dùng trước, lên kế hoạch migration | Đừng thay chỉ vì muốn thay, ưu tiên bảo đảm ổn định |
| Project Spring Cloud Alibaba | Sentinel | Tương thích hệ sinh thái tốt, console và rule model hoàn chỉnh hơn |
| Project Dubbo | Sentinel | Chi phí tích hợp và năng lực traffic governance tương đối trưởng thành |
| Project mới Spring Boot 3 / Java 17+ | Resilience4j hoặc Sentinel | Resilience4j nhẹ hơn, Sentinel có năng lực governance hoàn chỉnh hơn |
| Chỉ cần retry | Spring Retry / Resilience4j Retry | Không cần import full governance framework chỉ vì retry |
| Cần overload protection cấp hệ thống | Sentinel, hoặc gateway / Service Mesh / platform tự xây | Sentinel hoàn chỉnh hơn trong ba lựa chọn nhưng không phải phương án duy nhất |
Nếu team đã dùng Nacos và Spring Cloud Alibaba, chi phí chọn Sentinel sẽ khá thấp. Nếu team thiên về hệ monitoring Spring Boot 3, Micrometer và Prometheus nguyên bản, Resilience4j thường tự nhiên hơn.
Cần lưu ý gì khi migration từ Hystrix sang Sentinel?
Migration project cũ từ Hystrix sang Sentinel không phải chỉ thay annotation.
1. Tách Fallback. Trong Hystrix, nhiều project chỉ có một fallbackMethod, rate limiting, circuit breaker và business exception cuối cùng đều đi chung một bộ fallback. Trong Sentinel cần phân biệt: blockHandler xử lý Sentinel rule interception (rate limiting, circuit breaker, system protection), còn fallback xử lý exception do business code ném ra. Khi migration, nên tách logic fallback cũ, đừng trộn chúng lại.
2. Isolation model khác nhau. Hystrix mặc định thread pool isolation, nhiều call thực tế chạy trong Hystrix thread pool. Sentinel thường dùng concurrent thread count control hơn, không tự nhiên chuyển downstream call sang thread pool độc lập. Sau migration cần kiểm tra lại timeout, interrupt và thread pool isolation, đặc biệt với slow downstream call; nếu không có timeout control riêng thì chỉ giới hạn bằng concurrent thread count của Sentinel là chưa đủ.
3. Cách cấu hình rule khác nhau. Nhiều rule của Hystrix được viết trong code hoặc config file. Sentinel khuyến nghị dynamic rule, chẳng hạn quản lý qua Dashboard rồi kết nối Nacos, Apollo hoặc data source khác để persist và push. Production không nên chỉ phụ thuộc vào in-memory rule của Dashboard, nếu không service hoặc console restart có thể làm mất rule.
4. Kết nối lại monitoring system. Thời Hystrix thường dùng Hystrix Dashboard + Turbine. Sau khi migration sang Sentinel, có thể trước hết dùng Sentinel Dashboard để xem realtime call và rule effect, nhưng production thường còn phải đưa metric vào Prometheus, Grafana hoặc monitoring platform nội bộ. Nếu dùng cluster rate limiting, còn phải cân nhắc deployment và availability của Token Server.
Tốt nhất migration nên thực hiện cùng lúc với major version upgrade của Spring Boot / Spring Cloud, migration riêng lẻ dễ gặp vấn đề compatibility. Nếu hệ thống hiện tại có rất nhiều Hystrix annotation, có thể thử Hystrix adapter của Sentinel để chuyển tiếp, nhưng cũng cần xem trạng thái maintenance của chính adapter trước khi quyết định.
Tóm tắt
Project mới thường không được khuyến nghị chọn Hystrix nữa vì nó đã vào maintenance mode, phù hợp hơn làm phương án chuyển tiếp cho hệ thống đang tồn tại. Nếu project đi theo stack Spring Cloud Alibaba, Nacos và Dubbo, Sentinel thường thuận tiện hơn. Nếu là project mới dùng Spring Boot 3 / Java 17+, team thiên về hệ sinh thái Micrometer, Prometheus và Reactor, Resilience4j sẽ nhẹ hơn.
Khi thật sự lựa chọn, đừng chỉ nhìn "ai có nhiều chức năng hơn"; hãy xem tech stack của team, version Spring Cloud, monitoring system, rule có cần dynamic push hay không và sau này ai sẽ maintain.