
Index mất hiệu lực do implicit conversion trong MySQL
MySQL được sử dụng trong lần kiểm thử này là phiên bản
5.7.26. Một số tính năng có thể thay đổi theo các phiên bản MySQL mới hơn. Bài viết không đảm bảo các quan điểm và kết luận nêu trên đều chính xác với mọi phiên bản MySQL; hãy tự phân biệt khác biệt giữa các phiên bản.
Lời mở đầu
Database optimization là một nhiệm vụ lâu dài và gian nan. Muốn thực hiện database optimization, bạn phải hiểu sâu các đặc tính của database. Trong quá trình phát triển, thường gặp những vấn đề có nguyên nhân rất đơn giản nhưng hậu quả lại nghiêm trọng. Những vấn đề này thường khó định vị, mất nhiều thời gian và công sức để điều tra, cuối cùng mới phát hiện nguyên nhân là một sơ suất nhỏ hoặc do không hiểu một đặc tính kỹ thuật nào đó.
Ở tầng database, vấn đề thường gặp nhất có lẽ là index mất hiệu lực, nhưng khi data còn ít thì ban đầu rất khó phát hiện. Khi nghiệp vụ mở rộng và lượng data tăng lên, vấn đề performance dần bộc lộ. Nếu không xử lý kịp thời, vấn đề rất dễ tạo hiệu ứng quả cầu tuyết, cuối cùng khiến database bị treo, thậm chí tê liệt. Có thể có rất nhiều nguyên nhân khiến index mất hiệu lực; đã có rất nhiều technical blog liên quan. Bài viết này tập trung vào vấn đề index mất hiệu lực do implicit conversion.
Chuẩn bị data
Trước tiên, dùng stored procedure để tạo 10 triệu bản ghi kiểm thử.
Bảng kiểm thử có tổng cộng 7 field (bao gồm primary key). num1 và num2 lưu các number tuần tự giống ID, trong đó num2 có type string.type1 và type2 đều lưu phần dư khi primary key chia cho 5, nhằm mô phỏng các field dạng type thường dùng trong ứng dụng thực tế, nhưng type2 không được tạo index.str1 và str2 đều lưu một string ngẫu nhiên dài 20 ký tự. str1 không cho phép NULL, còn str2 cho phép NULL. Khi tạo data kiểm thử tương ứng, tôi cũng tạo một số giá trị NULL trong field str2 (cứ 100 bản ghi có một giá trị NULL).
-- Tạo bảng dữ liệu kiểm thử
DROP TABLE IF EXISTS test1;
CREATE TABLE `test1` (
    `id` int(11) NOT NULL,
    `num1` int(11) NOT NULL DEFAULT '0',
    `num2` varchar(11) NOT NULL DEFAULT '',
    `type1` int(4) NOT NULL DEFAULT '0',
    `type2` int(4) NOT NULL DEFAULT '0',
    `str1` varchar(100) NOT NULL DEFAULT '',
    `str2` varchar(100) DEFAULT NULL,
    PRIMARY KEY (`id`),
    KEY `num1` (`num1`),
    KEY `num2` (`num2`),
    KEY `type1` (`type1`),
    KEY `str1` (`str1`),
    KEY `str2` (`str2`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
-- Tạo stored procedure
DROP PROCEDURE IF EXISTS pre_test1;
DELIMITER //
CREATE PROCEDURE `pre_test1`()
BEGIN
    DECLARE i INT DEFAULT 0;
    SET autocommit = 0;
    WHILE i < 10000000 DO
        SET i = i + 1;
        SET @str1 = SUBSTRING(MD5(RAND()),1,20);
        -- Cứ mỗi 100 bản ghi, str2 có một giá trị NULL
        IF i % 100 = 0 THEN
            SET @str2 = NULL;
        ELSE
            SET @str2 = @str1;
        END IF;
        INSERT INTO test1 (`id`, `num1`, `num2`,
        `type1`, `type2`, `str1`, `str2`)
        VALUES (CONCAT('', i), CONCAT('', i),
        CONCAT('', i), i%5, i%5, @str1, @str2);
        -- Tối ưu transaction, commit mỗi 10.000 bản ghi
        IF i % 10000 = 0 THEN
            COMMIT;
        END IF;
    END WHILE;
END;
// DELIMITER ;
-- Thực thi stored procedure
CALL pre_test1();
Lượng data khá lớn, lại dùng MD5 để tạo string ngẫu nhiên nên tốc độ hơi chậm. Hãy kiên nhẫn chờ.
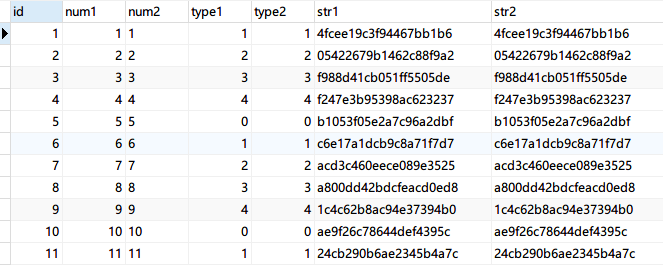
10 triệu bản ghi mất 33 phút để chạy xong trên máy của tôi (thời gian thực tế phụ thuộc vào cấu hình phần cứng máy tính). Dưới đây là một vài bản ghi được tạo, nhìn chung có dạng như sau.
Kiểm thử SQL
Trước tiên hãy xem nhóm SQL này. Có tổng cộng bốn câu lệnh. Trong bảng data kiểm thử, num1 có type int, num2 có type varchar, nhưng data được lưu đều là các number tuần tự giống primary key id; cả hai field đều được tạo index.
1: SELECT * FROM `test1` WHERE num1 = 10000;
2: SELECT * FROM `test1` WHERE num1 = '10000';
3: SELECT * FROM `test1` WHERE num2 = 10000;
4: SELECT * FROM `test1` WHERE num2 = '10000';
Bốn câu SQL này được viết có chủ đích. Các câu 1 và 2 truy vấn field có type int; các câu 3 và 4 truy vấn field có type varchar. Trong hai cặp câu 1-2 và 3-4, field được truy vấn giống nhau, nhưng một điều kiện là number còn một điều kiện là string được đặt trong dấu nháy. Sự khác biệt là gì? Trước khi xem kết quả kiểm thử bên dưới, bạn có đoán được thứ tự performance của bốn câu SQL này không?
Qua kiểm thử, thời gian thực thi của bốn câu SQL chênh lệch rất lớn. Ba câu SQL 1, 2, 4 gần như trả kết quả ngay lập tức, mất khoảng 0.001~0.005 giây. Với lượng data quy mô 10 triệu bản ghi, có thể xác định performance của ba câu này về cơ bản không có khác biệt. Tuy nhiên, câu SQL thứ ba mất khoảng 4.5~4.8 giây qua nhiều lần kiểm thử.
Vì sao performance của hai câu SQL 3 và 4 chênh lệch lớn, còn hai câu SQL 1 và 2 được so sánh tương tự lại không có khác biệt đáng kể? Hãy xem execution plan. Dưới đây là thông tin execution plan của bốn câu SQL 1, 2, 3 và 4:
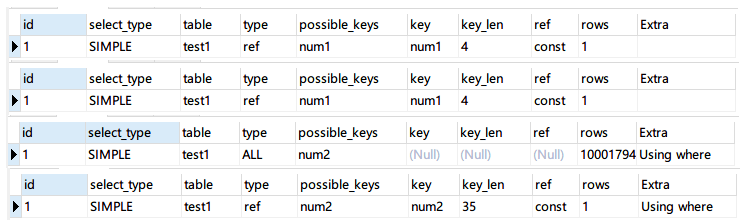
Có thể thấy ba câu SQL 1, 2 và 4 đều sử dụng được index, connection type đều là ref, số row được scan đều là 1, nên performance rất cao. Còn câu SQL thứ ba không sử dụng index nên phải full table scan, rows tăng thẳng lên 10 triệu. Vì vậy performance mới chênh lệch lớn.
Quan sát kỹ sẽ thấy field num2 được truy vấn trong hai câu SQL 3 và 4 có type varchar. Ở câu SQL thứ 4, điều kiện bên phải dấu bằng được đặt trong dấu nháy và câu lệnh sử dụng được index. Vậy có phải nguyên nhân là data type truy vấn không giống data type của field không? Nếu vậy, field num1 được truy vấn trong hai câu SQL 1 và 2 có type int, nhưng tại sao điều kiện của câu SQL thứ 2 được đặt trong dấu nháy mà vẫn sử dụng được index?
Tra cứu tài liệu liên quan đến MySQL cho thấy nguyên nhân là implicit conversion. Hãy xem mô tả chính thức:
Tài liệu chính thức: 12.2 Type Conversion in Expression Evaluation
Khi operator được sử dụng với các operand khác type, type conversion xảy ra để các operand tương thích với nhau. Một số conversion diễn ra implicit. Ví dụ, MySQL tự động convert string thành number hoặc ngược lại khi cần. Các quy tắc dưới đây mô tả cách convert trong phép so sánh:
- Khi ít nhất một trong hai parameter là
NULL, kết quả so sánh cũng làNULL. Trường hợp đặc biệt là khi dùng<=>để so sánh haiNULL, kết quả trả về là1; cả hai trường hợp này đều không cần type conversion.- Khi cả hai parameter đều là string, chúng được so sánh dưới dạng string và không xảy ra type conversion.
- Khi cả hai parameter đều là integer, chúng được so sánh dưới dạng integer và không xảy ra type conversion.
- Khi so sánh giá trị hexadecimal với giá trị không phải number, giá trị hexadecimal được xem là binary string.
- Khi một parameter là
TIMESTAMPhoặcDATETIMEvà parameter còn lại là constant, constant sẽ được convert thànhtimestamp.- Khi một parameter có type
decimal, nếu parameter còn lại làdecimalhoặc integer, integer sẽ được convert thànhdecimalrồi so sánh; nếu parameter còn lại là floating-point number,decimalsẽ được convert thành floating-point number để so sánh.- Trong mọi trường hợp khác, cả hai parameter đều được convert thành floating-point number rồi so sánh.
Theo mô tả trong tài liệu chính thức, hai câu SQL 2 và 3 đều xảy ra implicit conversion. Trong điều kiện num1 = '10000' của câu SQL thứ 2, bên trái có type int còn bên phải là string; câu SQL thứ 3 thì ngược lại. Theo quy tắc conversion thứ 7, cả hai bên đều được convert thành floating-point number rồi so sánh.
Trước tiên xem câu SQL thứ 2: SELECT * FROM `test1` WHERE num1 = '10000';. Bên trái là giá trị 10000 có type int, convert thành floating-point number vẫn là 10000; bên phải là string '10000', convert thành floating-point number cũng là 10000. Kết quả conversion của hai bên đều xác định duy nhất, nên không ảnh hưởng đến việc sử dụng index.
Câu SQL thứ 3: SELECT * FROM `test1` WHERE num2 = 10000;. Bên trái là string '10000', convert thành floating-point number cho kết quả duy nhất là 10000; kết quả conversion của 10000 bên phải có type int cũng là duy nhất. Tuy nhiên, vì bên trái là field được truy vấn, dù '10000' convert thành 10000 là duy nhất, các string khác cũng có thể convert thành 10000, chẳng hạn '10000a', '010000', '10000' đều có thể convert thành floating-point number 10000. Trong trường hợp này, index không thể được sử dụng.
Chúng ta có thể kiểm chứng implicit conversion này bằng truy vấn kiểm thử. Trước tiên chèn một vài bản ghi, trong đó num2='10000a', '010000' và '10000':
INSERT INTO `test1` (`id`, `num1`, `num2`, `type1`, `type2`, `str1`, `str2`) VALUES ('10000001', '10000', '10000a', '0', '0', '2df3d9465ty2e4hd523', '2df3d9465ty2e4hd523');
INSERT INTO `test1` (`id`, `num1`, `num2`, `type1`, `type2`, `str1`, `str2`) VALUES ('10000002', '10000', '010000', '0', '0', '2df3d9465ty2e4hd523', '2df3d9465ty2e4hd523');
INSERT INTO `test1` (`id`, `num1`, `num2`, `type1`, `type2`, `str1`, `str2`) VALUES ('10000003', '10000', ' 10000', '0', '0', '2df3d9465ty2e4hd523', '2df3d9465ty2e4hd523');
Sau đó dùng câu SQL thứ ba SELECT * FROM `test1` WHERE num2 = 10000; để truy vấn:
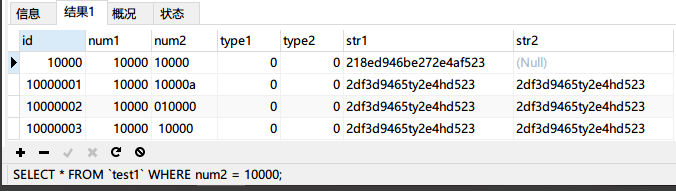
Có thể thấy từ kết quả rằng ba bản ghi vừa chèn cũng đều khớp. Vậy quy tắc implicit conversion của string là gì? Vì sao cả ba trường hợp num2='10000a', '010000' và '10000' đều khớp? Sau khi tra cứu tài liệu liên quan, các quy tắc như sau:
- Các string không bắt đầu bằng number đều được convert thành
0. Ví dụ,'abc','a123bc','abc123'đều được convert thành0. - Khi convert string bắt đầu bằng number, string sẽ được lấy từ ký tự đầu tiên đến trước ký tự đầu tiên không phải number. Ví dụ,
'123abc'được convert thành123,'012abc'được convert thành012, tức12,'5.3a66b78c'được convert thành5.3, các trường hợp khác cũng tương tự.
Hãy kiểm chứng các quy tắc trên bằng các kiểm thử sau:

Như vậy, kết quả truy vấn trước đó đã được xác nhận.
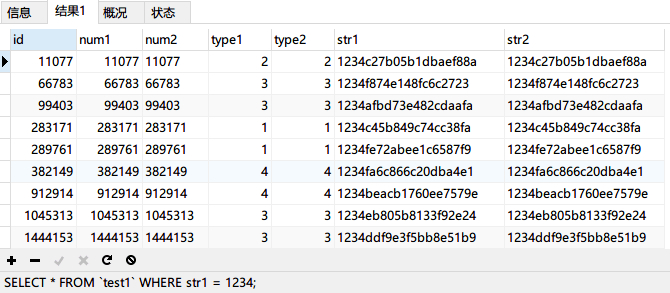
Tiếp tục viết một câu SQL để truy vấn field str1: SELECT * FROM `test1` WHERE str1 = 1234;
Phân tích và tổng kết
Qua các kiểm thử trên, có thể rút ra một số đặc tính của MySQL khi sử dụng operator:
- Khi data type ở hai bên của operator không giống nhau, implicit conversion sẽ xảy ra.
- Khi xảy ra implicit conversion và bên trái của operator trong
WHEREcó type number, ảnh hưởng đến performance không lớn, nhưng vẫn không khuyến nghị làm như vậy. - Khi xảy ra implicit conversion và bên trái của operator trong
WHEREcócharacter type, index sẽ mất hiệu lực, dẫn đến full table scan với performance cực thấp. - Khi string được convert thành number, string không bắt đầu bằng number sẽ được convert thành
0; string bắt đầu bằng number sẽ được lấy từ ký tự đầu tiên đến trước ký tự đầu tiên không phải number, và giá trị đó là kết quả conversion.
Vì vậy, khi viết SQL, cần hình thành thói quen tốt: field được truy vấn có type nào thì điều kiện bên phải dấu bằng cũng phải dùng type tương ứng. Đặc biệt khi field được truy vấn là string, điều kiện bên phải dấu bằng nhất định phải đặt trong dấu nháy để biểu thị đây là string; nếu không, index sẽ mất hiệu lực và dẫn đến full table scan.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.