
TCP bảo đảm truyền tải tin cậy như thế nào? Giải thích chi tiết về retransmission, sliding window và congestion control
TCP thường được gọi là giao thức truyền tải tin cậy, nhưng “tin cậy” không phải một lời hứa trừu tượng, mà là kết quả phối hợp của một nhóm cơ chế cụ thể.
Mất packet thì phải retransmission, packet đến không đúng thứ tự thì phải sắp xếp lại, bên nhận xử lý không kịp thì cần flow control, network bị congestion thì phải chủ động giảm tốc. Chỉ khi xâu chuỗi các cơ chế này lại, bạn mới thực sự hiểu vì sao TCP có thể cung cấp truyền tải tin cậy trên nền mạng IP không tin cậy.
Bài viết này chủ yếu trả lời một số câu hỏi:
- TCP dùng những cơ chế nào để bảo đảm dữ liệu đến đích một cách tin cậy?
- Retransmission do timeout, fast retransmission, SACK và D-SACK lần lượt giải quyết vấn đề gì?
- TCP thực hiện flow control thông qua sliding window như thế nào?
- Slow start, congestion avoidance, fast retransmission và fast recovery trong congestion control nên được hiểu như thế nào?
Trước hết cần làm rõ một điểm dễ gây hiểu lầm: TCP bảo đảm độ tin cậy cho byte stream, không phải từng “message” của application layer. TCP không giữ lại ranh giới message trong HTTP, RPC hay business protocol; việc TCP làm là đánh số byte stream và cố gắng chuyển các byte này đến application layer theo đúng thứ tự, không trùng lặp. Còn “một request bắt đầu từ đâu, kết thúc ở đâu” thì phải do protocol tầng trên tự định nghĩa, chẳng hạn như length field, delimiter, format của HTTP message.
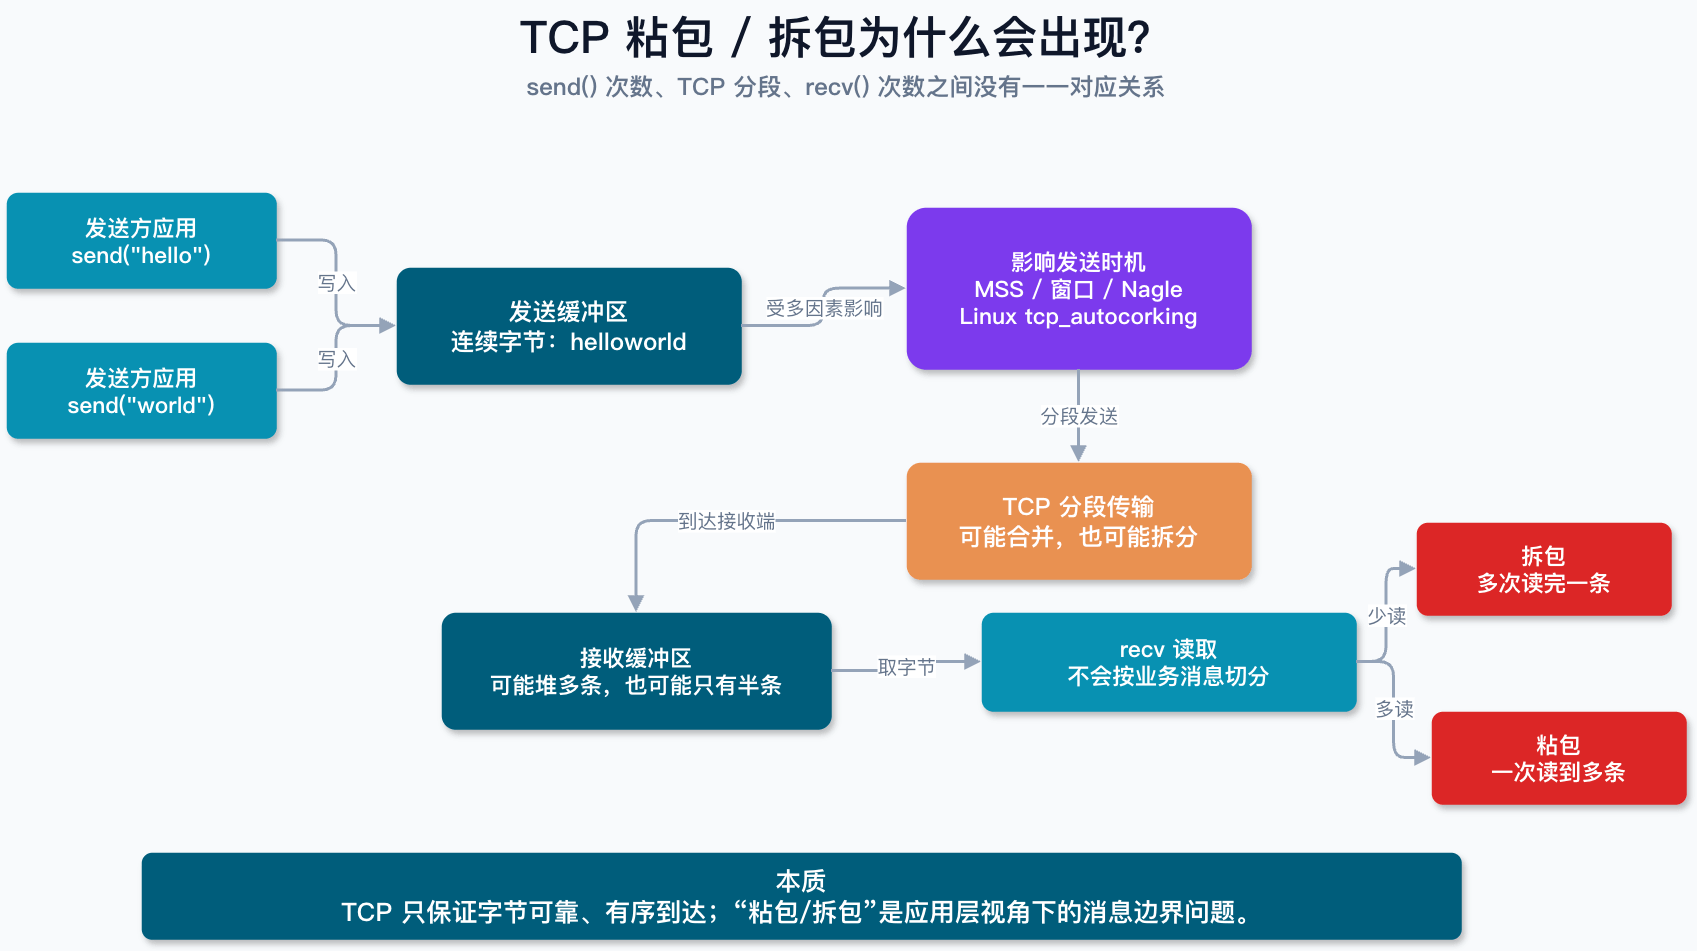
TCP bảo đảm độ tin cậy của truyền tải như thế nào?
- Truyền dựa trên data block: Application data được chia thành các data block mà TCP cho là phù hợp nhất để gửi, sau đó truyền tới network layer; data block được gọi là segment.
- Sắp xếp lại và loại bỏ dữ liệu trùng lặp do đến sai thứ tự: TCP không thể ngăn network làm mất packet; việc TCP có thể làm là đánh số byte stream, đồng thời thông qua các cơ chế như ACK, retransmission, sắp xếp và loại bỏ trùng lặp để application layer nhìn thấy một data stream có thứ tự, không trùng lặp. Sequence number của TCP về bản chất là byte number, không phải đánh số lần lượt từng segment. Mỗi TCP segment mang một đoạn byte liên tiếp, bên nhận dựa vào các khoảng sequence number này để sắp xếp lại và loại bỏ trùng lặp.
- Checksum: TCP tính checksum cho TCP header, data và IP pseudo-header. Đây là checksum end-to-end, nhằm phát hiện dữ liệu thay đổi trong quá trình truyền. Nếu checksum của segment nhận được bị lỗi, TCP sẽ loại bỏ segment đó và không xác nhận đã nhận nó. Tuy nhiên, TCP checksum chỉ là phép cộng bù một 16-bit, chủ yếu dùng để phát hiện các lỗi truyền tải thường gặp; nó không phải integrity check mạnh và cũng không ngăn được việc sửa đổi có chủ đích. Trong hệ thống thực tế, data integrity thường còn dựa vào CRC của link layer, TLS AEAD hoặc hash ở application layer.
- Cơ chế retransmission: Khi TCP segment bị mất hoặc trễ, dữ liệu được gửi lại cho đến khi nhận được ACK từ phía bên kia. Cơ chế retransmission của TCP chủ yếu gồm: retransmission dựa trên timer (tức retransmission do timeout), fast retransmission (kích hoạt retransmission dựa trên feedback từ bên nhận), SACK (Selective Acknowledgment, mang trong ACK option các khoảng data block không liên tiếp đã nhận, để bên gửi biết segment nào đã đến bên nhận) và D-SACK (Duplicate SACK, trên cơ sở SACK còn thông báo cho bên gửi segment nào đã bị nhận trùng). Giá trị của D-SACK nằm ở việc giúp bên gửi phán đoán một lần retransmission có thể là “retransmission nhầm” hay không: chẳng hạn dữ liệu gốc thực ra đã đến bên nhận, chỉ là ACK bị mất, network bị reorder hoặc retransmission timer kích hoạt quá sớm, khiến bên gửi lầm tưởng packet bị mất và kích hoạt retransmission. Bên nhận thông báo cho bên gửi bằng D-SACK rằng “tôi đã nhận trùng đoạn dữ liệu này”, từ đó bên gửi có thể suy ra lần retransmission này có thể chỉ là phán đoán nhầm, chứ chưa chắc đã thực sự xảy ra congestion. Tuy nhiên, D-SACK chỉ cung cấp manh mối, không thể tự mình chứng minh một nguyên nhân cụ thể nào.
- Flow control: Mỗi phía của TCP connection đều có một vùng buffer với kích thước nhất định. Bên nhận thông báo cho bên gửi qua receive window (rwnd) rằng mình còn có thể nhận bao nhiêu data, bên gửi dựa vào đó điều chỉnh sending rate để tránh bên nhận xử lý không kịp và làm mất packet.
- Congestion control: Khi network congestion, giảm lượng data gửi đi. Khi gửi data, TCP cần cân nhắc hai yếu tố: một là khả năng của receive buffer hiện có ở bên nhận, hai là mức độ congestion của network. Khả năng nhận của bên nhận được biểu thị bằng receive window (rwnd), còn mức độ congestion của network được biểu thị bằng congestion window (cwnd). Lượng unacknowledged data mà bên gửi cho phép duy trì trong network thường bị giới hạn bởi
min(rwnd, cwnd), nhờ đó vừa không vượt quá khả năng xử lý của bên nhận, vừa không đưa quá nhiều data vào network.
Trước hết, hãy dùng ARQ để hiểu TCP retransmission
Trong các cơ chế trên, retransmission thể hiện rõ nhất “truyền tải tin cậy”. Để các khái niệm như retransmission do timeout, fast retransmission và SACK không xuất hiện một cách rời rạc, trước tiên hãy xem mô hình trừu tượng ARQ.
Automatic Repeat-reQuest (ARQ) là một trong các protocol sửa lỗi ở data link layer và transport layer của mô hình OSI. Nó sử dụng hai cơ chế acknowledgment và timeout để thực hiện truyền thông tin tin cậy trên nền một service không tin cậy. Nếu sau một khoảng thời gian kể từ khi gửi mà bên gửi không nhận được acknowledgment (Acknowledgments, ACK), nó thường sẽ gửi lại cho đến khi nhận được acknowledgment hoặc số lần retry vượt quá một giới hạn nhất định.
Có thể dùng tư tưởng ARQ để hiểu TCP, nhưng TCP không phải một dạng ARQ đơn giản nào đó trong giáo trình. TCP hiện đại đồng thời kết hợp cumulative ACK, RTO, fast retransmission, SACK, congestion control và flow control; chiến lược retransmission chịu ảnh hưởng tổng hợp của các cơ chế này.
- ACK mặc định là cumulative acknowledgment: ACK biểu thị “tôi đã nhận toàn bộ data trước sequence number này”.
- Khi bật SACK, bên nhận còn có thể thông báo thêm cho bên gửi “tôi đã nhận được những khoảng nào không theo thứ tự”, để bên gửi chỉ retransmission các segment bị thiếu.
Vì vậy, Stop-and-Wait ARQ và Go-Back-N phù hợp hơn để hiểu tư tưởng nền tảng của truyền tải tin cậy, còn TCP hiện đại với sự hỗ trợ của SACK gần với Selective Repeat hơn.
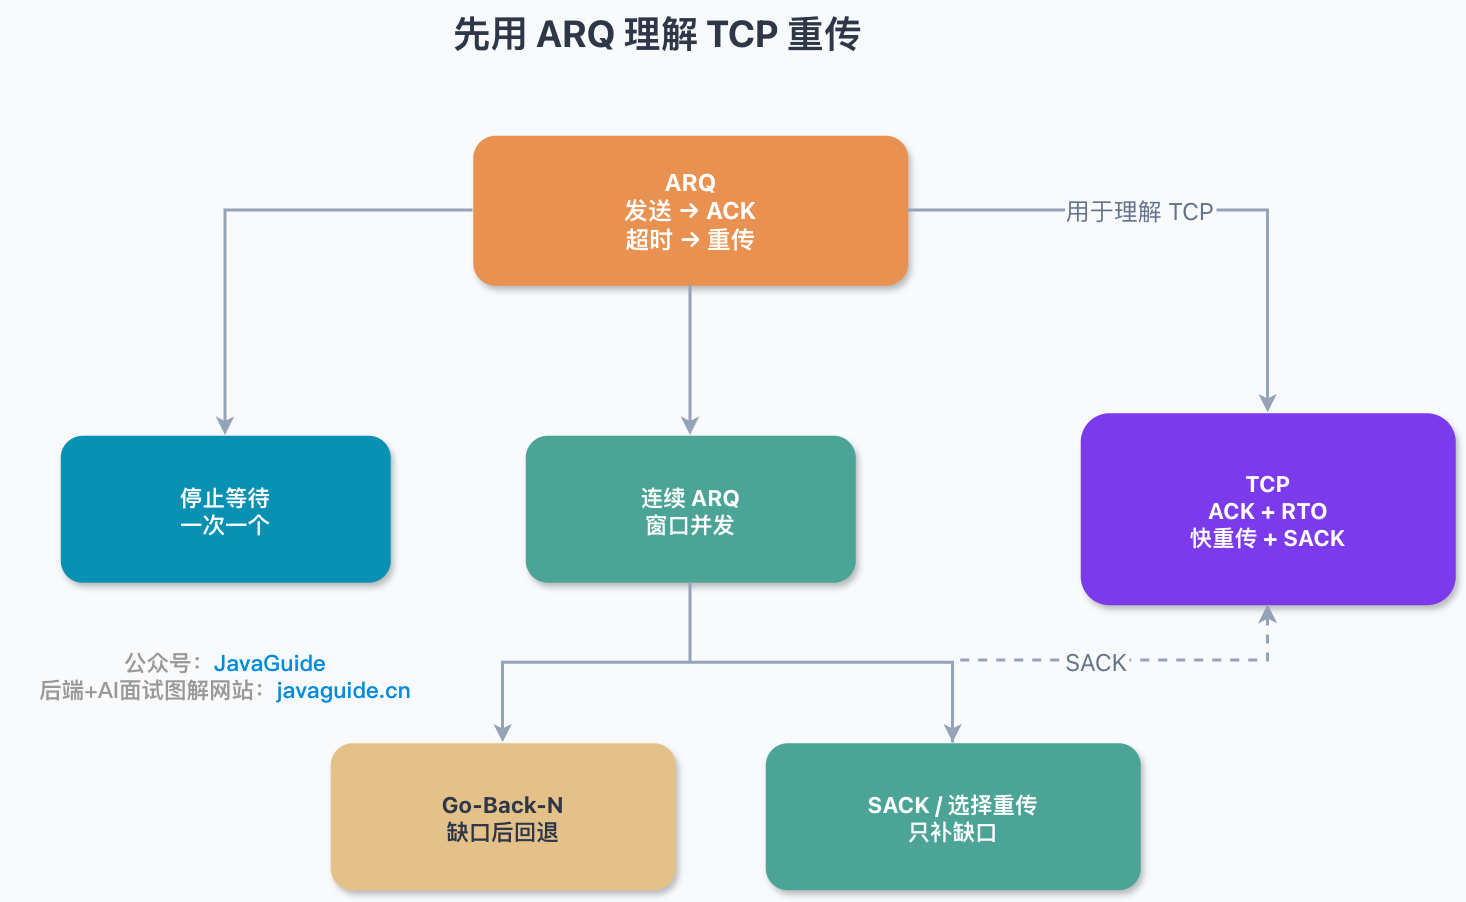
ARQ gồm Stop-and-Wait ARQ và Continuous ARQ.
Stop-and-Wait ARQ
Stop-and-Wait protocol được dùng để thực hiện truyền tải tin cậy. Nguyên lý cơ bản là sau khi gửi xong mỗi packet thì dừng gửi và chờ acknowledgment từ phía bên kia (trả lời ACK). Nếu sau một khoảng thời gian (sau timeout) vẫn không nhận được ACK, điều đó cho thấy việc gửi chưa thành công, cần gửi lại cho đến khi nhận được acknowledgment rồi mới gửi packet tiếp theo.
Trong Stop-and-Wait protocol, nếu bên nhận nhận được packet trùng lặp thì loại bỏ packet đó, nhưng đồng thời vẫn phải gửi acknowledgment.
1) Trường hợp không có lỗi:
Bên gửi gửi packet, bên nhận nhận được trong thời gian quy định và trả lời acknowledgment. Bên gửi tiếp tục gửi packet tiếp theo.
2) Xuất hiện lỗi (retransmission do timeout):
Trong Stop-and-Wait protocol, retransmission do timeout nghĩa là chỉ cần quá một khoảng thời gian mà vẫn chưa nhận được acknowledgment thì sẽ gửi lại packet đã gửi trước đó (cho rằng packet vừa gửi bị mất). Vì vậy, sau mỗi lần gửi packet cần thiết lập timer timeout; thời gian retransmission nên dài hơn một chút so với round-trip time trung bình của packet trong quá trình truyền. Cách retransmission tự động này thường được gọi là Automatic Repeat-reQuest (ARQ). Ngoài ra, trong Stop-and-Wait protocol, nếu nhận được packet trùng lặp thì loại bỏ packet đó, nhưng đồng thời vẫn phải gửi acknowledgment.
3) Acknowledgment bị mất và acknowledgment đến trễ
- Acknowledgment bị mất: Acknowledgment bị mất trong quá trình truyền. Khi A gửi message M1, sau khi B nhận được, B gửi acknowledgment cho message M1 tới A nhưng bị mất trong quá trình truyền. A không biết điều đó; sau khi timeout, A retransmission message M1. Sau khi B nhận lại message này, nó thực hiện hai việc: 1. Loại bỏ message M1 trùng lặp, không chuyển lên upper layer. 2. Gửi acknowledgment tới A. (Không phải vì đã gửi acknowledgment trước đó mà B không cần gửi lại. Việc A retransmission chứng tỏ acknowledgment của B đã bị mất.)
- Acknowledgment đến trễ: Acknowledgment đến trễ trong quá trình truyền. A gửi message M1, B nhận và gửi acknowledgment. Trong thời gian chờ timeout, A không nhận được acknowledgment nên retransmission message M1; B vẫn nhận được và tiếp tục gửi acknowledgment (B nhận 2 bản M1). Lúc này A nhận được acknowledgment lần thứ hai do B gửi. Sau đó A gửi data khác. Một lúc sau, A nhận được acknowledgment lần thứ nhất của B cho M1 (A cũng nhận 2 bản acknowledgment). Xử lý như sau: 1. A nhận acknowledgment trùng lặp thì trực tiếp loại bỏ. 2. B nhận M1 trùng lặp thì cũng trực tiếp loại bỏ M1 trùng lặp.
Continuous ARQ
Continuous ARQ là một nhóm tư tưởng retransmission theo sliding window, với các dạng điển hình gồm Go-Back-N và Selective Repeat. Nó có thể nâng cao hiệu suất sử dụng channel: bên gửi duy trì một sending window, các packet nằm trong sending window có thể được gửi liên tục mà không cần chờ acknowledgment từ phía bên kia. Bên nhận thường dùng cumulative acknowledgment, gửi acknowledgment cho packet cuối cùng đến theo đúng thứ tự để biểu thị rằng toàn bộ packet từ đầu đến packet này đã được nhận chính xác.
- Ưu điểm: hiệu suất sử dụng channel cao, dễ triển khai; ngay cả khi acknowledgment bị mất cũng không cần retransmission.
- Nhược điểm: nếu dùng Go-Back-N, không thể phản ánh cho bên gửi thông tin về toàn bộ packet mà bên nhận đã nhận chính xác. Ví dụ: bên gửi gửi 5 message, message thứ ba bị mất (số 3). Trong Go-Back-N, dù packet số 4 và 5 đã đến, bên nhận vẫn loại bỏ chúng vì sai thứ tự và chỉ lặp lại acknowledgment cho packet cuối cùng nhận đúng thứ tự là packet số 2. Cuối cùng bên gửi phải quay lại từ packet số 3 để retransmission. Vai trò của SACK chính là để bên nhận TCP thông báo cho bên gửi các khoảng data không liên tiếp nhưng đã nhận được, tránh nhiều lần retransmission quay lui không cần thiết.
Sau khi đã đi theo mạch ARQ, việc xem cơ chế retransmission cụ thể của TCP sẽ dễ hiểu hơn.
Tra nhanh cơ chế TCP retransmission
TCP không chỉ có một cách kích hoạt retransmission. Cơ bản nhất là retransmission do timeout: bên gửi chờ ACK quá lâu thì cho rằng đoạn data này có thể đã mất, rồi retransmission. Sau đó có fast retransmission: bên nhận liên tục ACK cùng một sequence number cũ, cho thấy ở giữa có thể thiếu một đoạn, vì vậy bên gửi không cần chờ timeout một cách bị động. SACK và D-SACK bổ sung thêm thông tin trong ACK, để bên gửi biết “segment nào đã đến, lần retransmission nào có thể là phán đoán nhầm”.
Vì vậy, bảng dưới đây không đưa ra kiến thức mới mà là một bản đồ: trước tiên đặt các cơ chế liên quan đến retransmission cạnh nhau, sau đó lần lượt triển khai từ RTO retransmission do timeout, cơ chế cơ bản nhất và cũng là phương án dự phòng cuối cùng.
| Cơ chế | Điều kiện kích hoạt | Giải quyết vấn đề gì |
|---|---|---|
| Retransmission do timeout (RTO) | Vượt quá RTO mà vẫn chưa nhận được ACK | Xử lý dự phòng khi packet bị mất |
| Fast retransmission | Nhận 3 duplicate ACK, tức liên tục xác nhận cùng một cumulative ACK number cũ | Không chờ timeout, nhanh chóng retransmission segment nghi đã mất |
| SACK | ACK mang theo các khoảng data đã nhận | Cho bên gửi biết segment nào đã nhận, chỉ retransmission phần thực sự thiếu |
| D-SACK | SACK báo cáo segment đã nhận trùng lặp | Giúp nhận diện retransmission nhầm, ACK bị mất hoặc network reorder |
Retransmission do timeout được thực hiện như thế nào? Thời gian retransmission do timeout được xác định ra sao?
Hãy xem dòng đầu tiên trong bảng: retransmission do timeout (RTO). Đây là phương án dự phòng của cơ chế TCP retransmission. Bất kể có SACK hay có kích hoạt fast retransmission hay không, chỉ cần sau khi gửi một đoạn data mà vẫn chưa nhận được ACK thì cuối cùng vẫn phải dựa vào RTO để phán đoán “không thể chờ thêm nữa, cần retransmission”.
Khi bên gửi gửi data, nó khởi động một timer để chờ bên đích xác nhận đã nhận segment này. Bên nhận gửi ACK tương ứng cho TCP segment đã nhận thành công. Nếu trong một round-trip time (RTT) hợp lý mà bên gửi chưa nhận được acknowledgment, segment tương ứng được xem là có thể đã mất và sẽ được retransmission.
- RTT (Round Trip Time): thời gian khứ hồi, tức thời gian từ lúc TCP segment được gửi đi đến lúc nhận ACK tương ứng.
- RTO (Retransmission Time Out): thời gian timeout để retransmission, tức kể từ thời điểm gửi data, khi vượt quá thời gian này thì thực hiện retransmission.
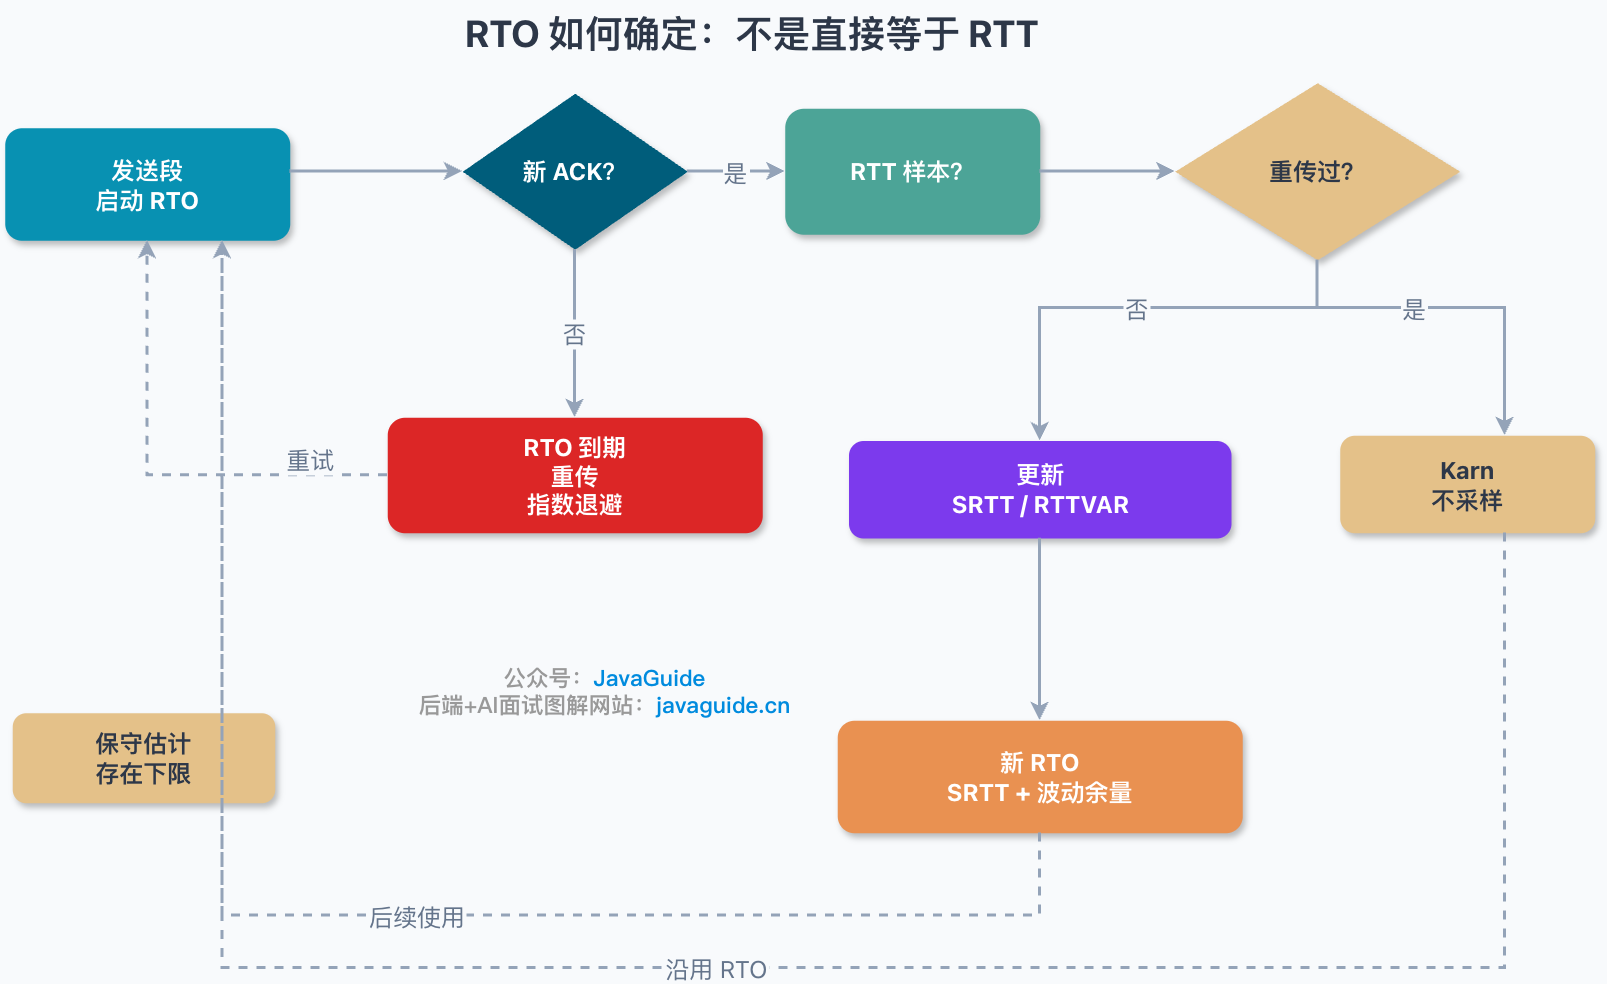
Xác định RTO là một vấn đề then chốt vì nó ảnh hưởng trực tiếp đến performance và efficiency của TCP. Nếu đặt RTO quá nhỏ, retransmission không cần thiết sẽ làm tăng gánh nặng cho network; nếu đặt RTO quá lớn, latency truyền data sẽ tăng và throughput giảm. Vì vậy, RTO nên được điều chỉnh động dựa trên tình trạng thực tế của network.
Giá trị RTT thay đổi theo biến động của network, nên TCP không thể trực tiếp dùng một RTT sample bất kỳ làm RTO. Việc tính RTO của TCP hiện đại nên lấy RFC 6298 làm cơ sở: duy trì smoothed round-trip time SRTT và round-trip time variation RTTVAR dựa trên RTT sample, sau đó tính RTO; sau khi timeout còn thực hiện exponential backoff.
Điểm cốt lõi của thuật toán Karn là: với segment đã retransmission, ACK của nó không được dùng để lấy RTT sample, tránh sự mơ hồ của sample “ACK này tương ứng với lần gửi gốc hay lần retransmission”.
Hiểu đơn giản, RTO không phải RTT, mà là “RTT đã được làm mượt + phần bù jitter”. Nếu RTT sample của một connection xấp xỉ 100 ms nhưng jitter lớn, RTO phải chừa ra một phần bù an toàn lớn hơn; nếu vẫn timeout, RTO lần sau tiếp tục backoff, tránh tăng thêm áp lực retransmission lên network khi đang congestion.
Fast retransmission hoạt động như thế nào?
Retransmission do timeout đáng tin cậy nhưng chậm, vì bên gửi phải chờ RTO hết hạn rồi mới retransmission. Fast retransmission (Fast Retransmit) giải quyết vấn đề chờ đợi này: nó không phụ thuộc vào timer, mà dựa trên duplicate ACK liên tục do bên nhận gửi về để phát hiện sớm hơn packet nghi bị mất.
TCP sử dụng cumulative acknowledgment. Giả sử bên nhận đã nhận theo thứ tự đoạn byte [0, 1000), tiếp theo mong nhận data bắt đầu từ 1000. Nếu trước tiên nó nhận được [2000, 3000), điều đó cho thấy đoạn [1000, 2000) ở giữa chưa đến. Bên nhận không đẩy ACK lên 3000 mà tiếp tục trả lời ACK = 1000, biểu thị “tôi vẫn đang chờ data sau 1000”. Packet xác nhận lại cùng một ACK number cũ như vậy chính là duplicate ACK.
Nếu bên gửi liên tục nhận 3 duplicate ACK, nó thường cho rằng đoạn data mà ACK trỏ tới rất có khả năng đã mất, nên không chờ RTO timeout mà trực tiếp retransmission segment bị thiếu. Lý do không retransmission ngay khi nhận 1 duplicate ACK là vì network có thể xảy ra reorder tạm thời: packet gửi sau đến trước không nhất thiết có nghĩa packet trước thực sự bị mất. 3 duplicate ACK là sự cân bằng giữa “khôi phục nhanh” và “tránh phán đoán nhầm do reorder”.
Fast retransmission chỉ có thể nhanh chóng định vị “khoảng thiếu sớm nhất”. Nếu trong một sending window đồng thời mất nhiều đoạn data, chỉ dựa vào cumulative ACK vẫn rất khó cho bên gửi biết khoảng nào đã đến và khoảng nào còn thiếu; khi đó cần SACK.
SACK nâng cao hiệu suất retransmission như thế nào?
SACK (Selective Acknowledgment) dùng để bổ sung vùng mù thông tin của cumulative ACK. ACK thông thường chỉ biểu đạt “toàn bộ data trước một sequence number nào đó đã nhận”, nhưng không thể biểu đạt “một số khoảng phía sau dù đến không theo thứ tự nhưng đã nhận”. SACK mang các khoảng byte không liên tiếp đã nhận trong TCP option của ACK, giúp bên gửi chỉ retransmission phần thực sự thiếu.
SACK cần được thương lượng qua option SACK-Permitted trong three-way handshake. Sau khi bật, bản thân ACK number vẫn tuân theo quy tắc cumulative acknowledgment; SACK option bổ sung một hoặc nhiều SACK block. Mỗi SACK block gồm Left Edge và Right Edge, biểu thị khoảng byte [Left Edge, Right Edge) mà bên nhận đã nhận được.
Ví dụ: bên gửi liên tục gửi [0, 1000), [1000, 2000), [2000, 3000), [3000, 4000), trong đó [1000, 2000) bị mất nhưng hai đoạn sau đã đến. Cumulative ACK của bên nhận vẫn chỉ dừng ở ACK = 1000, nhưng có thể báo cáo trong SACK rằng đã nhận [2000, 4000). Dựa vào đó bên gửi biết [1000, 2000) cần retransmission, còn [2000, 4000) không cần gửi lại.
Độ dài TCP option có giới hạn. Bản thân SACK option cần 2 byte, mỗi SACK block cần 8 byte, vì vậy một TCP segment nhiều nhất mang được 4 SACK block; nếu đồng thời mang các TCP option khác như timestamp thì không gian sử dụng còn ít hơn. Nói cách khác, SACK không thể ghi lại vô hạn mọi khoảng đến sai thứ tự, nhưng đã đủ để giảm đáng kể retransmission không hiệu quả khi mất nhiều segment.
D-SACK có tác dụng gì?
D-SACK (Duplicate SACK) là phần mở rộng của SACK, được định nghĩa trong RFC 2883. SACK chủ yếu nói cho bên gửi biết “những khoảng không liên tiếp nào đã nhận”, còn D-SACK nói thêm cho bên gửi biết “những khoảng nào đã bị nhận trùng lặp”.
D-SACK không đưa vào TCP option mới mà tái sử dụng SACK block. Quy ước là: nếu SACK block đầu tiên mô tả một đoạn data đã được cumulative ACK bao phủ, hoặc mô tả một đoạn đã xuất hiện trong SACK block tiếp theo, thì block này đang báo cáo data trùng lặp.
Vì sao data trùng lặp có giá trị? Vì một lần retransmission không nhất thiết có nghĩa data gốc thực sự bị mất. Các trường hợp thường gặp gồm:
- Data gốc đã đến bên nhận, nhưng ACK bị mất trên đường quay về; bên gửi chờ đến RTO rồi lầm tưởng data bị mất và retransmission.
- Data gốc bị reorder hoặc trễ nghiêm trọng trong network; bên gửi kích hoạt fast retransmission trước, sau đó data gốc và data retransmission đều đến bên nhận.
Sau khi nhận D-SACK, bên gửi có thể suy ra lần retransmission này có thể là retransmission nhầm, đồng thời phán đoán thêm trong network có xảy ra mất ACK, reorder nghiêm trọng hoặc RTO đặt quá nhỏ hay không. Nó không thể tự mình chứng minh một nguyên nhân cụ thể, nhưng có thể cung cấp manh mối quan trọng cho congestion control và việc điều tra nguyên nhân retransmission bất thường.
TCP thực hiện flow control như thế nào?
TCP dùng sliding window để thực hiện flow control. Flow control nhằm điều khiển sending rate của bên gửi, bảo đảm bên nhận kịp nhận. Sliding window là một trong các cơ chế cốt lõi của TCP; nó vừa dùng để theo dõi “data nào đã gửi nhưng chưa được ACK”, vừa dùng để thực hiện flow control. Bên nhận thông báo receive window (rwnd) của mình trong ACK packet thông qua window field, bên gửi dựa vào đó điều chỉnh sending window. Đặt window field bằng 0 nghĩa là bên nhận tạm thời không có buffer khả dụng, bên gửi không thể tiếp tục gửi data mới.
Window field trong TCP header vốn là 16 bit, tối đa chỉ biểu thị được 65,535 byte. Nếu cần receive window lớn hơn, còn phải dựa vào TCP Window Scale option để mở rộng kích thước window. Khi điều tra thực tế, có thể xem trong SYN/SYN-ACK packet của three-way handshake hai bên có thương lượng Window Scale hay không.
Zero window khôi phục như thế nào? Khi bên nhận thông báo rwnd = 0, bên gửi sẽ tạm dừng gửi data mới. Nhưng nếu sau đó bên nhận giải phóng được buffer và gửi window announcement mới, còn ACK này bị mất trong network, hai bên có thể rơi vào trạng thái chờ lẫn nhau: bên gửi chờ window mở, bên nhận chờ data mới đến.
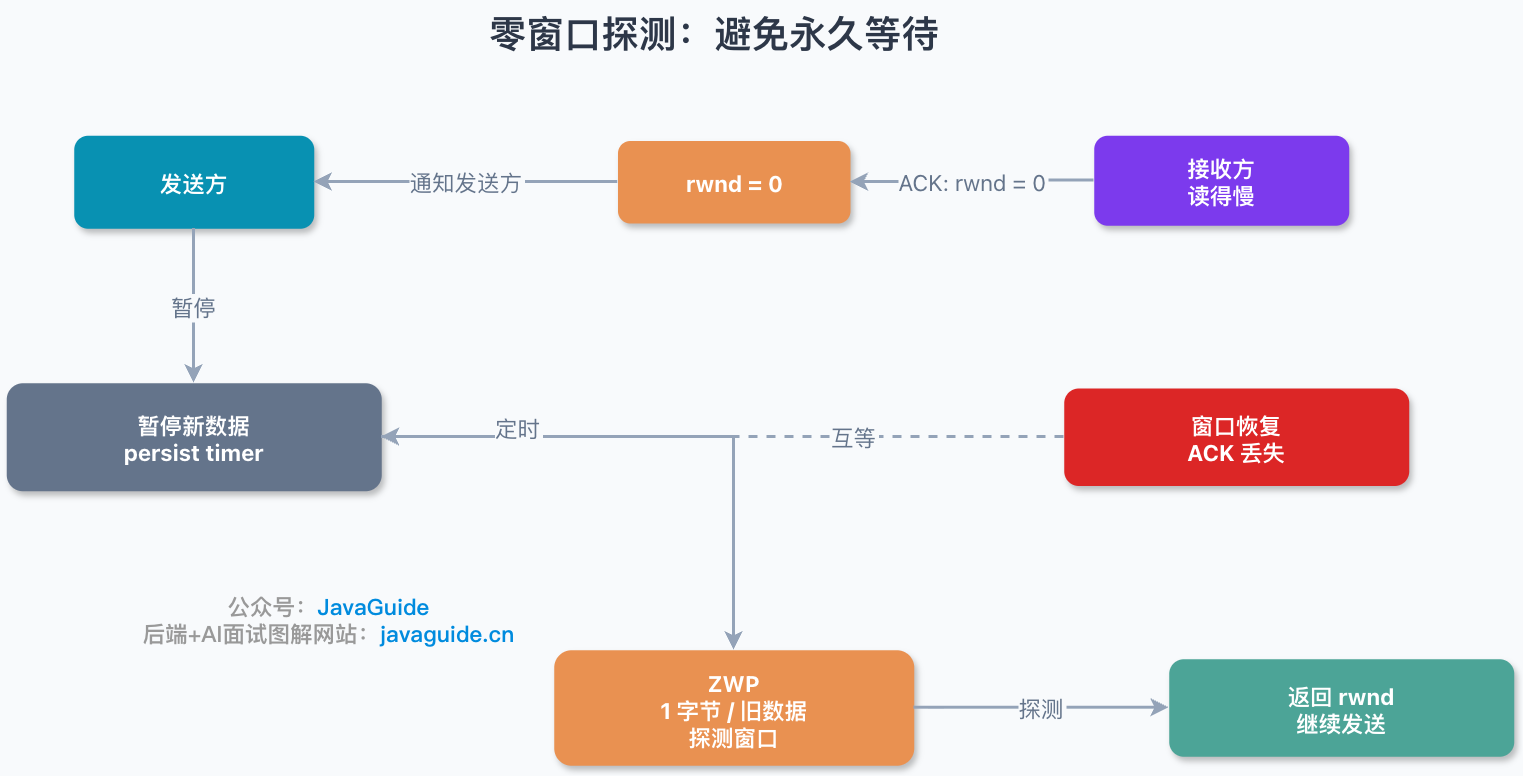
Để giải quyết vấn đề này, TCP đưa vào zero window probe (Zero Window Probe). Khi window bằng 0, bên gửi dựa vào persist timer để định kỳ gửi probe packet rất nhỏ, buộc bên nhận trả lời kích thước window hiện tại. Nhờ vậy, ngay cả khi window update ACK trước đó bị mất, bên gửi vẫn có thể biết lại window đã mở hay chưa.
Zero window probe chỉ chịu trách nhiệm phá vỡ trạng thái bế tắc do “window update ACK bị mất”, không đồng nghĩa với health check của connection ở business layer. Nếu application ở bên nhận không đọc socket trong thời gian dài, connection có thể duy trì lâu ở trạng thái window nhỏ hoặc zero window, đồng thời vẫn chiếm tài nguyên của hai bên. Trong thực tế triển khai thường vẫn cần các cơ chế dự phòng như read/write timeout ở application layer và thu hồi idle connection.
Vì sao cần flow control? Vì khi hai bên giao tiếp, sending rate của bên gửi và receiving rate của bên nhận không nhất thiết bằng nhau. Nếu sending rate của bên gửi quá nhanh, bên nhận sẽ xử lý không kịp. Khi bên nhận xử lý không kịp, nó chỉ có thể tạm đặt data vào receive buffer (segment đến không đúng thứ tự cũng được lưu trong buffer). Trong điều kiện bình thường, bên nhận sẽ thu nhỏ rwnd, thậm chí thông báo zero window, để bên gửi dừng gửi data mới. Chỉ khi window control chưa kịp có hiệu lực, implementation của đối phương bất thường, buffer cạn hoặc network queue tràn thì mới có thể xảy ra việc loại bỏ data. Vì vậy, cần điều khiển sending rate của bên gửi để bên nhận và bên gửi duy trì một trạng thái cân bằng động.
Cần lưu ý điểm sau (hiểu lầm thường gặp):
- Bên gửi không đồng nghĩa với client
- Bên nhận không đồng nghĩa với server
TCP là giao tiếp Full-Duplex (FDX), hai bên có thể giao tiếp hai chiều; client và server đều có thể là bên gửi hoặc bên nhận. Vì vậy, mỗi đầu đều có một sending buffer và một receive buffer, đồng thời mỗi đầu tự duy trì một sending window và một receive window. Kích thước receive window phụ thuộc vào giới hạn của application, system và hardware (tốc độ truyền TCP không thể lớn hơn tốc độ xử lý data của application). Logic duy trì window của hai bên giao tiếp là tương tự nhau.
TCP sending window có thể chia thành bốn phần:
- TCP segment đã gửi và đã được xác nhận (đã gửi và đã ACK);
- TCP segment đã gửi nhưng chưa được xác nhận (đã gửi nhưng chưa ACK);
- TCP segment chưa gửi nhưng bên nhận sẵn sàng nhận (có thể gửi);
- TCP segment chưa gửi và bên nhận tạm thời cũng không thể nhận (không thể gửi).
Sơ đồ cấu trúc TCP sending window:
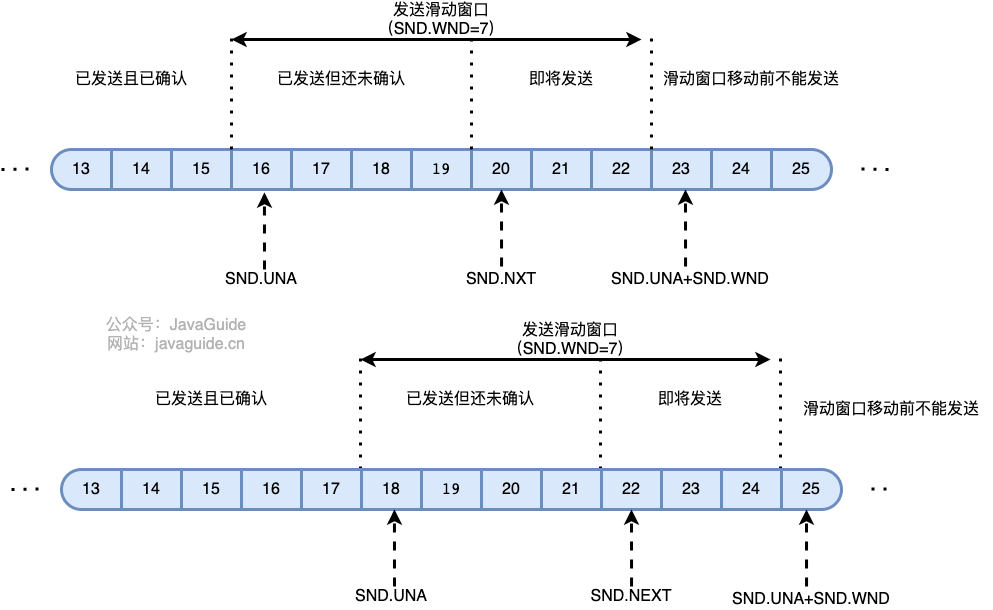
- SND.WND: sending window.
- SND.UNA: Send Unacknowledged, biểu thị sequence number sớm nhất chưa được xác nhận, cũng là ranh giới trái của sending window.
- SND.NXT: con trỏ Send Next, trỏ tới byte đầu tiên của window khả dụng.
Nếu chỉ xét ràng buộc của receive window, kích thước sending window khả dụng xấp xỉ SND.UNA + SND.WND - SND.NXT. Việc gửi thực tế còn chịu giới hạn của cwnd, MSS, sending buffer và các yếu tố khác.
TCP receive window có thể chia thành ba phần:
- TCP segment đã nhận và đã được xác nhận (đã nhận và đã ACK);
- TCP segment đang chờ nhận và bên gửi được phép gửi (có thể nhận nhưng chưa ACK);
- TCP segment không thể nhận và không cho phép bên gửi gửi (không thể nhận).
Sơ đồ cấu trúc TCP receive window:
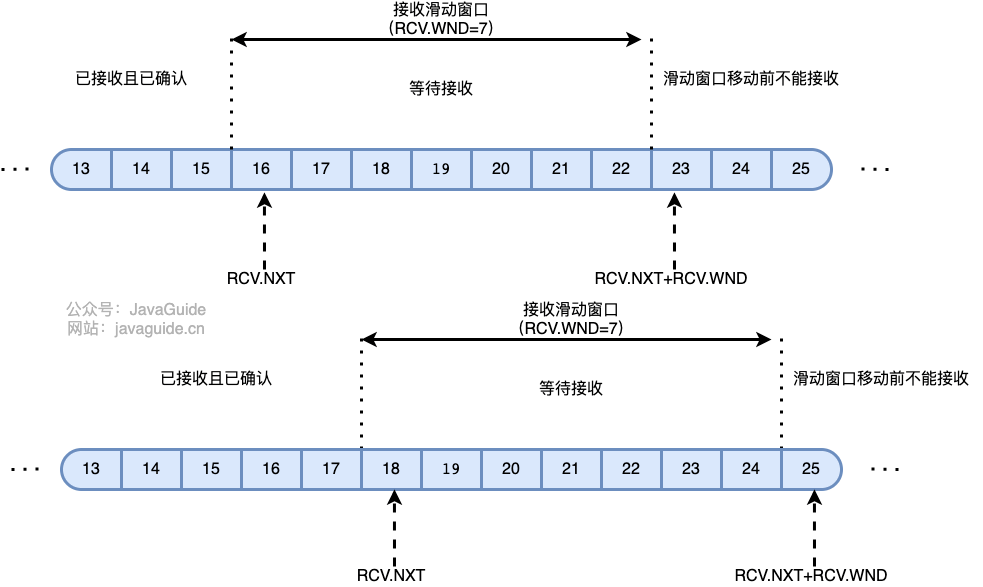
Kích thước receive window được điều chỉnh động. Nó thường chịu ảnh hưởng của tốc độ application đọc data, mức sử dụng receive buffer, cấu hình system socket buffer và cơ chế auto-tuning.
Ngoài ra, kích thước sliding window ở đây chỉ dùng để minh họa; kích thước window thực tế thường lớn hơn rất nhiều so với giá trị này.
Silly Window Syndrome (SWS) là việc bên gửi hoặc bên nhận liên tục gửi data và thông báo window với kích thước rất nhỏ, khiến network tràn ngập các packet nhỏ có “header rất lớn, payload rất nhỏ”, làm hiệu suất truyền tải rất kém.
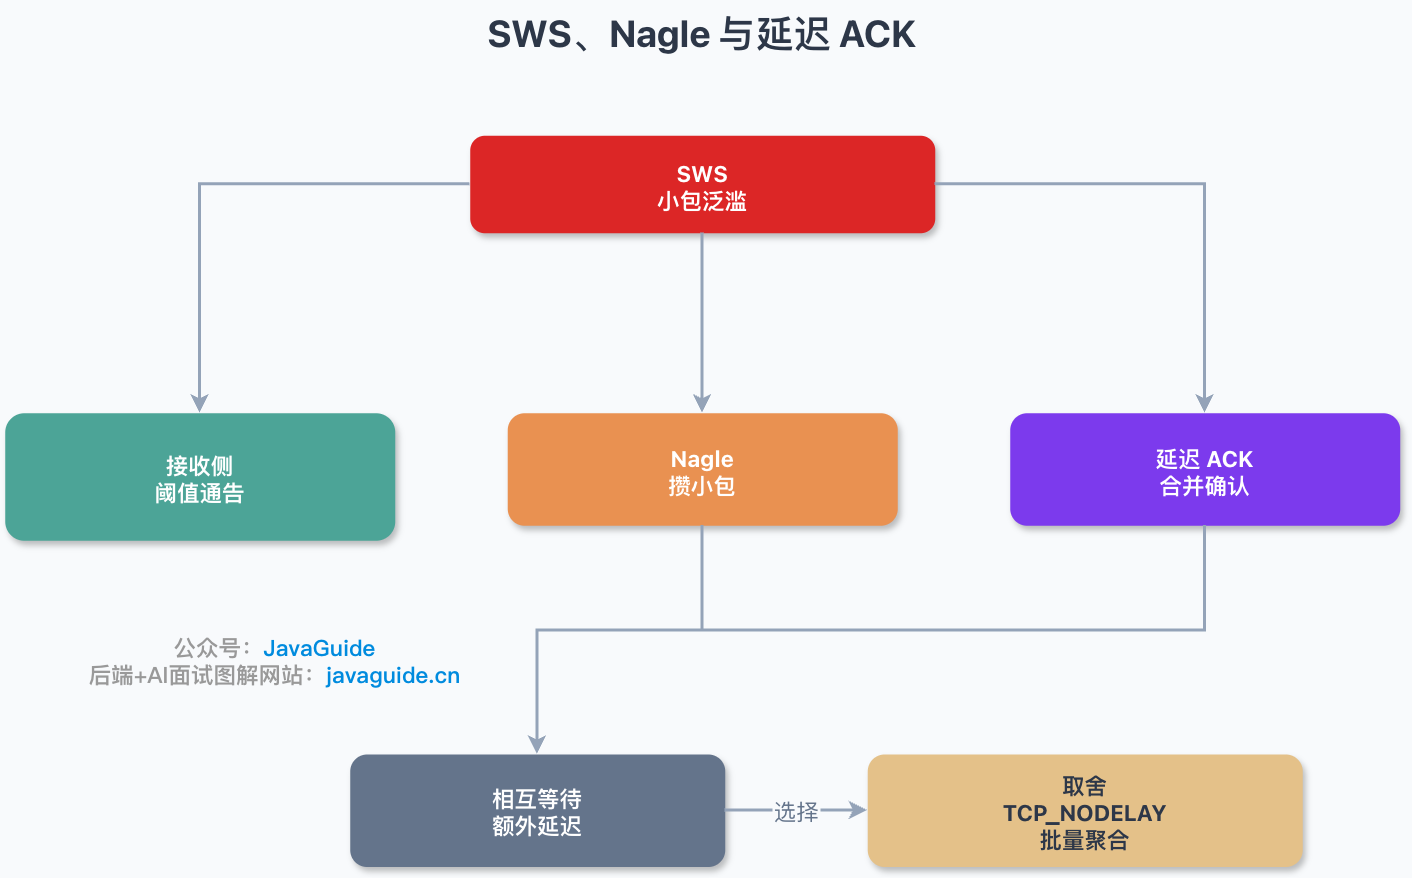
Một số nhóm tối ưu thường gặp:
- Tránh SWS ở phía bên nhận: không lập tức thông báo window mới mỗi khi chỉ giải phóng một phần nhỏ buffer, mà chờ đến khi không gian khả dụng đạt một threshold nhất định rồi mới cập nhật window.
- Nagle algorithm ở phía bên gửi: nếu còn packet nhỏ chưa được xác nhận trong network, trước tiên buffer data nhỏ mới, chờ nhận ACK hoặc tích đủ MSS rồi mới gửi.
- Delayed ACK: bên nhận không nhất thiết phải ACK ngay sau mỗi lần nhận segment, mà có thể chờ một khoảng thời gian ngắn để xem có thể gửi cùng data chiều ngược lại hay gộp acknowledgment cho nhiều segment hay không. Bản thân nó là cơ chế tạo ACK, không phải cơ chế được thiết kế riêng cho SWS, nhưng sẽ tương tác với cách gửi packet nhỏ.
Cần lưu ý rằng trong một số tình huống tương tác packet nhỏ, Nagle algorithm và delayed ACK có thể chờ lẫn nhau, gây thêm latency ở mức vài chục mili-giây. Với application tương tác nhạy cảm với latency, cách làm thường gặp là tắt Nagle thông qua TCP_NODELAY. Đổi lại, số lượng packet nhỏ có thể tăng, overhead của packet header và áp lực interrupt trong system cũng tăng. Batch response hoặc file transmission phù hợp hơn với việc gộp write; trên Linux còn có thể kết hợp các option phụ thuộc platform như TCP_CORK để điều khiển thời điểm “gom packet”.
Congestion control của TCP được thực hiện như thế nào?
Trong một khoảng thời gian, nếu nhu cầu đối với một resource nào đó trong network vượt quá phần khả dụng mà resource đó có thể cung cấp, performance của network sẽ giảm, biểu hiện ở queue dài hơn, latency cao hơn và packet loss tăng. Tình trạng này được gọi là congestion. Congestion control nhằm ngăn việc đưa quá nhiều data vào network, nhờ đó router hoặc link trong network không bị quá tải. Congestion control được xây dựng trên tiền đề rằng network có thể chịu được network load hiện tại. Congestion control là một quá trình mang tính toàn cục, liên quan đến mọi host, router và mọi yếu tố làm giảm performance truyền tải network. Ngược lại, flow control thường là việc điều khiển lưu lượng point-to-point, là vấn đề end-to-end. Flow control cần kìm hãm sending rate của bên gửi để bên nhận kịp nhận.
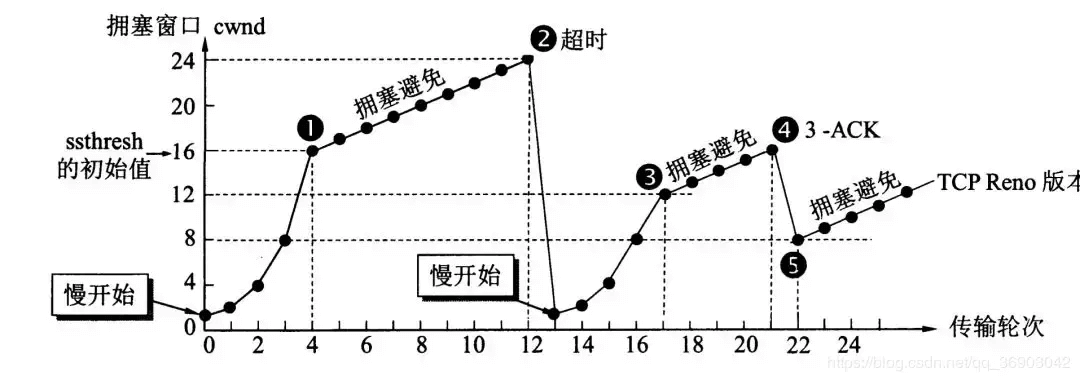
Để thực hiện congestion control, bên gửi TCP phải duy trì một state variable là congestion window (cwnd). Kích thước congestion window phụ thuộc vào mức độ congestion của network và thay đổi động. Bên gửi đặt sending window bằng giá trị nhỏ hơn giữa congestion window và receive window của bên nhận.
Theo framework cơ bản của RFC 5681 / Reno, TCP congestion control thường được chia thành bốn cơ chế để giải thích: slow start, congestion avoidance, fast retransmission (Fast Retransmit) và fast recovery. CUBIC, BBR, DCTCP trong các system hiện đại có implementation và state machine khác nhau trên nền tảng này. Ở network layer cũng có thể cho router sử dụng chiến lược loại bỏ packet phù hợp (chẳng hạn Active Queue Management, AQM) nhằm giảm congestion trong network.
- Slow start: tư tưởng của slow start là khi host bắt đầu gửi data, nếu lập tức đưa một lượng lớn byte data vào network thì có thể gây congestion, vì lúc này chưa biết tình trạng load của network. Cách tốt hơn là thăm dò trước, tức tăng dần sending window từ nhỏ đến lớn, cũng là tăng dần congestion window từ nhỏ đến lớn. Slow start không có nghĩa ban đầu chỉ được gửi 1 MSS. RFC 6928 đề xuất và cho phép thử nghiệm tăng initial window từ 2–4 segment lên tối đa 10 segment (IW10); nhiều implementation hiện đại dùng giá trị mặc định tương tự IW10, nhưng vẫn phải căn cứ vào cấu hình system cụ thể. Với MSS phổ biến là 1460 byte, 10 MSS có thể gửi khoảng 14 KB data trong RTT đầu tiên, điều này quan trọng với HTTP short connection và việc tải phần hiển thị đầu tiên của page. Điểm then chốt của slow start là: tăng nhanh window dựa trên ACK feedback, thường biểu hiện bằng việc
cwndxấp xỉ tăng gấp đôi sau mỗi RTT. - Congestion avoidance: tư tưởng của congestion avoidance là làm congestion window
cwndtăng chậm. Hiểu đơn giản là mỗi RTT tăng khoảng 1 MSS; trong implementation thường tăngcwndmột lượng nhỏ qua mỗi ACK để xấp xỉ tăng tuyến tính. Slow start chuyển sang congestion avoidance sau khicwndđạt slow start threshold (ssthresh). Giá trị ban đầu củassthreshthường được đặt khá lớn; lần điều chỉnh hiệu lực đầu tiên thường xảy ra sau khi phát hiện packet loss. - Fast retransmission: khi bên gửi nhận 3 duplicate ACK, tức 3 ACK liên tiếp đều xác nhận cùng một cumulative acknowledgment number cũ, nó thường cho rằng một segment phía sau đã mất, nên retransmission segment bị thiếu mà không chờ RTO timeout.
- Fast recovery: dưới đây là quy trình fast recovery kinh điển trong ngữ cảnh Reno. Khi nhận duplicate ACK thứ 3, đặt
ssthreshbằng một nửa congestion window hiện tại; retransmission segment bị mất và đặtcwndbằngssthresh + 3 × MSS; sau đó mỗi khi nhận thêm một duplicate ACK,cwndtăng thêm 1 MSS; khi nhận ACK mới, điều đó cho thấy data được retransmission đã được xác nhận, đưacwndgiảm vềssthreshvà chuyển sang congestion avoidance. Fast recovery không trực tiếp quay lại slow start vì duplicate ACK cho thấy data phía sau vẫn có thể đến bên nhận, network vẫn chưa mất khả năng hoạt động hoàn toàn. Nếu TCP hiện đại bật SACK, NewReno, CUBIC hoặc RACK/TLP, quá trình khôi phục packet loss sẽ phức tạp hơn, nhưng hiểu Reno vẫn là nền tảng nhập môn.
Fast retransmission rất hiệu quả khi mất một segment, nhưng nếu trong một window đồng thời mất nhiều segment thì chỉ dựa vào duplicate ACK rất khó thông báo một lần cho bên gửi toàn bộ “lỗ hổng” nằm ở đâu. Đây cũng là một nguyên nhân quan trọng khiến SACK xuất hiện: bên nhận có thể nói rõ cho bên gửi segment nào đã nhận, bên gửi chỉ retransmission phần bị thiếu.
Cần lưu ý rằng slow start, congestion avoidance, fast retransmission và fast recovery ở trên là framework nền tảng kinh điển để hiểu TCP congestion control. Các operating system hiện đại thường còn sử dụng những congestion control algorithm phức tạp hơn trên cơ sở này:
- CUBIC: đã được RFC 9438 cập nhật thành congestion control algorithm tiêu chuẩn; algorithm này thay thế đặc tả CUBIC cũ. CUBIC dùng hàm bậc ba để điều chỉnh congestion window, phù hợp hơn Reno trên các link có bandwidth cao và RTT dài; hiện đã được Linux, Windows, Apple và các protocol stack phổ biến khác áp dụng làm một trong các congestion control algorithm mặc định.
- BBR: congestion control algorithm dựa trên model (model-based) do Google đề xuất, điều khiển sending rate bằng cách ước tính bottleneck bandwidth và minimum RTT, nhằm đạt throughput cao và queueing latency thấp. Nó có thể hoạt động tốt hơn trên link có bufferbloat rõ rệt. Tuy nhiên, hiệu quả cụ thể của BBR chịu ảnh hưởng của version, queue management, loại traffic cạnh tranh, RTT fairness và môi trường deploy; không thể đơn giản hiểu là “thay thế CUBIC một cách mù quáng”.
- DCTCP: chủ yếu dùng trong controlled data center network, dựa vào ECN mark để ước tính mức độ congestion, nhằm giảm queueing latency trong tình huống switch có buffer nhỏ. Không phù hợp để trực tiếp dùng phổ biến trong môi trường public network.
Tuy nhiên, slow start, congestion avoidance, fast retransmission và fast recovery vẫn là nền tảng để hiểu các algorithm hiện đại này.
Còn một ranh giới rất quan trọng trong engineering: packet loss không nhất thiết đồng nghĩa với congestion. Reno/CUBIC truyền thống chủ yếu xem packet loss là tín hiệu congestion, nhưng bit error trên wireless link, chuyển path và network device queue overflow cũng có thể gây packet loss; ECN có thể phản hồi congestion mà không cần packet loss. Khi so sánh congestion algorithm, cũng không nên chỉ xem throughput trung bình, mà còn phải xem P95/P99 RTT, packet loss rate, retransmission rate, queue length, khả năng coexist với CUBIC/Reno, cùng version kernel và parameter configuration cụ thể.
Tổng kết
Độ tin cậy của TCP không phải là “bảo đảm network không mất packet”, mà là trên nền network IP không tin cậy, thông qua một nhóm cơ chế để application layer nhìn thấy một byte stream có thứ tự, không trùng lặp và đầy đủ nhất có thể. Có thể tóm tắt các điểm cốt lõi thành bốn ý:
- Dùng sequence number và ACK để xác nhận trạng thái data: TCP đánh số byte stream, bên nhận thông báo cho bên gửi qua ACK data nào đã nhận; bên gửi dựa vào đó phán đoán data nào còn đang trên đường và data nào cần tiếp tục chờ.
- Dùng cơ chế retransmission để bù data bị mất: retransmission do timeout chịu trách nhiệm dự phòng, fast retransmission dùng để phát hiện nhanh hơn việc mất một segment, còn SACK/D-SACK giúp bên gửi biết chính xác hơn data nào đã đến và lần retransmission nào có thể là phán đoán nhầm.
- Dùng sliding window để thực hiện flow control: bên nhận thông báo cho bên gửi qua
rwndrằng mình còn có thể nhận bao nhiêu data, bên gửi kiểm soát lượng data đang truyền dựa trên receive window để tránh làm đầy receive buffer. - Dùng congestion control để bảo vệ network: bên gửi ước tính khả năng chịu tải của network qua
cwnd; với sự phối hợp của slow start, congestion avoidance, fast retransmission, fast recovery và các algorithm như CUBIC, BBR, cố gắng tránh đưa quá nhiều data vào network.
Tóm lại trong một câu: TCP không làm network trở nên tin cậy, mà thông qua đánh số, xác nhận, retransmission, sắp xếp và loại bỏ trùng lặp, flow control và congestion control, “ghép” thành một channel byte stream tương đối tin cậy đối với application layer trên network không tin cậy.
Tài liệu tham khảo
- 《Computer Network (lần xuất bản thứ 7)》
- 《HTTP bằng hình ảnh》
- TCP and UDP Tutorial: https://www.9tut.com/tcp-and-udp-tutorial
- Computer Network: https://github.com/wolverinn/Waking-Up/blob/master/Computer Network.md
- TCP Flow Control: https://www.brianstorti.com/tcp-flow-control/
- TCP flow control (Flow Control): https://notfalse.net/24/tcp-flow-control
- Nguyên lý TCP sliding window: https://cloud.tencent.com/developer/article/1857363
- RFC 9293 - Transmission Control Protocol: https://www.rfc-editor.org/rfc/rfc9293
- RFC 6928 - Increasing TCP's Initial Window: https://www.rfc-editor.org/rfc/rfc6928
- RFC 5681 - TCP Congestion Control: https://datatracker.ietf.org/doc/html/rfc5681
- RFC 2018 - TCP Selective Acknowledgment Options: https://www.rfc-editor.org/rfc/rfc2018
- RFC 2883 - An Extension to the Selective Acknowledgement (SACK) Option for TCP: https://www.rfc-editor.org/rfc/rfc2883
- RFC 9438 - CUBIC for Fast and Long-Distance Networks: https://www.rfc-editor.org/rfc/rfc9438
- RFC 8257 - Data Center TCP (DCTCP): https://www.rfc-editor.org/rfc/rfc8257
- BBR: Congestion-Based Congestion Control, ACM Queue, 2016: https://queue.acm.org/detail.cfm?id=3022184
- RFC 1122 - Requirements for Internet Hosts - Communication Layers: https://datatracker.ietf.org/doc/html/rfc1122
- RFC 6298 - Computing TCP's Retransmission Timer: https://www.rfc-editor.org/rfc/rfc6298
- RFC 7323 - TCP Extensions for High Performance: https://datatracker.ietf.org/doc/rfc7323/