
Tổng hợp câu hỏi phỏng vấn về Trie: nguyên lý cây tiền tố, prefix matching và triển khai Java
Trie, còn gọi là cây tiền tố hoặc cây từ điển, phù hợp để xử lý các bài toán prefix matching trên lượng lớn chuỗi. Search suggestions, tra cứu từ điển, lọc từ nhạy cảm và prefix matching trong routing đều có thể thấy ứng dụng của nó.
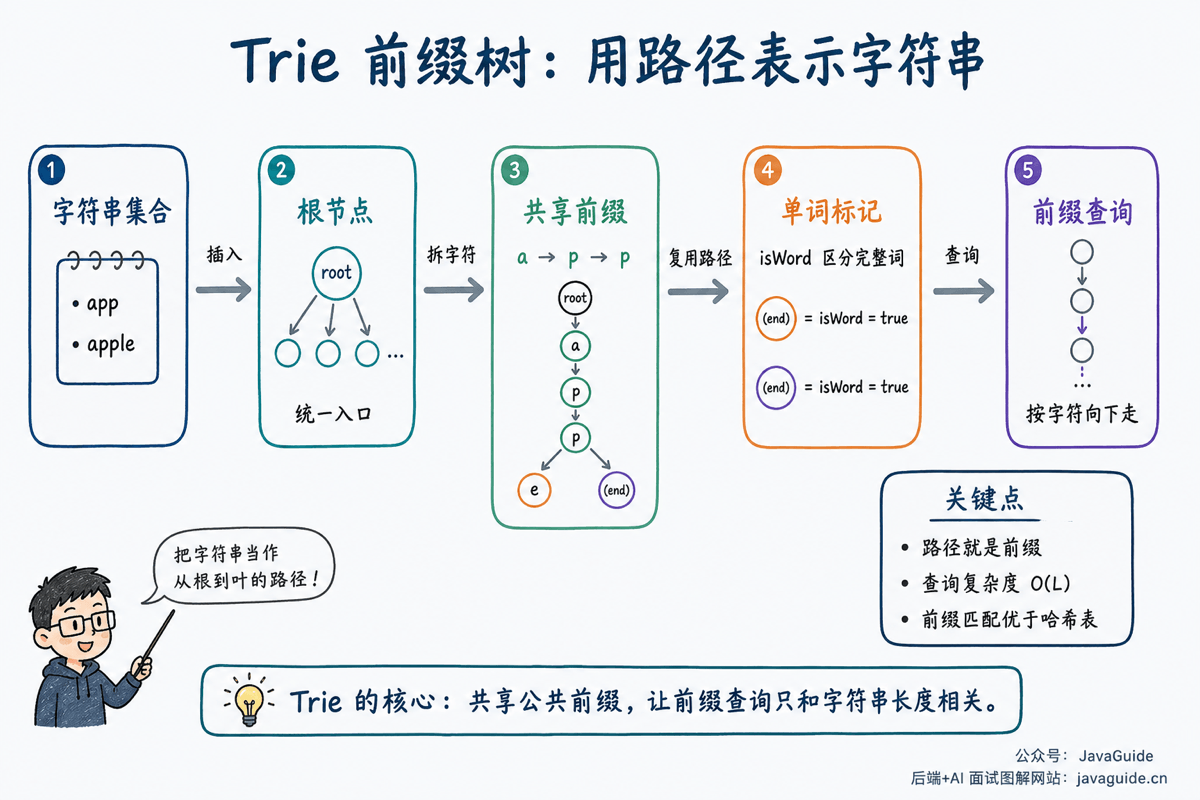
Ý tưởng cốt lõi của nó rất trực tiếp: tách chuỗi theo từng ký tự và chia sẻ các prefix giống nhau. Ví dụ, app, apple, apply sẽ dùng chung đường đi a -> p -> p.
Tổng quan nội dung bài viết:
- Trie là gì?
- Vì sao Trie phù hợp với prefix matching?
- Thiết kế node của Trie như thế nào?
- Viết thao tác chèn, truy vấn và truy vấn prefix của Trie như thế nào?
- Nên chọn Trie hay hash table?
Trie là gì?
Trie là một data structure được thiết kế chuyên biệt cho tập hợp chuỗi. Khác với binary search tree, node của Trie thường không được tổ chức dựa trên "quan hệ thứ tự", mà dựa trên "đường đi ký tự".
Có thể hiểu như sau:
- Root node không đại diện cho ký tự nào, chỉ là điểm bắt đầu của mọi chuỗi.
- Xuất phát từ root node, mỗi lần đi xuống một tầng sẽ khớp một ký tự trong chuỗi.
- Các ký tự trên đường đi từ root node đến một node khi ghép lại sẽ tạo thành một prefix.
- Nếu một node được đánh dấu là điểm kết thúc của một từ, điều đó có nghĩa chuỗi hình thành từ root đến node này là một từ hoàn chỉnh.
Ví dụ, sau khi chèn app, apple, apply, chúng sẽ dùng chung đoạn đường đi a -> p -> p. Node p cuối của app cần được đánh dấu là điểm kết thúc của một từ; nếu không, Trie chỉ biết app là prefix của một số từ, chứ không biết bản thân nó cũng là một từ hoàn chỉnh.
Đó là ý nghĩa của biến isWord. Nếu không có nó, không thể phân biệt "đường đi này chỉ là prefix" hay "đường đi này đã tạo thành một từ".
Vì sao Trie phù hợp với prefix matching?
Hash table rất phù hợp để kiểm tra một chuỗi hoàn chỉnh có tồn tại hay không, chẳng hạn truy vấn apple có trong tập hợp hay không. Nhưng nếu bài toán trở thành "tìm tất cả các từ bắt đầu bằng app", hash table sẽ không còn thuận tiện: nếu không duy trì thêm prefix index, ta phải quét một lượng lớn key.
Ưu thế của Trie nằm ở chỗ prefix tự nhiên tương ứng với một đường đi trên cây. Khi truy vấn prefix app, chỉ cần lần lượt đi qua a, p, p từ root node:
- Nếu đường đi của một ký tự nào đó không tồn tại giữa chừng, nghĩa là không có từ nào bắt đầu bằng
app. - Nếu đi được đến
pcuối cùng, nghĩa là mọi từ bên dưới node này đều bắt đầu bằngapp.
Vì vậy, độ phức tạp của truy vấn prefix trong Trie chủ yếu liên quan đến độ dài prefix, chứ không trực tiếp liên quan đến số lượng từ trong từ điển. Đặc điểm này rất hữu ích trong các trường hợp như search suggestions, longest prefix matching trong routing và lọc từ điển.
Trọng tâm phỏng vấn
- Có thể giải thích rõ vì sao Trie phù hợp với prefix query.
- Có thể viết thao tác chèn, truy vấn từ hoàn chỉnh và prefix query.
- Có thể phân tích time complexity theo độ dài chuỗi.
- Có thể chỉ ra space overhead của Trie có thể khá lớn.
- Có thể so sánh với hash table.
Cấu trúc node
Node của Trie thường chứa hai loại thông tin:
- Reference tới các child node, dùng để tiếp tục khớp ký tự tiếp theo.
- Flag cho biết node có đánh dấu kết thúc một từ hoàn chỉnh hay không.
Nếu chỉ xử lý các chữ cái tiếng Anh viết thường, có thể dùng một array có độ dài 26:
class TrieNode {
    TrieNode[] children = new TrieNode[26];
    boolean isWord;
}
Nếu character set không cố định, có thể dùng Map<Character, TrieNode>, không gian linh hoạt hơn, nhưng mỗi lần truy cập sẽ có chi phí của hash table.
Hai cách viết này không có cách nào tốt hơn tuyệt đối:
| Cách triển khai node | Ưu điểm | Nhược điểm |
|---|---|---|
TrieNode[] children = new TrieNode[26] | Truy cập nhanh, phù hợp character set cố định và nhỏ | Tốn không gian khi có nhiều node rỗng |
Map<Character, TrieNode> | Chỉ lưu các ký tự thực tế xuất hiện, linh hoạt hơn | Có thêm chi phí object và truy cập hash |
Khi viết code bằng tay trong phỏng vấn, nếu đề bài nêu rõ chỉ có các chữ cái tiếng Anh viết thường, dùng array sẽ rõ ràng nhất; nếu character set bao gồm chữ hoa, chữ thường, tiếng Trung, path segment hoặc ký tự bất kỳ, dùng Map sẽ phù hợp hơn.
Triển khai cơ bản
Mẫu dưới đây giả định chuỗi chỉ chứa các chữ cái tiếng Anh viết thường:
class Trie {
    private final TrieNode root = new TrieNode();

    public void insert(String word) {
        TrieNode node = root;
        for (char c : word.toCharArray()) {
            int index = c - 'a';
            if (node.children[index] == null) {
                node.children[index] = new TrieNode();
            }
            node = node.children[index];
        }
        node.isWord = true;
    }

    public boolean search(String word) {
        TrieNode node = find(word);
        return node != null && node.isWord;
    }

    public boolean startsWith(String prefix) {
        return find(prefix) != null;
    }

    private TrieNode find(String text) {
        TrieNode node = root;
        for (char c : text.toCharArray()) {
            int index = c - 'a';
            if (node.children[index] == null) {
                return null;
            }
            node = node.children[index];
        }
        return node;
    }
}
Logic của thao tác chèn và truy vấn thực ra theo cùng một quy trình: bắt đầu từ root node, lần lượt đi xuống từng tầng theo từng ký tự. Khi chèn, nếu đường đi chưa tồn tại thì tạo node; khi truy vấn, nếu đường đi không tồn tại thì trả về false. Điểm khác biệt chỉ nằm ở bước cuối: search() phải kiểm tra isWord, còn startsWith() chỉ cần đi hết prefix.
Hiểu thao tác xóa như thế nào?
Xóa trong Trie dễ viết sai hơn chèn và truy vấn, vì khi xóa một từ không thể đơn giản xóa toàn bộ đường đi.
Ví dụ, Trie đồng thời chứa app và apple. Khi xóa app, chỉ được bỏ flag isWord trên node p cuối của app, không được xóa đường đi a -> p -> p, nếu không apple cũng sẽ bị phá hỏng.
Khi thực sự xóa node, cần xem ngược từ cuối từ về đầu: nếu một node không có child node và cũng không phải là điểm kết thúc của từ khác thì mới có thể xóa. Trong phỏng vấn, nếu đề bài không yêu cầu xóa, trước hết nên viết chắc thao tác chèn, truy vấn hoàn chỉnh và prefix query.
Độ phức tạp
Giả sử độ dài chuỗi là L:
- Chèn:
O(L) - Truy vấn từ hoàn chỉnh:
O(L) - Prefix query:
O(L)
Space complexity phụ thuộc vào số lượng node. Trong trường hợp xấu nhất, nếu các chuỗi hầu như không có prefix chung, space overhead sẽ xấp xỉ tổng số ký tự của tất cả chuỗi.
Nếu còn phải liệt kê tất cả các từ dưới một prefix, độ phức tạp sẽ không chỉ là O(L). Việc xác định prefix node cần O(L), sau đó còn phải duyệt subtree bên dưới node này; chi phí bổ sung liên quan đến số lượng kết quả trả về và quy mô subtree.
Nên chọn Trie hay hash table?
| Trường hợp | Trie | Hash table |
|---|---|---|
| Truy vấn chuỗi hoàn chỉnh | Có thể dùng, nhưng tốn không gian hơn | Trực tiếp hơn |
| Prefix query | Rất phù hợp | Cần xử lý thêm |
| Liệt kê mọi từ theo prefix | Rất phù hợp | Không thuận tiện |
| Character set rất lớn | Cần tối ưu cấu trúc node | Đơn giản hơn |
Nếu chỉ cần kiểm tra một từ có tồn tại hay không, hash table thường đơn giản hơn. Nếu cần truy vấn prefix thường xuyên, Trie phù hợp hơn.
Còn một khác biệt dễ bị bỏ qua: full match của hash table thường tiết kiệm không gian hơn và tổng quát hơn; Trie thì lưu prefix chung thành đường đi một cách tường minh, nhờ đó tự nhiên hỗ trợ truy vấn prefix, liệt kê theo prefix và longest prefix matching. Hai bên tập trung giải quyết những bài toán khác nhau, không bên nào hoàn toàn thay thế bên nào.
Ứng dụng thực tế
- Tự động hoàn thành trong search box: tìm các từ ứng viên dựa trên prefix người dùng nhập.
- Phát hiện từ nhạy cảm: Trie có thể kết hợp với AC automaton để thực hiện multi-pattern matching.
- Matching trong IP routing: longest prefix matching có thể tham khảo ý tưởng của Trie.
- Kiểm tra từ trong từ điển: nhanh chóng xác định từ hoặc prefix có tồn tại hay không.
Trong các hệ thống thực tế, còn có thể gặp một số biến thể của Trie:
- Compressed Trie / Radix Tree: nén path liên tiếp chỉ có một child node thành một đoạn chuỗi, giảm số lượng node.
- Ternary Search Trie: mỗi node tổ chức ký tự theo ba hướng nhỏ hơn, bằng và lớn hơn, cân bằng giữa không gian và tính linh hoạt khi truy vấn.
- AC automaton: bổ sung failure pointer dựa trên Trie để thực hiện multi-pattern string matching.
Không cần học thuộc toàn bộ các biến thể này ngay từ đầu, nhưng cần biết tư tưởng cơ bản của Trie là điểm khởi đầu chung của chúng: dùng path để biểu diễn chuỗi và chia sẻ path để tái sử dụng prefix.
Điểm dễ sai
- Không được bỏ qua
isWord, nếu không sẽ không thể phân biệtappvàapple. - Character set không nhất thiết chỉ có chữ cái viết thường; khi phỏng vấn cần điều chỉnh theo đề bài.
- Xóa từ phức tạp hơn chèn và truy vấn, cần xác định node còn có thể được từ khác dùng chung hay không.
- Độ phức tạp của Trie liên quan đến độ dài chuỗi, không tỷ lệ thuận trực tiếp với quy mô từ điển.
Bài tập đề xuất
Tài liệu tham khảo
- Algorithms, 4th Edition: Tries
- Algorithms, 4th Edition: TrieST API
- Stanford CS166: Tries and Suffix Trees
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.