
Giải thích chi tiết về đồ thị (DFS, BFS, đường đi ngắn nhất)
Đồ thị
Đồ thị là một cấu trúc phi tuyến tương đối phức tạp. Tại sao nói đồ thị tương đối phức tạp?
Dựa trên nội dung trước đó, chúng ta biết:
- Các phần tử của cấu trúc dữ liệu tuyến tính thỏa mãn quan hệ tuyến tính duy nhất, mỗi phần tử (trừ phần tử đầu tiên và cuối cùng) chỉ có một phần tử đứng trước trực tiếp và một phần tử đứng sau trực tiếp.
- Giữa các phần tử của cấu trúc dữ liệu dạng cây có quan hệ phân cấp rõ ràng.
Tuy nhiên, quan hệ giữa các phần tử của cấu trúc đồ thị là tùy ý.
Đồ thị là gì? Nói đơn giản, đồ thị là tập hợp gồm một tập đỉnh hữu hạn khác rỗng và các cạnh giữa các đỉnh. Thường được biểu diễn là: G(V,E), trong đó G biểu thị một đồ thị, V biểu thị tập hợp các đỉnh, E biểu thị tập hợp các cạnh.
Hình dưới đây biểu diễn cấu trúc dữ liệu đồ thị, đồng thời đây cũng là một đồ thị có hướng.
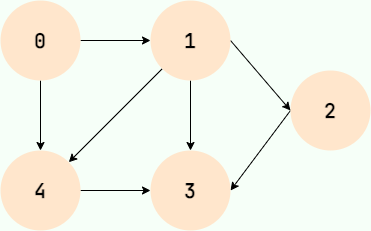
Có rất nhiều ví dụ về đồ thị trong cuộc sống hằng ngày! Chẳng hạn, quan hệ bạn bè trên mạng xã hội có thể được biểu diễn bằng đồ thị.
Khái niệm cơ bản về đồ thị
Đỉnh
Các phần tử dữ liệu trong đồ thị được gọi là đỉnh. Đồ thị có ít nhất một đỉnh, tạo thành một tập hữu hạn khác rỗng.
Trong đồ thị quan hệ bạn bè, mỗi người dùng đại diện cho một đỉnh.
Cạnh
Quan hệ giữa các đỉnh được biểu diễn bằng cạnh.
Trong đồ thị quan hệ bạn bè, nếu hai người dùng là bạn bè thì giữa họ tồn tại một cạnh.
Bậc
Bậc cho biết số cạnh liên kết với một đỉnh. Trong đồ thị có hướng, bậc còn được chia thành out-degree và in-degree: out-degree biểu thị số cạnh đi ra từ đỉnh đó, in-degree biểu thị số cạnh đi vào đỉnh đó.
Trong đồ thị quan hệ bạn bè, bậc biểu thị số lượng bạn bè của một người.
Đồ thị vô hướng và đồ thị có hướng
Cạnh biểu thị quan hệ giữa các đỉnh. Một số quan hệ là hai chiều, chẳng hạn quan hệ bạn học: nếu A là bạn học của B thì B chắc chắn cũng là bạn học của A. Khi biểu diễn quan hệ giữa A và B, ta không cần quan tâm đến hướng, mà dùng cạnh không có mũi tên. Đồ thị như vậy là đồ thị vô hướng.
Một số quan hệ có hướng, chẳng hạn quan hệ cha con, quan hệ thầy trò và quan hệ theo dõi trên Weibo: A là bố của B nhưng B chắc chắn không phải bố của A; A theo dõi B nhưng B chưa chắc theo dõi A. Trong trường hợp này, ta dùng cạnh có mũi tên để biểu diễn quan hệ giữa hai bên. Đồ thị như vậy là đồ thị có hướng.
Đồ thị không trọng số và đồ thị có trọng số
Với một quan hệ, nếu chỉ quan tâm quan hệ có tồn tại hay không mà không quan tâm mức độ mạnh yếu của quan hệ, ta có thể dùng đồ thị không trọng số để biểu diễn quan hệ giữa hai bên.
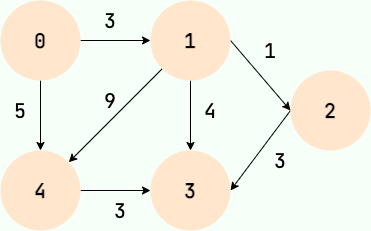
Với một quan hệ, nếu vừa quan tâm quan hệ có tồn tại hay không vừa quan tâm cường độ của quan hệ, chẳng hạn mô tả quan hệ giữa hai thành phố trên bản đồ và cần dùng khoảng cách, ta dùng đồ thị có trọng số để biểu diễn. Mỗi cạnh trong đồ thị có trọng số được biểu diễn bằng một giá trị số làm trọng số, thể hiện cường độ của quan hệ.
Hình dưới đây là một đồ thị có hướng có trọng số.
Lưu trữ đồ thị
Lưu trữ bằng ma trận kề
Ma trận kề lưu trữ đồ thị bằng ma trận hai chiều, là một cách biểu diễn tương đối trực quan.
Nếu giữa đỉnh thứ i và đỉnh thứ j có quan hệ, đồng thời trọng số của quan hệ là n, thì A[i][j]=n.
Trong đồ thị vô hướng, ta chỉ quan tâm quan hệ có tồn tại hay không. Vì vậy, khi đỉnh i và đỉnh j có quan hệ thì A[i][j]=1, còn khi đỉnh i và đỉnh j không có quan hệ thì A[i][j]=0. Như hình dưới đây:
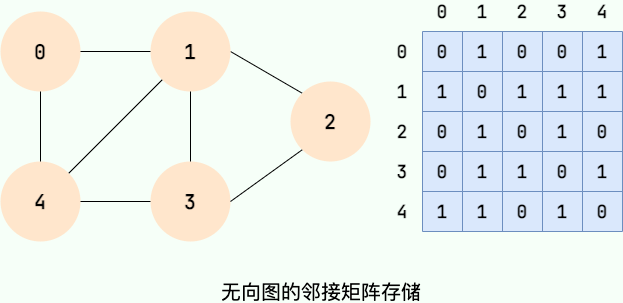
Đáng chú ý: ma trận kề của đồ thị vô hướng là một ma trận đối xứng, vì trong đồ thị vô hướng, nếu đỉnh i có quan hệ với đỉnh j thì đỉnh j chắc chắn có quan hệ với đỉnh i.

Ưu điểm của cách lưu trữ bằng ma trận kề là đơn giản, trực tiếp (chỉ cần dùng một mảng hai chiều), đồng thời rất hiệu quả khi lấy quan hệ giữa hai đỉnh (chỉ cần lấy giá trị của phần tử mảng ở vị trí được chỉ định). Tuy nhiên, nhược điểm của cách lưu trữ này cũng khá rõ ràng: khá lãng phí không gian.
Lưu trữ bằng danh sách kề
Do ma trận kề ở trên khá lãng phí không gian bộ nhớ, một phương pháp lưu trữ đồ thị khác ra đời: danh sách kề.
Danh sách liên kết kề dùng một linked list để lưu trữ tất cả các đỉnh kề của một đỉnh. Với mỗi đỉnh Vi trong đồ thị, tất cả các đỉnh Vj kề với Vi được nối thành một singly linked list. Singly linked list này được gọi là danh sách kề của đỉnh Vi. Như hình dưới đây:
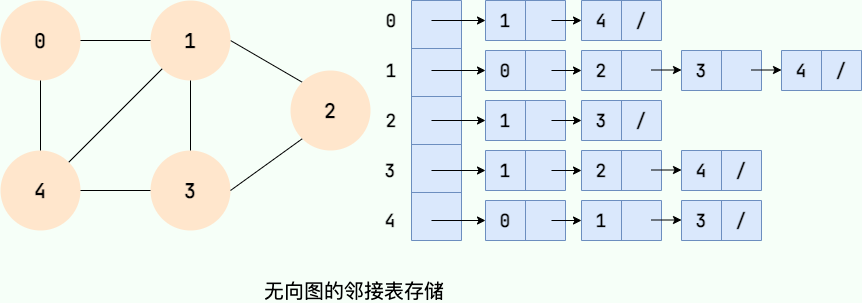

Bạn có thể đếm số phần tử được lưu trữ trong danh sách kề và số cạnh trong đồ thị, rồi sẽ thấy:
- Trong đồ thị vô hướng, số phần tử trong danh sách kề bằng hai lần số cạnh. Như đồ thị vô hướng ở hình bên trái, số cạnh là 7 còn số phần tử được lưu trữ trong danh sách kề là 14.
- Trong đồ thị có hướng, số phần tử trong danh sách kề bằng số cạnh. Như đồ thị có hướng ở hình bên phải, số cạnh là 8 và số phần tử được lưu trữ trong danh sách kề cũng là 8.
Tìm kiếm trên đồ thị
Breadth-first search
Breadth-first search mở rộng ra ngoài theo từng lớp, giống như những gợn sóng trên mặt nước, như hình dưới đây:
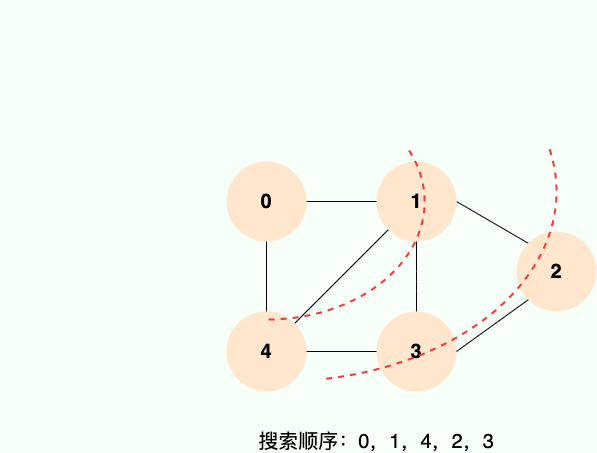
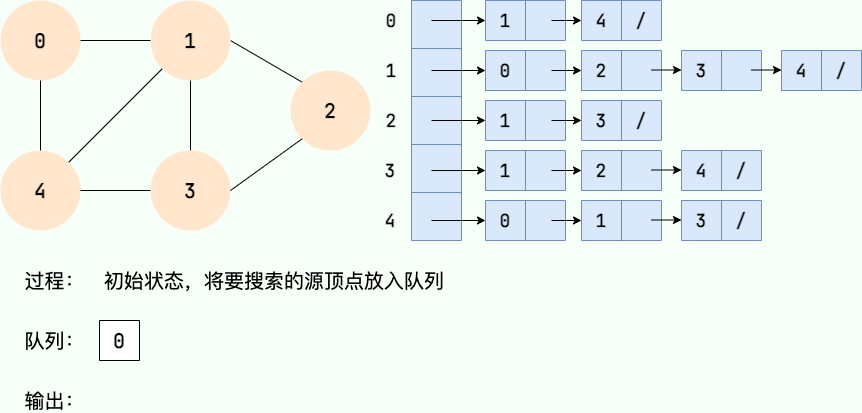
Cách triển khai cụ thể của Breadth-first search sử dụng cấu trúc dữ liệu tuyến tính đã học trước đó: Queue. Quy trình cụ thể như hình dưới đây:
Bước 1:
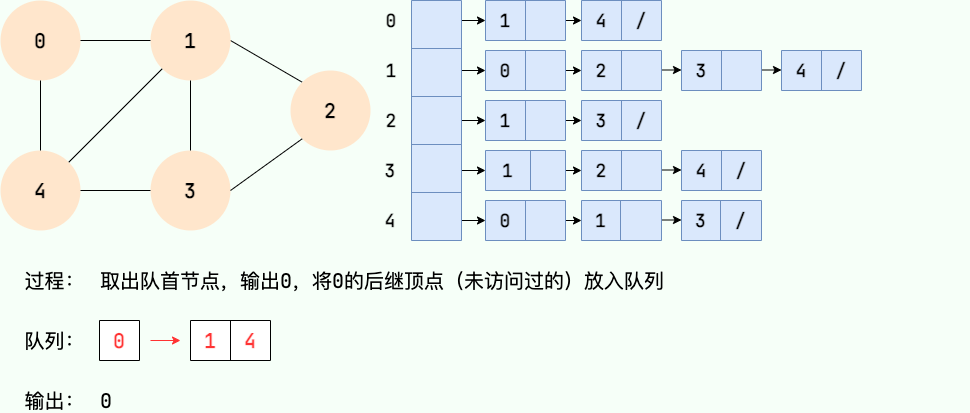
Bước 2:
Bước 3:
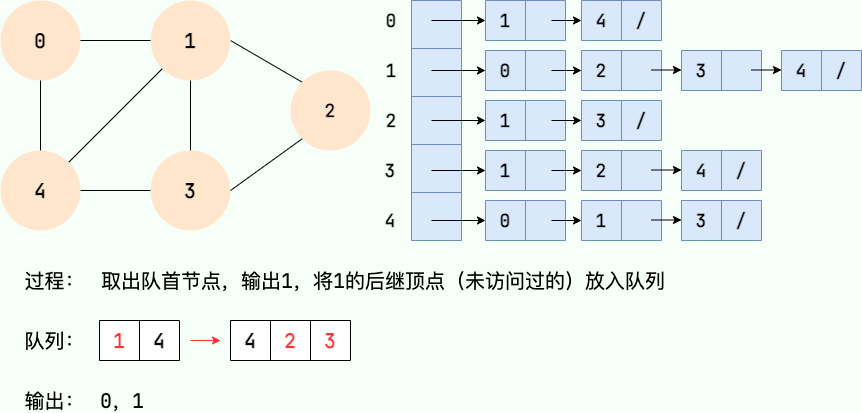
Bước 4:
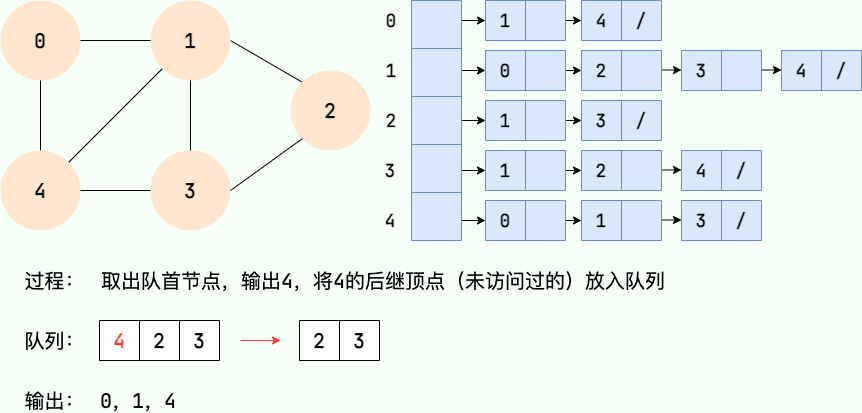
Bước 5:
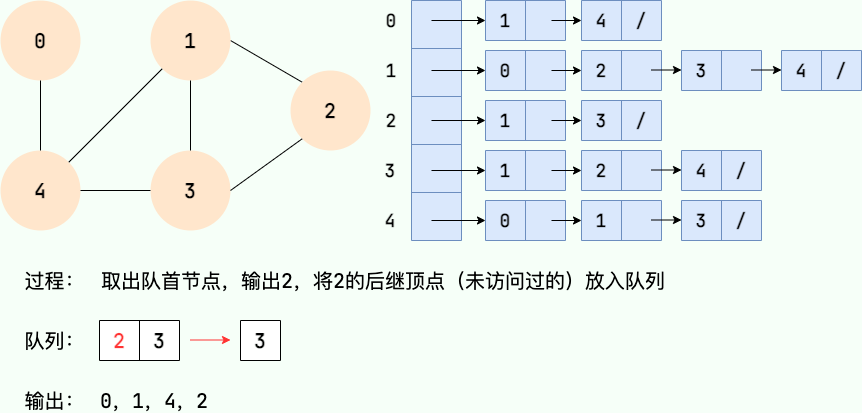
Bước 6:
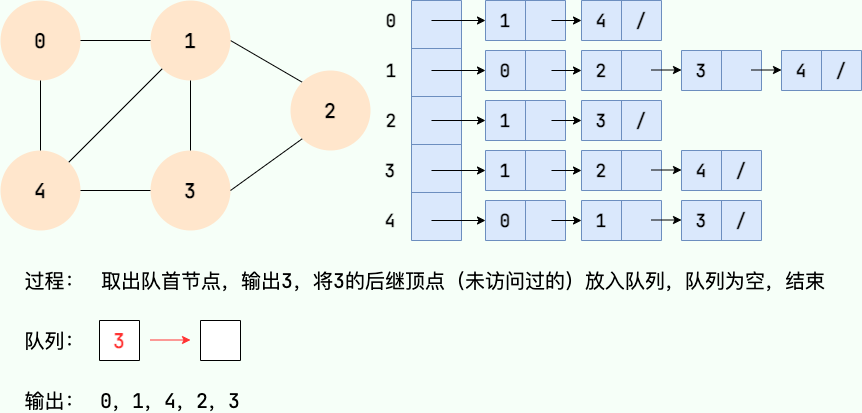
Depth-first search
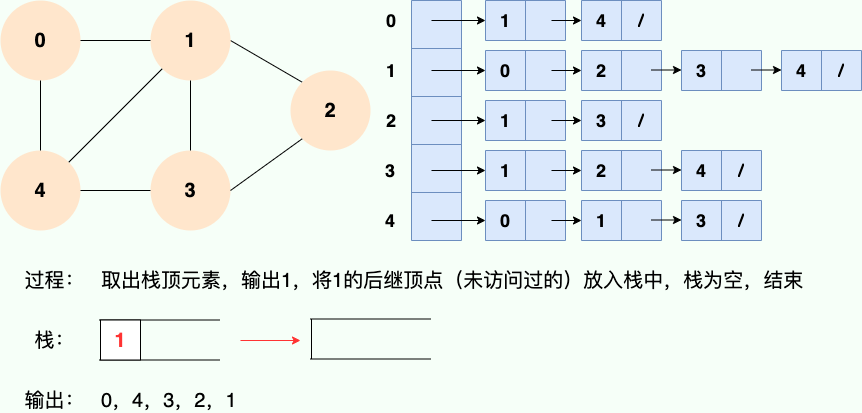
Depth-first search là “đi đến cùng”: bắt đầu từ đỉnh nguồn, đi liên tục cho đến khi không còn đỉnh kề thì quay lui về đỉnh trước đó, sau đó tiếp tục “đi đến cùng”, như hình dưới đây:
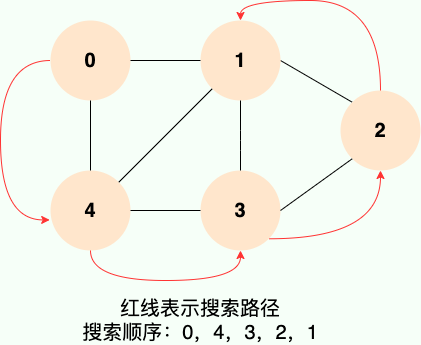
Tương tự Breadth-first search, cách triển khai cụ thể của Depth-first search sử dụng một cấu trúc dữ liệu tuyến tính khác: Stack. Quy trình cụ thể như hình dưới đây:
Bước 1:
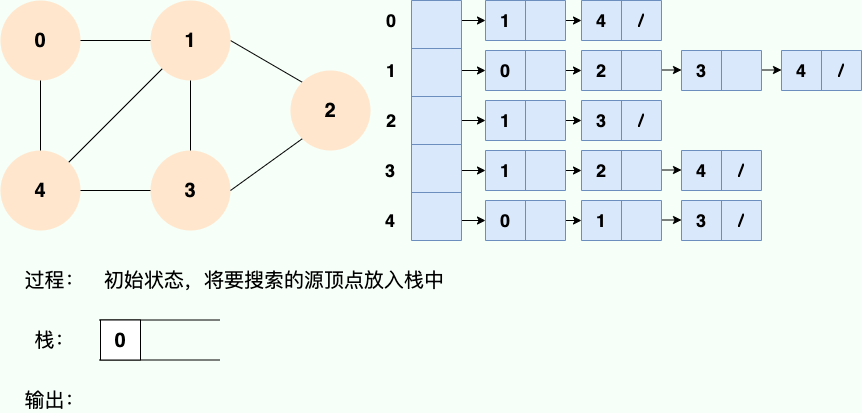
Bước 2:
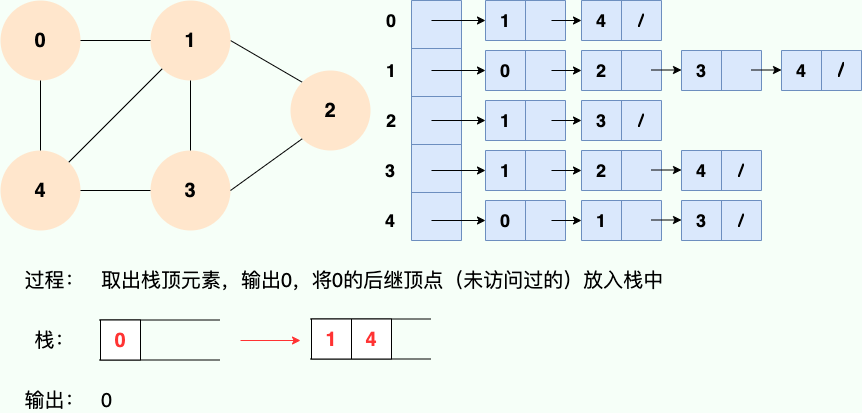
Bước 3:
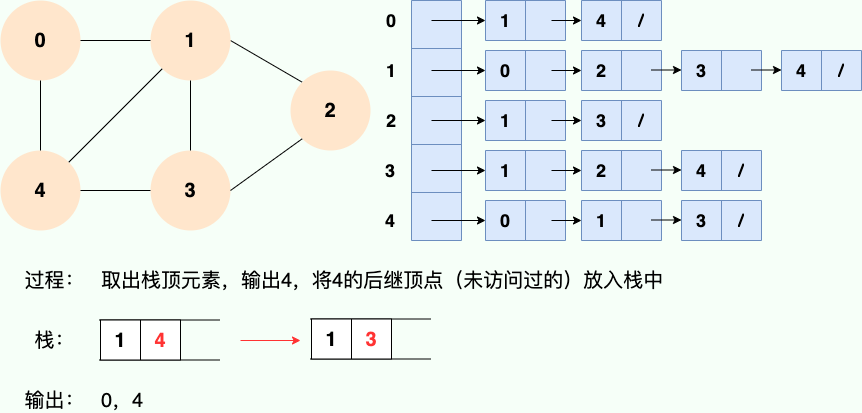
Bước 4:
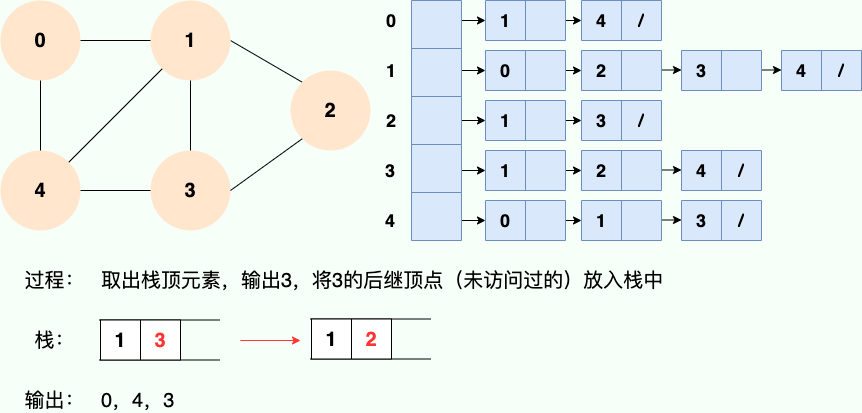
Bước 5:

Bước 6:
Trọng tâm ôn tập phỏng vấn
Với bài toán đồ thị, trước tiên chọn cách lưu trữ, sau đó chọn cách duyệt. Trong phỏng vấn, 4 loại bài toán đồ thị thường gặp nhất là: thành phần liên thông, số bước ngắn nhất, quan hệ phụ thuộc và phát hiện chu trình.
| Cách lưu trữ | Độ phức tạp không gian | Kiểm tra hai đỉnh có kề nhau không | Duyệt các đỉnh kề của một đỉnh | Trường hợp phù hợp |
|---|---|---|---|---|
| Ma trận kề | O(V^2) | O(1) | O(V) | Đồ thị dày, số node ít |
| Danh sách kề | O(V + E) | Tùy thuộc cấu trúc danh sách kề | Phụ thuộc vào bậc | Đồ thị thưa, thường dùng trong các bài toán |
Có thể tham khảo template DFS/BFS tại Tổng hợp câu hỏi phỏng vấn về DFS và BFS. Dưới đây là một số điểm cần bổ sung khi trả lời phỏng vấn:
- Với danh sách kề, độ phức tạp thời gian của DFS và BFS thường là
O(V + E). - Khi tìm số bước ngắn nhất trong đồ thị không trọng số, ưu tiên cân nhắc BFS.
- Với quan hệ phụ thuộc trong đồ thị có hướng, thường dùng sắp xếp topo; bài toán điển hình là Course Schedule.
- Tính liên thông và phát hiện chu trình trong đồ thị vô hướng có thể dùng DFS/BFS hoặc Union-Find.
- Đường đi ngắn nhất có trọng số không phải là BFS thông thường. Các thuật toán thường gặp gồm Dijkstra, Bellman-Ford và Floyd; khi phỏng vấn, lựa chọn theo phạm vi của đề bài.
Mẫu code Java
Trong các bài toán, danh sách kề được dùng phổ biến nhất. Chỉ số đỉnh thường từ 0 đến n - 1, có thể dùng List<Integer>[] để biểu diễn.
List<Integer>[] buildGraph(int n, int[][] edges) {
    List<Integer>[] graph = new ArrayList[n];
    for (int i = 0; i < n; i++) {
        graph[i] = new ArrayList<>();
    }
    for (int[] edge : edges) {
        int from = edge[0];
        int to = edge[1];
        graph[from].add(to);
        // Với đồ thị vô hướng, cần thêm một cạnh ngược:
        // graph[to].add(from);
    }
    return graph;
}
BFS phù hợp để tìm số bước ngắn nhất trong đồ thị không trọng số:
int bfs(List<Integer>[] graph, int start, int target) {
    boolean[] visited = new boolean[graph.length];
    Queue<Integer> queue = new ArrayDeque<>();
    queue.offer(start);
    visited[start] = true;
    int step = 0;
    while (!queue.isEmpty()) {
        int size = queue.size();
        for (int i = 0; i < size; i++) {
            int cur = queue.poll();
            if (cur == target) {
                return step;
            }
            for (int next : graph[cur]) {
                if (!visited[next]) {
                    visited[next] = true;
                    queue.offer(next);
                }
            }
        }
        step++;
    }
    return -1;
}
Minh họa quy trình và các trường hợp biên
Lấy đường đi ngắn nhất trong đồ thị không trọng số làm ví dụ, có thể hiểu quá trình lan tỏa theo từng lớp của BFS như sau:
Lớp 0: start
Lớp 1: tất cả các đỉnh kề chưa được truy cập của start
Lớp 2: tất cả các đỉnh kề chưa được truy cập của các đỉnh lớp 1
...
Lần đầu gặp target, chỉ số lớp hiện tại chính là số bước ngắn nhất
Một số trường hợp biên nên kiểm tra trước:
start == target, đáp án phải là0.- Đồ thị không liên thông, không thể đến được điểm đích, đáp án phải là
-1. - Khi xây dựng đồ thị vô hướng, nếu quên thêm cạnh ngược thì đồ thị liên thông sẽ bị xác định nhầm là không liên thông.
- Nếu không đánh dấu
visitedtrong đồ thị có chu trình, BFS/DFS sẽ truy cập lặp lại, thậm chí rơi vào vòng lặp vô hạn.
Bài tập đề xuất
- 200. Số lượng đảo
- 695. Diện tích lớn nhất của đảo
- 994. Cam thối rữa
- 207. Course Schedule
- 547. Số lượng tỉnh
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.