
Tổng hợp 10 thuật toán sắp xếp kinh điển
Giới thiệu
Sắp xếp là thao tác sắp xếp một chuỗi bản ghi theo thứ tự tăng dần hoặc giảm dần dựa trên giá trị của một hoặc một số key trong đó. Thuật toán sắp xếp là phương pháp sắp xếp các bản ghi theo yêu cầu. Thuật toán sắp xếp được coi trọng trong nhiều lĩnh vực, đặc biệt là xử lý lượng dữ liệu lớn. Một thuật toán tốt có thể tiết kiệm rất nhiều tài nguyên. Để có được một thuật toán tốt và phù hợp với thực tế, cần xem xét các ràng buộc và quy tắc khác nhau của dữ liệu trong từng lĩnh vực, đồng thời phải trải qua nhiều suy luận và phân tích.
Giới thiệu tổng quan
Tổng hợp thuật toán sắp xếp
Các thuật toán sắp xếp nội bộ thường gặp gồm: sắp xếp chèn, sắp xếp Shell, sắp xếp chọn, sắp xếp nổi bọt, sắp xếp trộn, sắp xếp nhanh, sắp xếp heap, sắp xếp radix,... Bài viết này chỉ giải thích các thuật toán sắp xếp nội bộ. Bảng dưới đây tóm tắt:
| Thuật toán sắp xếp | Độ phức tạp thời gian (trung bình) | Độ phức tạp thời gian (tệ nhất) | Độ phức tạp thời gian (tốt nhất) | Độ phức tạp không gian | In-place | Tính ổn định |
|---|---|---|---|---|---|---|
| Sắp xếp nổi bọt | O(n^2) | O(n^2) | O(n) | O(1) | Có | Ổn định |
| Sắp xếp chọn | O(n^2) | O(n^2) | O(n^2) | O(1) | Có | Không ổn định |
| Sắp xếp chèn | O(n^2) | O(n^2) | O(n) | O(1) | Có | Ổn định |
| Sắp xếp Shell | Phụ thuộc chuỗi increment | O(n^2) | O(nlogn) | O(1) | Có | Không ổn định |
| Sắp xếp trộn | O(nlogn) | O(nlogn) | O(nlogn) | O(n) | Không | Ổn định |
| Sắp xếp nhanh | O(nlogn) | O(n^2) | O(nlogn) | Trung bình O(logn), tệ nhất O(n) | Có | Không ổn định |
| Sắp xếp heap | O(nlogn) | O(nlogn) | O(nlogn) | O(1) | Có | Không ổn định |
| Sắp xếp đếm | O(n+k) | O(n+k) | O(n+k) | O(n+k) | Không | Ổn định |
| Sắp xếp bucket | Liên quan đến phân bố dữ liệu | Phụ thuộc sorting trong bucket | O(n+k) | O(n+k) | Không | Phụ thuộc sorting trong bucket |
| Sắp xếp radix | O(d(n+r)) | O(d(n+r)) | O(d(n+r)) | O(n+r) | Không | Ổn định |
Giải thích thuật ngữ:
- n: quy mô dữ liệu, biểu thị kích thước lượng dữ liệu cần sắp xếp.
- k: kích thước phạm vi đếm hoặc số lượng bucket, ý nghĩa cụ thể cần kết hợp với phần giải thích thuật toán.
- d: số chữ số lớn nhất mà sắp xếp radix xử lý.
- r: radix mà radix sort sử dụng, ví dụ radix thập phân có
r=10. - Sắp xếp nội bộ: dữ liệu cần sắp xếp có thể được nạp toàn bộ vào memory, thao tác sorting chủ yếu hoàn thành trong memory. Code trong bài viết đều là triển khai sắp xếp nội bộ.
- Sắp xếp bên ngoài: khi lượng dữ liệu lớn đến mức không thể nạp toàn bộ vào memory, dữ liệu được xử lý theo từng phần nhờ disk và các external storage khác. Cùng một algorithm có thể có triển khai trong memory, cũng có thể được cải tạo thành một phương án sắp xếp bên ngoài, vì vậy đây không phải nhãn phân loại vốn có của algorithm.
- Ổn định: nếu A vốn ở trước B và $A=B$, sau khi sorting A vẫn ở trước B.
- Không ổn định: nếu A vốn ở trước B và $A=B$, sau khi sorting A có thể xuất hiện sau B.
- Độ phức tạp thời gian: mô tả định tính thời gian một algorithm cần để thực thi.
- Độ phức tạp không gian: mô tả định tính lượng memory một algorithm cần khi thực thi.
Phân loại thuật toán sắp xếp
Mười thuật toán sắp xếp thường gặp có thể được chia thành hai nhóm lớn: sắp xếp dựa trên so sánh và sắp xếp không dựa trên so sánh.
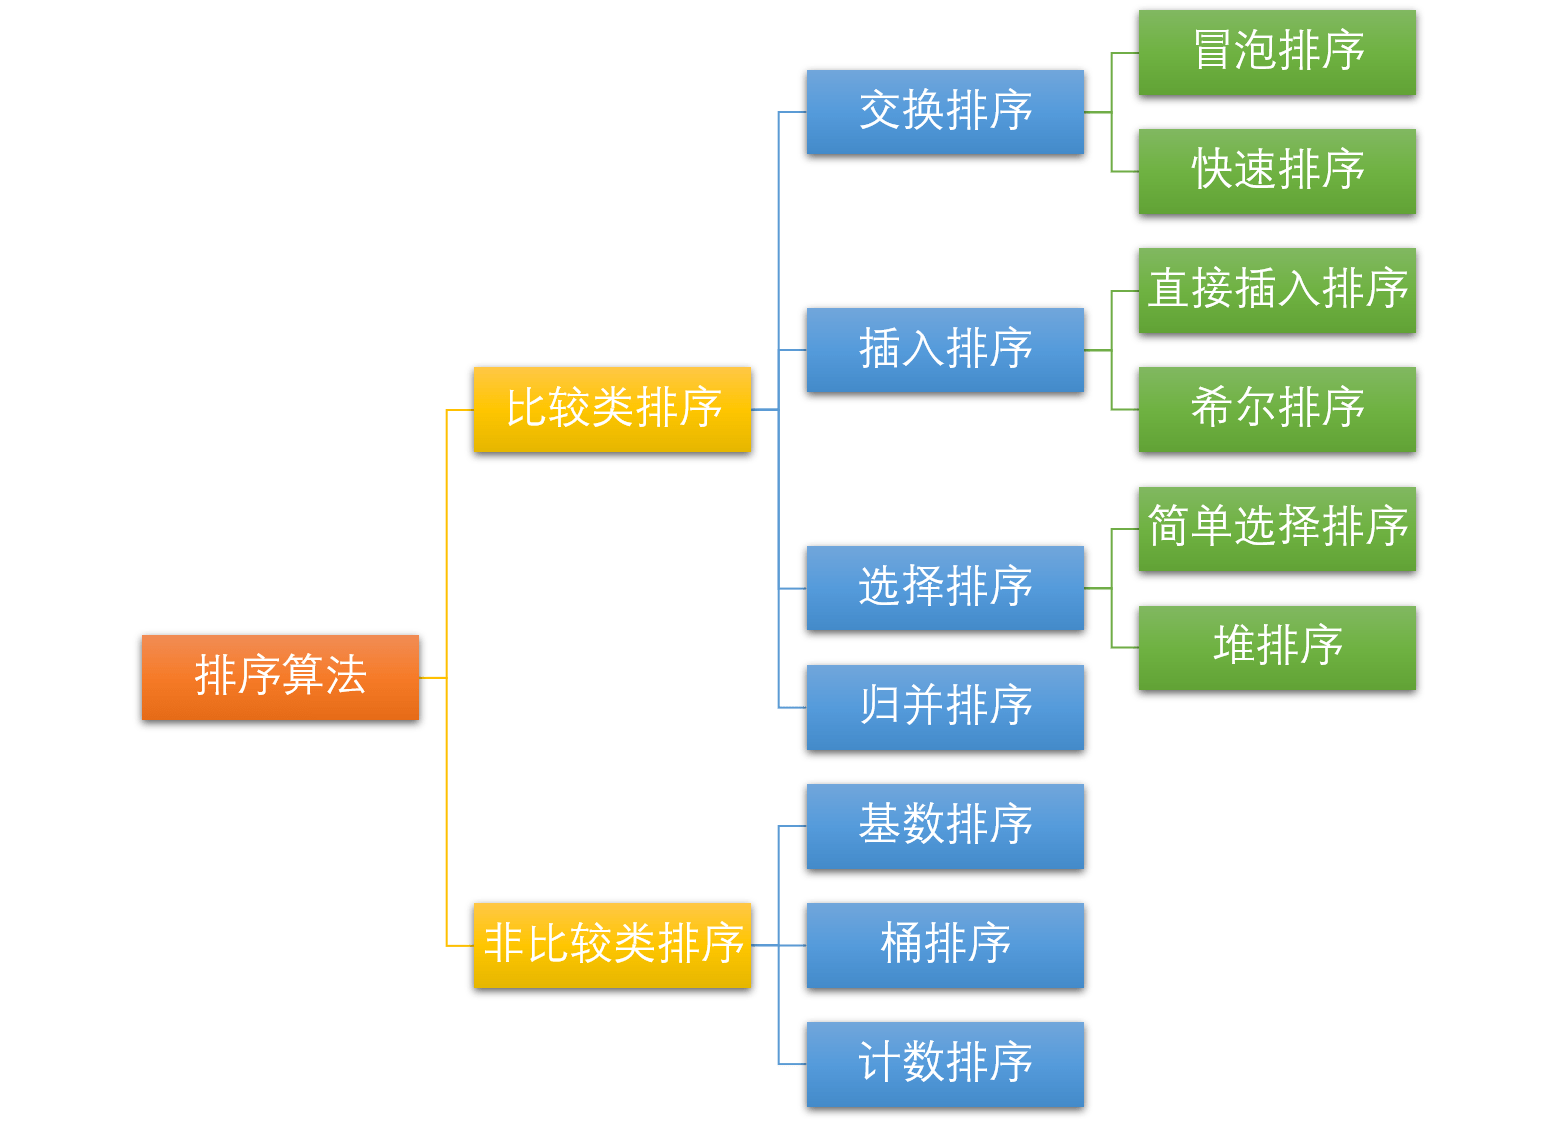
Các thuật toán như sắp xếp nhanh, sắp xếp trộn, sắp xếp heap và sắp xếp nổi bọt thường gặp đều thuộc thuật toán sắp xếp dựa trên so sánh. Sắp xếp dựa trên so sánh quyết định thứ tự tương đối giữa các phần tử bằng cách so sánh. Trong mô hình so sánh, thuật toán sorting tổng quát cần tối thiểu Ω(nlogn) lần so sánh trong trường hợp tệ nhất. Sắp xếp nổi bọt cần quét nhiều vòng, độ phức tạp thời gian trung bình là O(n²); sắp xếp trộn và sắp xếp nhanh sử dụng chia để trị để tách bài toán thành các bài toán con nhỏ hơn, độ phức tạp thời gian trung bình là O(nlogn).
Ưu điểm của sắp xếp dựa trên so sánh là phù hợp với dữ liệu ở mọi quy mô và không phụ thuộc vào phân bố dữ liệu, nên có thể thực hiện sorting trên mọi dữ liệu. Có thể nói sắp xếp dựa trên so sánh phù hợp với mọi trường hợp cần sorting.
Còn sắp xếp đếm, sắp xếp radix, sắp xếp bucket thuộc thuật toán sắp xếp không dựa trên so sánh. Chúng tận dụng thông tin bổ sung như phạm vi key, phân bố dữ liệu hoặc số chữ số để tránh cận dưới của sắp xếp dựa trên so sánh, nhưng không phải thuật toán nào cũng có thể hoàn thành với O(n) chỉ bằng một lần duyệt. Sắp xếp đếm thường có độ phức tạp O(n+k), hiệu quả của sắp xếp bucket phụ thuộc vào phân bố dữ liệu và sorting trong bucket, sắp xếp radix thường có độ phức tạp O(d(n+r)).
Sắp xếp không dựa trên so sánh có độ phức tạp thời gian thấp, nhưng vì cần chiếm dụng không gian để xác định vị trí duy nhất nên có yêu cầu nhất định về quy mô và phân bố dữ liệu.
Sắp xếp nổi bọt (Bubble Sort)
Sắp xếp nổi bọt là một thuật toán sắp xếp đơn giản. Nó lặp lại việc duyệt chuỗi cần sắp xếp, lần lượt so sánh hai phần tử; nếu thứ tự của chúng sai thì hoán đổi chúng. Việc duyệt chuỗi được lặp lại cho đến khi không còn cần hoán đổi, khi đó chuỗi đã được sắp xếp xong. Tên của algorithm bắt nguồn từ việc phần tử nhỏ hơn sẽ từ từ “nổi” lên đầu dãy thông qua các lần hoán đổi.
Các bước thuật toán
- So sánh các phần tử liền kề. Nếu phần tử thứ nhất lớn hơn phần tử thứ hai thì hoán đổi chúng;
- Thực hiện tương tự cho từng cặp phần tử liền kề, từ cặp đầu tiên đến cặp cuối cùng, khi đó phần tử cuối cùng sẽ là số lớn nhất;
- Lặp lại các bước trên cho tất cả phần tử, ngoại trừ phần tử cuối cùng;
- Lặp lại bước 1~3 cho đến khi sorting hoàn tất.
Minh họa thuật toán
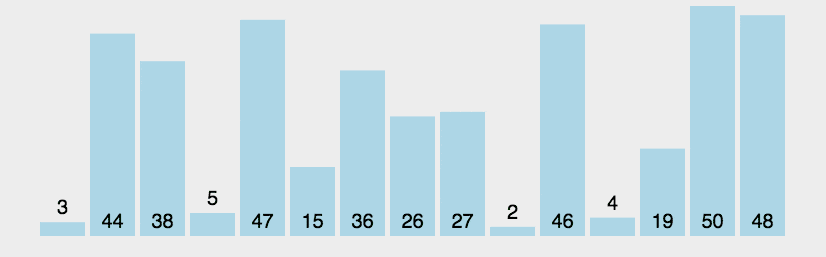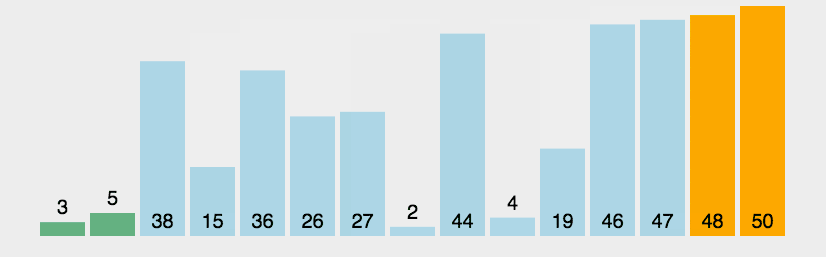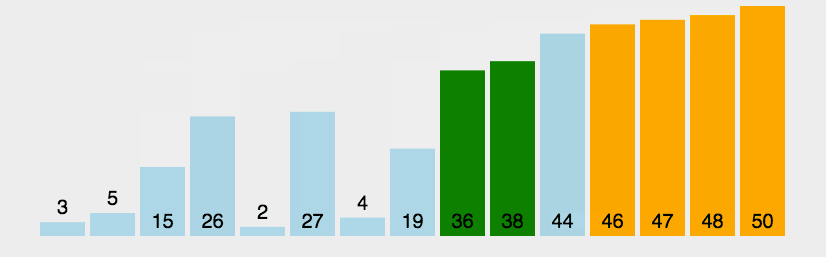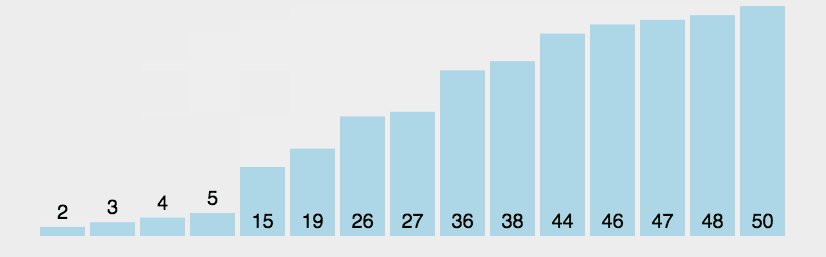
Triển khai code
/**
 * Sắp xếp nổi bọt
 * @param arr
 * @return arr
 */
public static int[] bubbleSort(int[] arr) {
    for (int i = 1; i < arr.length; i++) {
        // Đặt một flag; nếu là true nghĩa là vòng lặp chưa hoán đổi,
        // tức là chuỗi đã có thứ tự và sorting đã hoàn tất.
        boolean flag = true;
        for (int j = 0; j < arr.length - i; j++) {
            if (arr[j] > arr[j + 1]) {
                int tmp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = tmp;
        // Thay đổi flag
                flag = false;
            }
        }
        if (flag) {
            break;
        }
    }
    return arr;
}
Ở đây code được tối ưu một chút bằng cách thêm is_sorted Flag, nhằm tối ưu độ phức tạp thời gian tốt nhất của algorithm thành O(n), tức là khi chuỗi đầu vào ban đầu đã được sắp xếp thì độ phức tạp thời gian của algorithm là O(n).
Phân tích thuật toán
- Tính ổn định: ổn định
- Độ phức tạp thời gian: tốt nhất: $O(n)$, tệ nhất: $O(n^2)$, trung bình: $O(n^2)$
- Độ phức tạp không gian: $O(1)$
- Cách thức sorting: In-place
Sắp xếp chọn (Selection Sort)
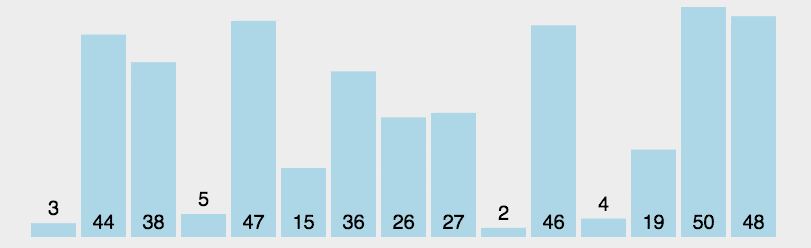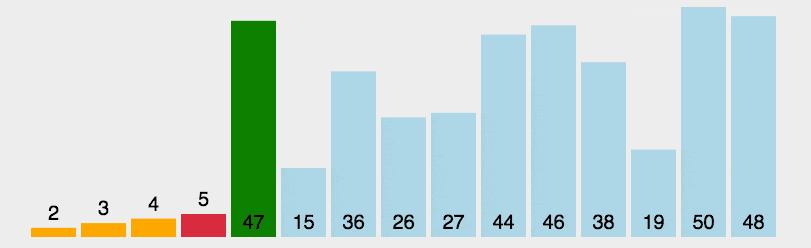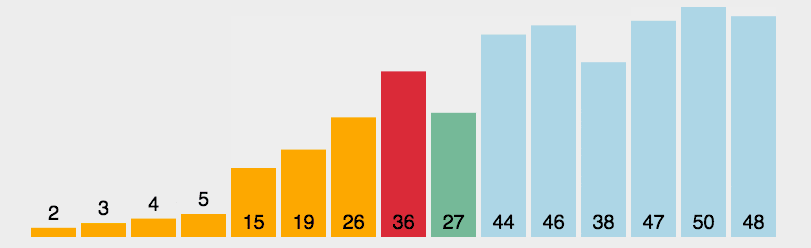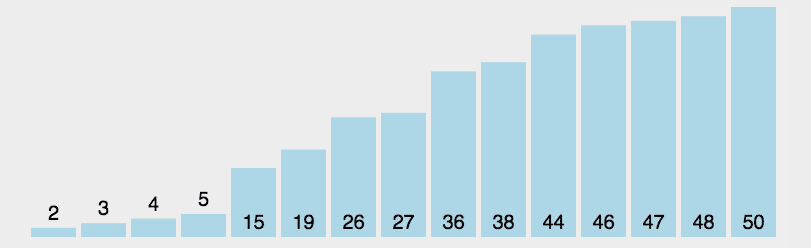
Sắp xếp chọn là một thuật toán sắp xếp đơn giản, trực quan. Với bất kỳ dữ liệu nào, độ phức tạp thời gian đều là $O(n^2)$, vì vậy quy mô dữ liệu càng nhỏ càng tốt khi sử dụng nó. Ưu điểm duy nhất có thể là không chiếm dụng memory bổ sung. Nguyên lý hoạt động: trước tiên tìm phần tử nhỏ nhất (lớn nhất) trong chuỗi chưa sắp xếp và đặt vào vị trí bắt đầu của chuỗi đã sắp xếp; sau đó tiếp tục tìm phần tử nhỏ nhất (lớn nhất) trong các phần tử chưa sắp xếp còn lại rồi đặt vào cuối chuỗi đã sắp xếp. Tiếp tục như vậy cho đến khi tất cả phần tử được sắp xếp xong.
Các bước thuật toán
- Trước tiên tìm phần tử nhỏ nhất (lớn nhất) trong chuỗi chưa sắp xếp và đặt vào vị trí bắt đầu của chuỗi đã sắp xếp
- Tiếp tục tìm phần tử nhỏ nhất (lớn nhất) trong các phần tử chưa sắp xếp còn lại rồi đặt vào cuối chuỗi đã sắp xếp.
- Lặp lại bước 2 cho đến khi tất cả phần tử được sắp xếp xong.
Minh họa thuật toán
Triển khai code
/**
 * Sắp xếp chọn
 * @param arr
 * @return arr
 */
public static int[] selectionSort(int[] arr) {
    for (int i = 0; i < arr.length - 1; i++) {
        int minIndex = i;
        for (int j = i + 1; j < arr.length; j++) {
            if (arr[j] < arr[minIndex]) {
                minIndex = j;
            }
        }
        if (minIndex != i) {
            int tmp = arr[i];
            arr[i] = arr[minIndex];
            arr[minIndex] = tmp;
        }
    }
    return arr;
}
Phân tích thuật toán
- Tính ổn định: không ổn định
- Độ phức tạp thời gian: tốt nhất: $O(n^2)$, tệ nhất: $O(n^2)$, trung bình: $O(n^2)$
- Độ phức tạp không gian: $O(1)$
- Cách thức sorting: In-place
Sắp xếp chèn (Insertion Sort)
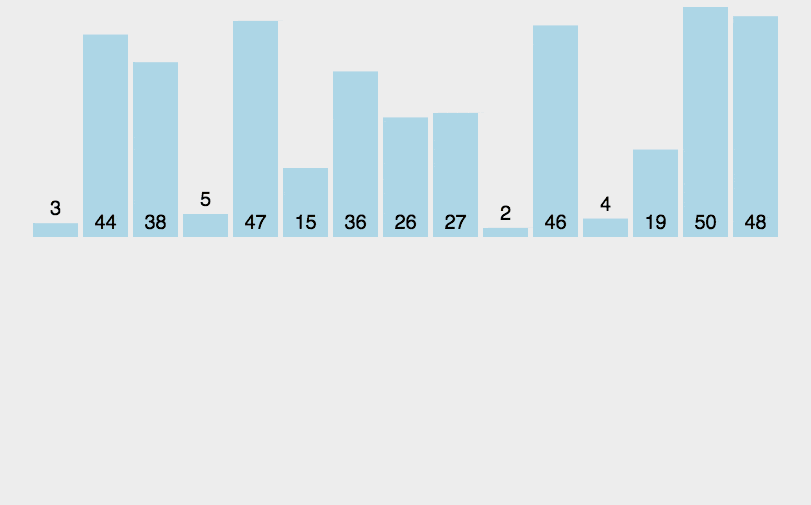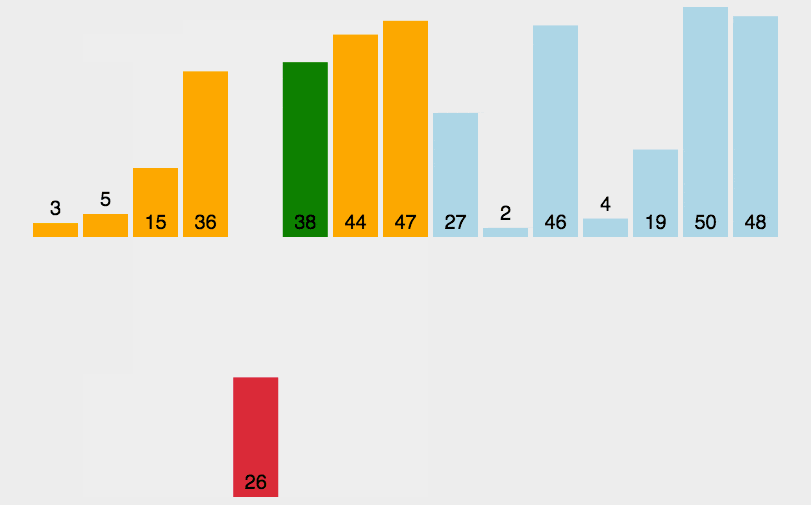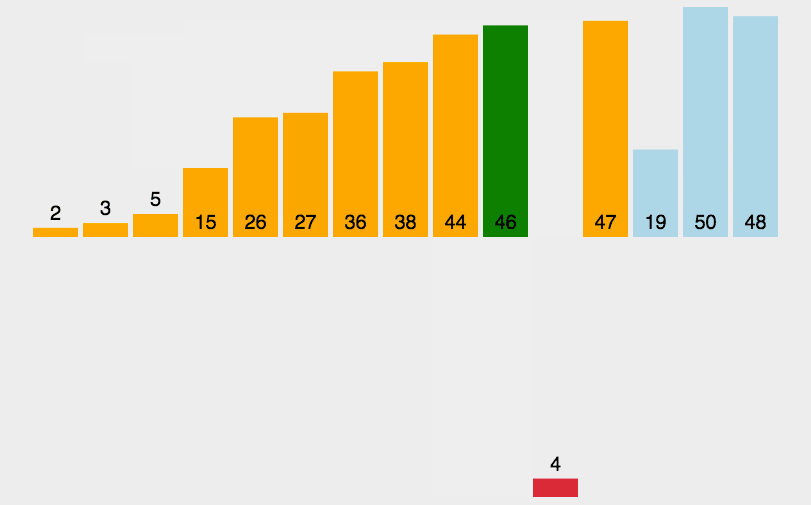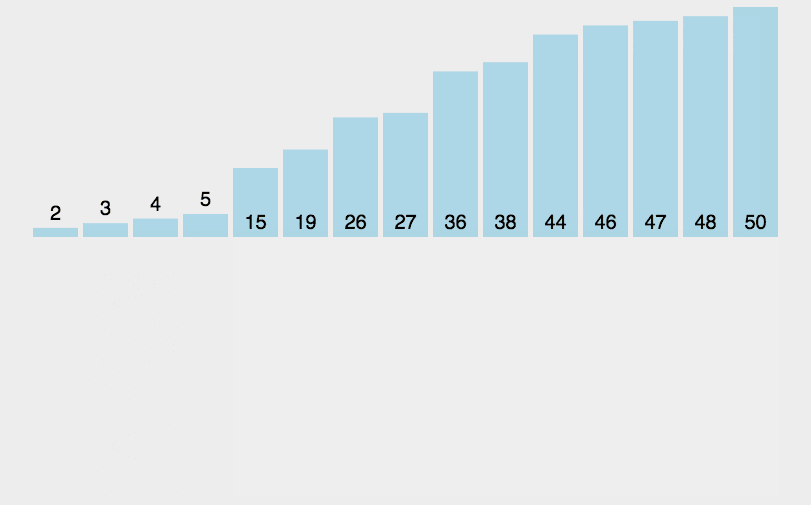
Sắp xếp chèn là một thuật toán sắp xếp đơn giản, trực quan. Nguyên lý hoạt động là xây dựng một chuỗi có thứ tự; với dữ liệu chưa sắp xếp, quét từ sau về trước trong chuỗi đã sắp xếp, tìm vị trí tương ứng rồi chèn vào. Khi triển khai, sắp xếp chèn thường dùng cách sorting in-place (tức chỉ cần thêm $O(1)$ không gian), vì vậy trong quá trình quét từ sau về trước, cần liên tục dịch dần các phần tử đã sắp xếp về sau để tạo không gian chèn cho phần tử mới.
Mặc dù code triển khai sắp xếp chèn không đơn giản và trực tiếp như sắp xếp nổi bọt và sắp xếp chọn, nhưng nguyên lý của nó có lẽ dễ hiểu nhất; người từng chơi bài poker đều có thể hiểu ngay. Sắp xếp chèn là một thuật toán sắp xếp đơn giản, trực quan; nguyên lý hoạt động là xây dựng một chuỗi có thứ tự, với dữ liệu chưa sắp xếp thì quét từ sau về trước trong chuỗi đã sắp xếp, tìm vị trí tương ứng rồi chèn vào.
Giống sắp xếp nổi bọt, sắp xếp chèn cũng có một algorithm tối ưu gọi là sắp xếp chèn nhị phân.
Các bước thuật toán
- Bắt đầu từ phần tử đầu tiên, coi phần tử này đã được sắp xếp;
- Lấy phần tử tiếp theo, quét từ sau về trước trong chuỗi các phần tử đã sắp xếp;
- Nếu phần tử đó (đã sắp xếp) lớn hơn phần tử mới thì dịch phần tử đó sang vị trí tiếp theo;
- Lặp lại bước 3 cho đến khi tìm thấy vị trí có phần tử đã sắp xếp nhỏ hơn hoặc bằng phần tử mới;
- Chèn phần tử mới vào sau vị trí đó;
- Lặp lại bước 2~5.
Minh họa thuật toán
Triển khai code
/**
 * Sắp xếp chèn
 * @param arr
 * @return arr
 */
public static int[] insertionSort(int[] arr) {
    for (int i = 1; i < arr.length; i++) {
        int preIndex = i - 1;
        int current = arr[i];
        while (preIndex >= 0 && current < arr[preIndex]) {
            arr[preIndex + 1] = arr[preIndex];
            preIndex -= 1;
        }
        arr[preIndex + 1] = current;
    }
    return arr;
}
Phân tích thuật toán
- Tính ổn định: ổn định
- Độ phức tạp thời gian: tốt nhất: $O(n)$, tệ nhất: $O(n^2)$, trung bình: $O(n^2)$
- Độ phức tạp không gian: $O(1)$
- Cách thức sorting: In-place
Sắp xếp Shell (Shell Sort)
Sắp xếp Shell là một thuật toán sắp xếp do Shell (Donald Shell) đề xuất năm 1959. Sắp xếp Shell cũng là một dạng sắp xếp chèn, là phiên bản hiệu quả hơn sau khi cải tiến từ sắp xếp chèn đơn giản, còn được gọi là thuật toán sắp xếp theo increment giảm dần. Hiệu năng của nó phụ thuộc rất nhiều vào chuỗi increment: một số chuỗi increment được thiết kế sau này có thể đạt cận trên dưới bậc hai, nhưng chuỗi increment nguyên bản của Shell được sử dụng trong bài viết này vẫn có trường hợp tệ nhất là $O(n^2)$.
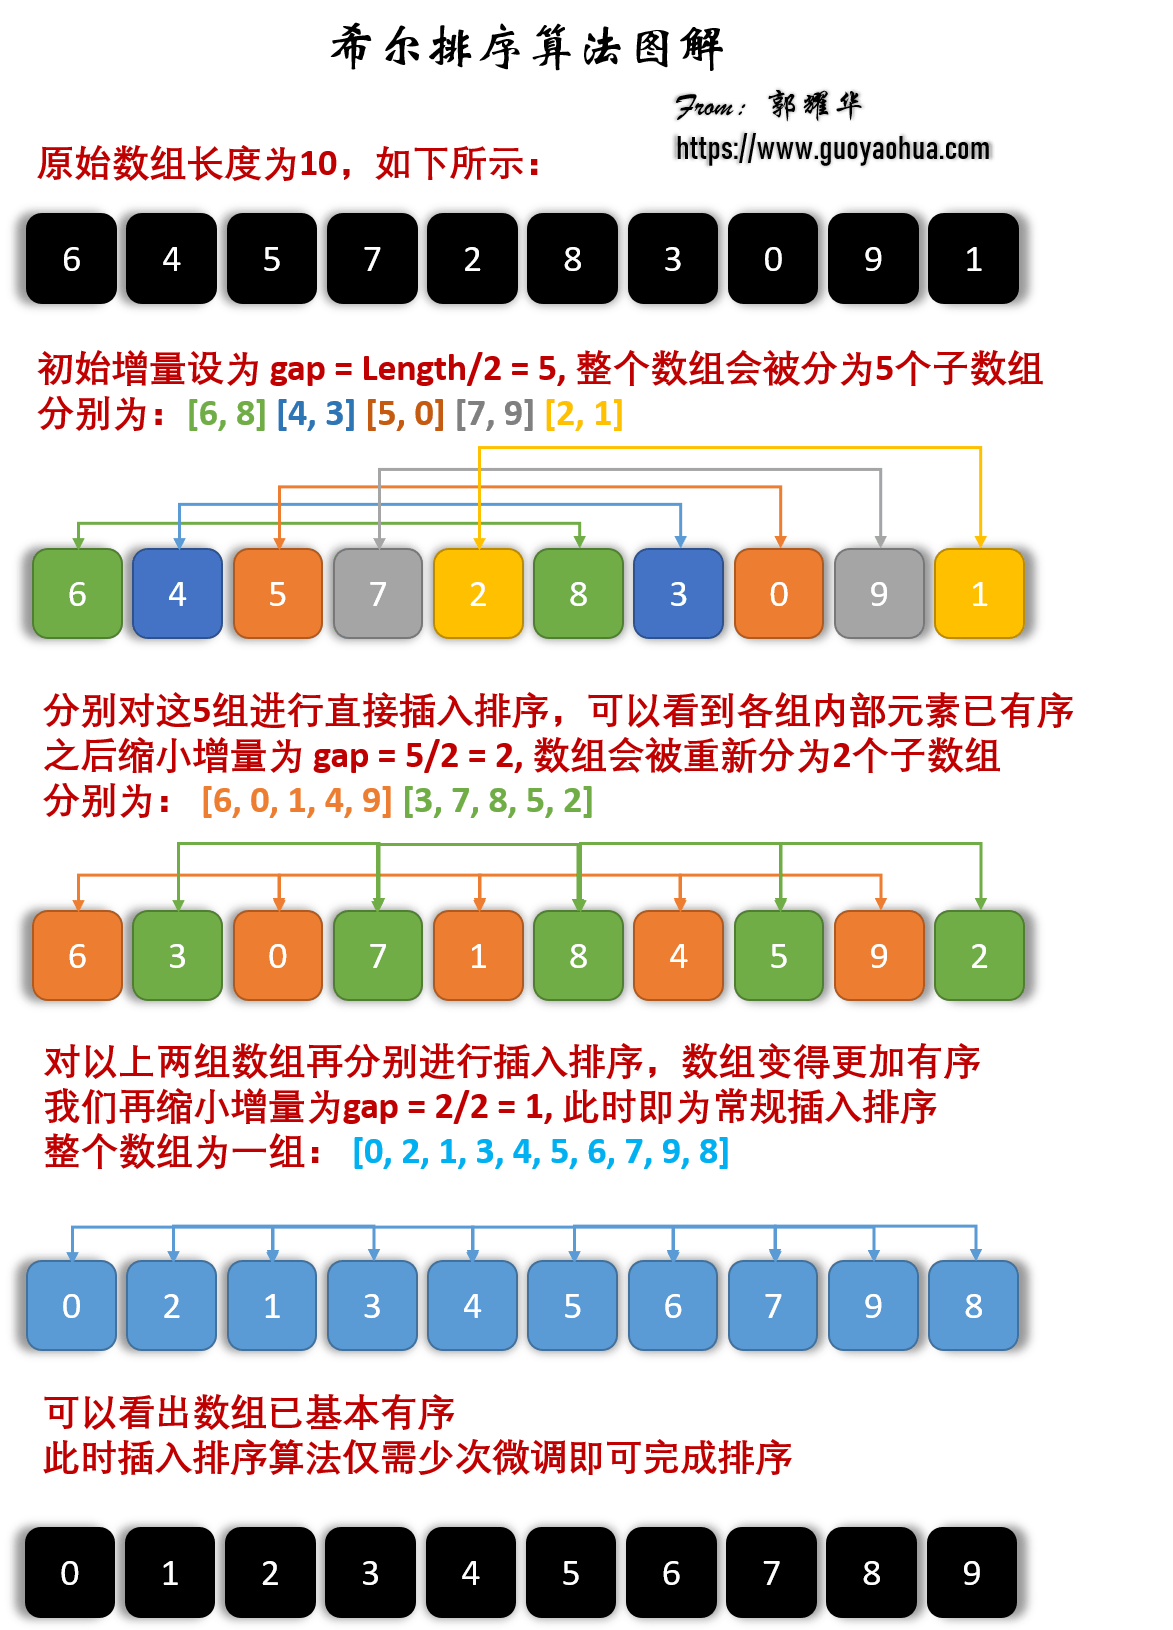
Ý tưởng cơ bản của sắp xếp Shell là: trước tiên chia toàn bộ chuỗi bản ghi cần sắp xếp thành một số chuỗi con để lần lượt thực hiện sắp xếp chèn trực tiếp; khi các bản ghi trong toàn bộ chuỗi đã “gần có thứ tự”, tiếp tục thực hiện sắp xếp chèn trực tiếp lần lượt trên toàn bộ bản ghi.
Các bước thuật toán
Hãy xem các bước cơ bản của sắp xếp Shell. Ở đây chọn increment $gap=length/2$, tiếp tục thu nhỏ increment theo cách $gap = gap/2$. Cách chọn increment này có thể biểu diễn bằng chuỗi $\lbrace \frac{n}{2}, \frac{(n/2)}{2}, \dots, 1 \rbrace$, gọi là chuỗi increment. Việc lựa chọn và chứng minh chuỗi increment của sắp xếp Shell là một bài toán khó về mặt toán học. Chuỗi increment được chọn ở đây khá phổ biến, đồng thời là chuỗi increment Shell đề xuất, nhưng thực tế chuỗi increment này không tối ưu. Ví dụ dưới đây sử dụng increment Shell.
Trước tiên chia toàn bộ chuỗi bản ghi cần sắp xếp thành một số chuỗi con để lần lượt thực hiện sắp xếp chèn trực tiếp. Mô tả cụ thể:
- Chọn một chuỗi increment $\lbrace t_1, t_2, \dots, t_k \rbrace$, trong đó $t_i \gt t_j, i \lt j, t_k = 1$;
- Dựa trên số lượng k của chuỗi increment, thực hiện sorting chuỗi trong k lượt;
- Ở mỗi lượt sorting, dựa trên increment $t$ tương ứng, chia chuỗi cần sắp xếp thành một số chuỗi con có độ dài $m$, rồi thực hiện sắp xếp chèn trực tiếp cho từng bảng con. Chỉ khi hệ số increment bằng 1 thì toàn bộ chuỗi mới được xử lý như một bảng, độ dài bảng chính là độ dài toàn bộ chuỗi.
Minh họa thuật toán
Triển khai code
/**
 * Sắp xếp Shell
 *
 * @param arr
 * @return arr
 */
public static int[] shellSort(int[] arr) {
    int n = arr.length;
    int gap = n / 2;
    while (gap > 0) {
        for (int i = gap; i < n; i++) {
            int current = arr[i];
            int preIndex = i - gap;
            // Sắp xếp chèn
            while (preIndex >= 0 && arr[preIndex] > current) {
                arr[preIndex + gap] = arr[preIndex];
                preIndex -= gap;
            }
            arr[preIndex + gap] = current;

        }
        gap /= 2;
    }
    return arr;
}
Phân tích thuật toán
- Tính ổn định: không ổn định
- Độ phức tạp thời gian: tốt nhất: $O(nlogn)$, tệ nhất: $O(n^2)$, độ phức tạp trung bình phụ thuộc vào chuỗi increment
- Độ phức tạp không gian: $O(1)$
Sắp xếp trộn (Merge Sort)
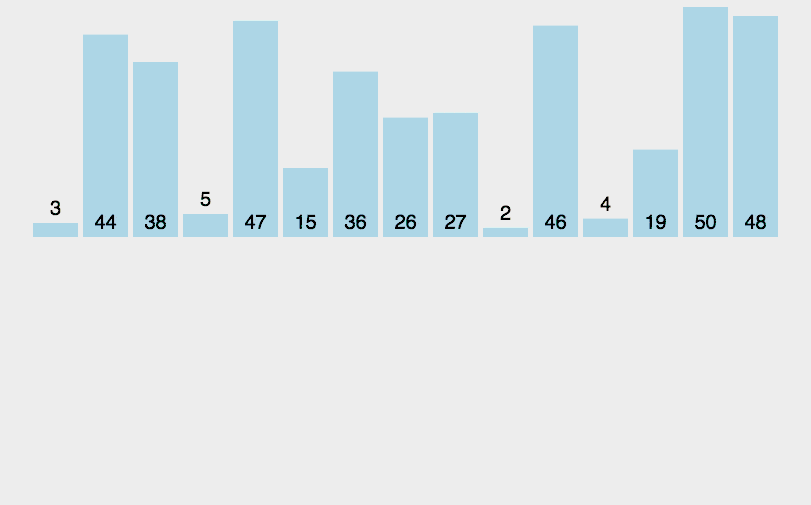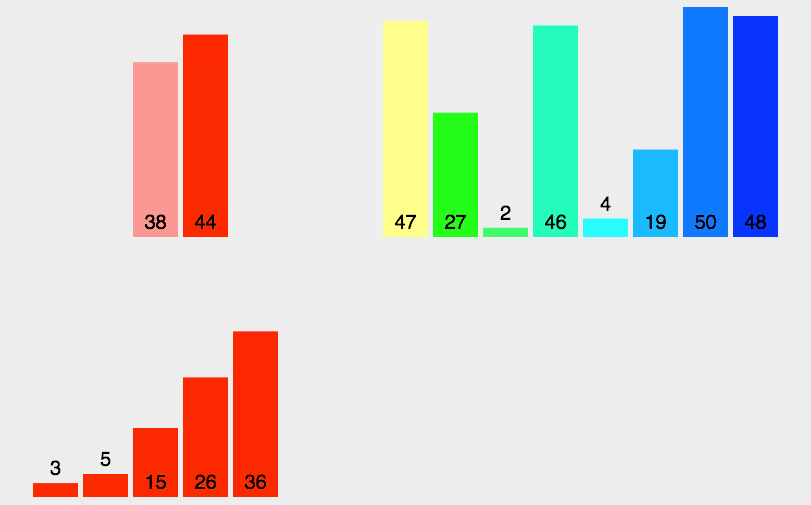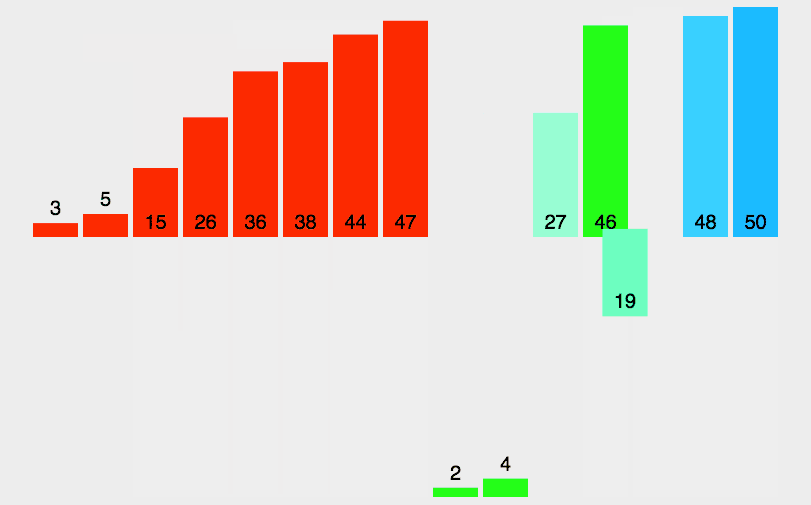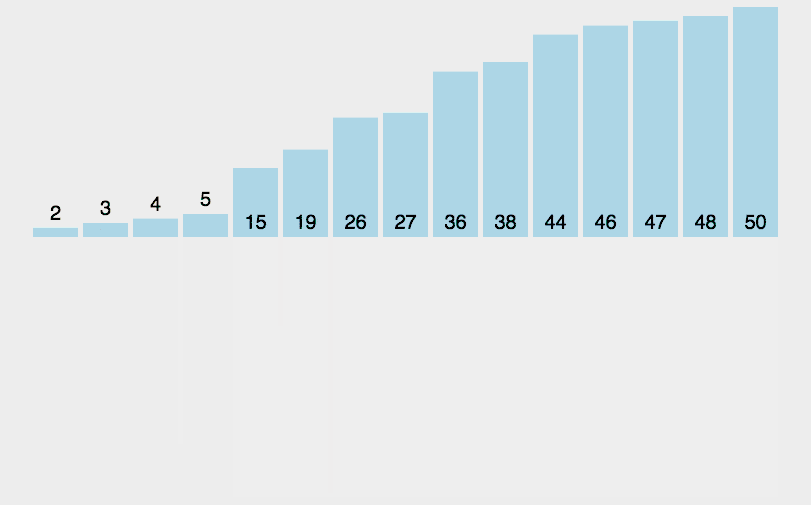
Sắp xếp trộn là một thuật toán sắp xếp hiệu quả dựa trên thao tác trộn. Algorithm này là một ứng dụng rất điển hình của phương pháp chia để trị (Divide and Conquer). Sắp xếp trộn là một phương pháp sorting ổn định. Trộn các chuỗi con đã có thứ tự để thu được chuỗi hoàn toàn có thứ tự; tức là trước tiên làm cho từng chuỗi con có thứ tự, sau đó trộn các chuỗi con đã có thứ tự thành một chuỗi hoàn chỉnh. Nếu trộn hai bảng đã có thứ tự thành một bảng có thứ tự thì gọi là trộn 2 đường.
Giống sắp xếp chọn, hiệu năng của sắp xếp trộn không bị ảnh hưởng bởi dữ liệu đầu vào, nhưng tốt hơn nhiều so với sắp xếp chọn vì luôn có độ phức tạp thời gian $O(nlogn)$. Đổi lại, nó cần thêm không gian memory.
Các bước thuật toán
Thuật toán sắp xếp trộn là một quy trình đệ quy, điều kiện biên là khi chuỗi đầu vào chỉ có một phần tử thì trả về trực tiếp. Quy trình cụ thể:
- Nếu đầu vào chỉ có một phần tử thì trả về trực tiếp; nếu không, chia chuỗi đầu vào độ dài $n$ thành hai chuỗi con có độ dài $n/2$;
- Lần lượt thực hiện sắp xếp trộn trên hai chuỗi con này để chúng trở thành các chuỗi có thứ tự;
- Đặt hai pointer lần lượt trỏ đến vị trí bắt đầu của hai chuỗi con đã sắp xếp;
- So sánh các phần tử mà hai pointer trỏ đến, chọn phần tử tương đối nhỏ hơn đưa vào không gian trộn (dùng để lưu kết quả sorting), rồi di chuyển pointer đến vị trí tiếp theo;
- Lặp lại bước 3 ~ 4 cho đến khi một pointer chạm cuối chuỗi;
- Sao chép trực tiếp toàn bộ phần tử còn lại của chuỗi kia vào cuối chuỗi trộn.
Minh họa thuật toán
Triển khai code
/**
 * Sắp xếp trộn
 *
 * @param arr
 * @return arr
 */
public static int[] mergeSort(int[] arr) {
    if (arr.length <= 1) {
        return arr;
    }
    int middle = arr.length / 2;
    int[] arr_1 = Arrays.copyOfRange(arr, 0, middle);
    int[] arr_2 = Arrays.copyOfRange(arr, middle, arr.length);
    return merge(mergeSort(arr_1), mergeSort(arr_2));
}

/**
 * Merge two sorted arrays
 *
 * @param arr_1
 * @param arr_2
 * @return sorted_arr
 */
public static int[] merge(int[] arr_1, int[] arr_2) {
    int[] sorted_arr = new int[arr_1.length + arr_2.length];
    int idx = 0, idx_1 = 0, idx_2 = 0;
    while (idx_1 < arr_1.length && idx_2 < arr_2.length) {
        if (arr_1[idx_1] <= arr_2[idx_2]) {
            sorted_arr[idx] = arr_1[idx_1];
            idx_1 += 1;
        } else {
            sorted_arr[idx] = arr_2[idx_2];
            idx_2 += 1;
        }
        idx += 1;
    }
    if (idx_1 < arr_1.length) {
        while (idx_1 < arr_1.length) {
            sorted_arr[idx] = arr_1[idx_1];
            idx_1 += 1;
            idx += 1;
        }
    } else {
        while (idx_2 < arr_2.length) {
            sorted_arr[idx] = arr_2[idx_2];
            idx_2 += 1;
            idx += 1;
        }
    }
    return sorted_arr;
}
Phân tích thuật toán
- Tính ổn định: ổn định
- Độ phức tạp thời gian: tốt nhất: $O(nlogn)$, tệ nhất: $O(nlogn)$, trung bình: $O(nlogn)$
- Độ phức tạp không gian: $O(n)$
Sắp xếp nhanh (Quick Sort)
Sắp xếp nhanh sử dụng tư tưởng chia để trị, sắp xếp trộn cũng vậy. Thoạt nhìn, sắp xếp nhanh và sắp xếp trộn rất giống nhau: đều làm nhỏ bài toán, trước tiên sắp xếp chuỗi con rồi cuối cùng hợp nhất. Điểm khác là khi chia bài toán con, sắp xếp nhanh thực hiện thêm một bước xử lý để chia hai nhóm dữ liệu thành một nhóm lớn và một nhóm nhỏ, nhờ đó khi hợp nhất cuối cùng không cần so sánh như sắp xếp trộn. Tuy nhiên chính vì việc phân chia không cố định nên độ phức tạp thời gian của sắp xếp nhanh không ổn định.
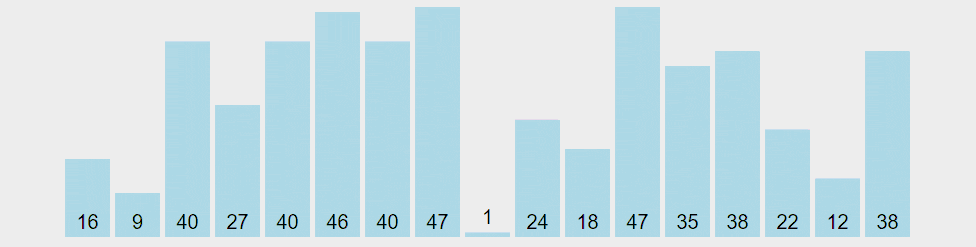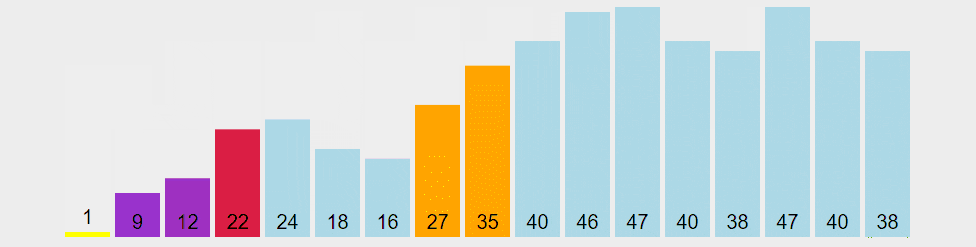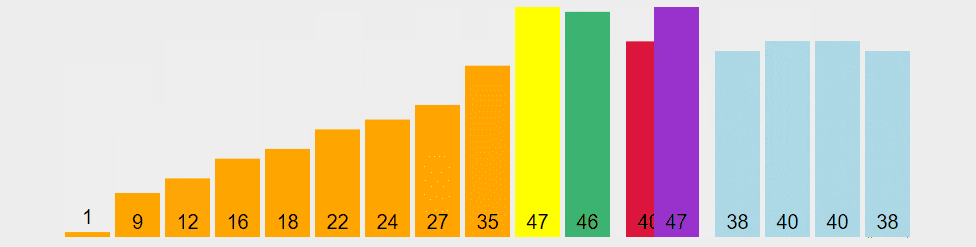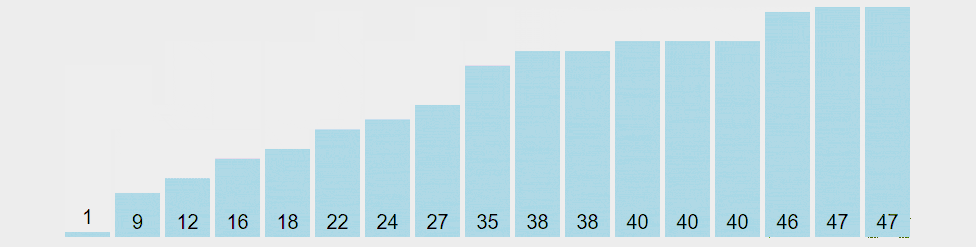
Ý tưởng cơ bản của sắp xếp nhanh: thông qua một lượt sorting, tách chuỗi cần sắp xếp thành hai phần độc lập, trong đó mọi phần tử của một phần đều nhỏ hơn phần tử của phần kia; sau đó tiếp tục sorting hai chuỗi con này để toàn bộ chuỗi có thứ tự.
Các bước thuật toán
Sắp xếp nhanh sử dụng chiến lược chia để trị (Divide and conquer) để chia một chuỗi thành một chuỗi con nhỏ hơn và một chuỗi con lớn hơn, sau đó đệ quy sorting hai chuỗi con. Mô tả cụ thể:
- Chọn pivot (Pivot): chọn một phần tử trong array làm pivot. Để tránh trường hợp tệ nhất, thường chọn ngẫu nhiên.
- Phân vùng (Partition): sắp xếp lại chuỗi, đặt mọi phần tử nhỏ hơn giá trị pivot ở trước pivot và mọi phần tử lớn hơn pivot ở sau pivot (các số bằng nhau có thể ở một trong hai phía). Sau thao tác này, pivot nằm ở vị trí giữa dãy.
- Đệ quy (Recurse): đệ quy thực hiện sắp xếp nhanh trên chuỗi con gồm các phần tử nhỏ hơn pivot và chuỗi con gồm các phần tử lớn hơn pivot.
Về hiệu năng, đây cũng là khác biệt then chốt giữa nó và sắp xếp trộn:
- Trường hợp trung bình và tốt nhất: độ phức tạp thời gian là $O(nlogn)$. Trường hợp này xảy ra khi mỗi lần phân vùng đều chia array thành hai nửa bằng nhau.
- Trường hợp tệ nhất: độ phức tạp thời gian suy biến thành $O(n^2)$. Điều này xảy ra khi pivot được chọn mỗi lần đều là giá trị nhỏ nhất hoặc lớn nhất của array hiện tại, chẳng hạn với array đã có thứ tự, nếu mỗi lần đều chọn phần tử đầu tiên làm pivot thì phân vùng sẽ cực kỳ không cân bằng và algorithm suy biến thành dạng tương tự sắp xếp nổi bọt. Đây là lý do chọn pivot ngẫu nhiên rất quan trọng.
Minh họa thuật toán
Triển khai code
import java.util.concurrent.ThreadLocalRandom;

class Solution {
    public int[] sortArray(int[] a) {
        quick(a, 0, a.length - 1);
        return a;
    }

    // Hàm đệ quy cốt lõi của sắp xếp nhanh
    void quick(int[] a, int left, int right) {
        if (left >= right) { // Điều kiện kết thúc đệ quy: khoảng chỉ có một hoặc không có phần tử
            return;
        }
        int p = partition(a, left, right); // Thao tác phân vùng, trả về index phân vùng
        quick(a, left, p - 1); // Đệ quy sorting sub-array bên trái
        quick(a, p + 1, right); // Đệ quy sorting sub-array bên phải
    }

    // Hàm phân vùng: chia array thành hai phần, phần nhỏ hơn pivot ở bên trái, phần lớn hơn ở bên phải
    int partition(int[] a, int left, int right) {
        // Chọn ngẫu nhiên một điểm pivot để tránh trường hợp tệ nhất (chẳng hạn array gần có thứ tự)
        int idx = ThreadLocalRandom.current().nextInt(right - left + 1) + left;
        swap(a, left, idx); // Đặt điểm pivot ở ngoài cùng bên trái của array
        int pv = a[left]; // Giá trị pivot
        int i = left + 1; // Pointer trái, trỏ đến phần tử hiện cần kiểm tra
        int j = right; // Pointer phải, tìm phần tử nhỏ hơn pivot từ phải sang trái

        while (i <= j) {
            // Di chuyển pointer trái sang phải cho đến khi tìm thấy phần tử lớn hơn hoặc bằng pivot
            while (i <= j && a[i] < pv) {
                i++;
            }
            // Di chuyển pointer phải sang trái cho đến khi tìm thấy phần tử nhỏ hơn hoặc bằng pivot
            while (i <= j && a[j] > pv) {
                j--;
            }
            // Nếu pointer trái chưa vượt pointer phải, hoán đổi hai phần tử sai vị trí
            if (i <= j) {
                swap(a, i, j);
                i++;
                j--;
            }
        }
        // Đặt pivot vào vị trí phân vùng, để phần bên trái pivot nhỏ hơn nó và phần bên phải lớn hơn nó
        swap(a, j, left);
        return j;
    }

    // Hoán đổi vị trí của hai phần tử trong array
    void swap(int[] a, int i, int j) {
        int t = a[i];
        a[i] = a[j];
        a[j] = t;
    }
}
Phân tích thuật toán
- Tính ổn định: không ổn định
- Độ phức tạp thời gian: tốt nhất: $O(nlogn)$, tệ nhất: $O(n^2)$, trung bình: $O(nlogn)$
- Độ phức tạp không gian: trung bình $O(logn)$, tệ nhất $O(n)$ (stack của các lời gọi đệ quy)
Sắp xếp heap (Heap Sort)
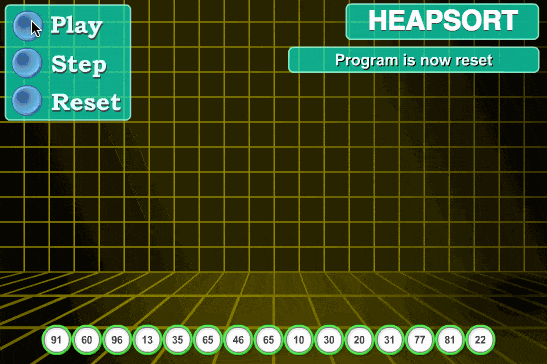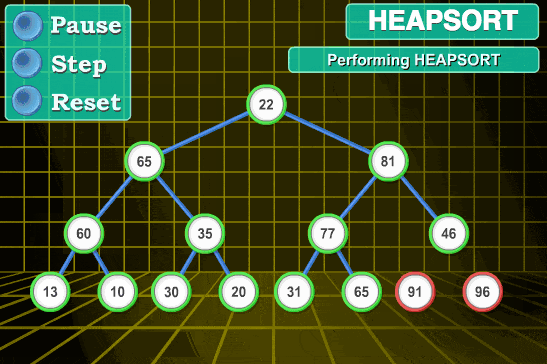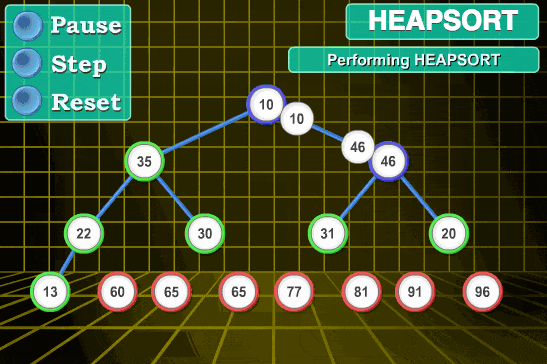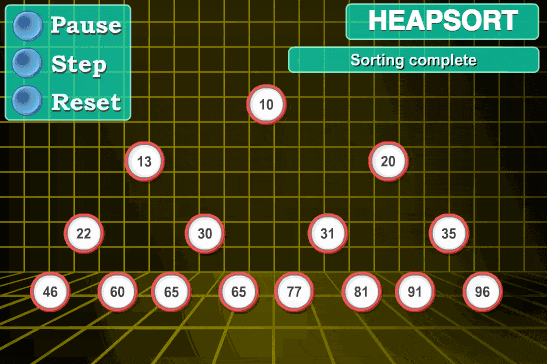
Sắp xếp heap là một thuật toán sorting được thiết kế dựa trên cấu trúc dữ liệu heap. Heap là một cấu trúc gần giống complete binary tree và đồng thời thỏa mãn tính chất heap: giá trị của node con luôn nhỏ hơn (hoặc lớn hơn) node cha.
Các bước thuật toán
- Xây dựng chuỗi ban đầu cần sắp xếp $(R_1, R_2, \dots, R_n)$ thành max heap, heap này là vùng chưa có thứ tự ban đầu;
- Hoán đổi đỉnh heap $R_1$ với phần tử cuối $R_n$, khi đó thu được vùng chưa có thứ tự mới $(R_1, R_2, \dots, R_{n-1})$ và vùng có thứ tự mới $R_n$, đồng thời thỏa mãn $R_i \leqslant R_n (i \in 1, 2,\dots, n-1)$;
- Sau khi hoán đổi, phần tử đầu heap mới $R_1$ có thể vi phạm tính chất heap, vì vậy cần điều chỉnh vùng chưa có thứ tự hiện tại $(R_1, R_2, \dots, R_{n-1})$ thành heap mới, rồi lại hoán đổi $R_1$ với phần tử cuối vùng chưa có thứ tự. Khi đó thu được vùng chưa có thứ tự mới $(R_1, R_2, \dots, R_{n-2})$ và vùng có thứ tự mới $(R_{n-1}, R_n)$. Lặp lại quá trình này cho đến khi vùng có thứ tự có $n-1$ phần tử, khi đó toàn bộ quá trình sorting hoàn tất.
Minh họa thuật toán
Triển khai code
// Biến toàn cục ghi lại độ dài của array;
static int heapLen;

/**
 * Hoán đổi hai phần tử của array
 * @param arr
 * @param i
 * @param j
 */
private static void swap(int[] arr, int i, int j) {
    int tmp = arr[i];
    arr[i] = arr[j];
    arr[j] = tmp;
}

/**
 * Xây dựng Max Heap
 * @param arr
 */
private static void buildMaxHeap(int[] arr) {
    for (int i = arr.length / 2 - 1; i >= 0; i--) {
        heapify(arr, i);
    }
}

/**
 * Điều chỉnh thành max heap
 * @param arr
 * @param i
 */
private static void heapify(int[] arr, int i) {
    int left = 2 * i + 1;
    int right = 2 * i + 2;
    int largest = i;
    if (right < heapLen && arr[right] > arr[largest]) {
        largest = right;
    }
    if (left < heapLen && arr[left] > arr[largest]) {
        largest = left;
    }
    if (largest != i) {
        swap(arr, largest, i);
        heapify(arr, largest);
    }
}

/**
 * Sắp xếp heap
 * @param arr
 * @return
 */
public static int[] heapSort(int[] arr) {
    // index ở cuối heap
    heapLen = arr.length;
    // xây dựng MaxHeap
    buildMaxHeap(arr);
    for (int i = arr.length - 1; i > 0; i--) {
        // Lần lượt di chuyển đỉnh heap đến cuối heap
        swap(arr, 0, i);
        heapLen -= 1;
        heapify(arr, 0);
    }
    return arr;
}
Phân tích thuật toán
- Tính ổn định: không ổn định
- Độ phức tạp thời gian: tốt nhất: $O(nlogn)$, tệ nhất: $O(nlogn)$, trung bình: $O(nlogn)$
- Độ phức tạp không gian: $O(1)$
Sắp xếp đếm (Counting Sort)
Cốt lõi của sắp xếp đếm là chuyển giá trị dữ liệu đầu vào thành key và lưu trong một array được cấp phát thêm. Là một thuật toán có độ phức tạp thời gian tuyến tính, sắp xếp đếm yêu cầu dữ liệu đầu vào phải là các số nguyên có phạm vi xác định.
Sắp xếp đếm (Counting sort) là một thuật toán sorting ổn định. Sắp xếp đếm sử dụng một array bổ sung C, trong đó phần tử thứ i là số lượng phần tử trong array A có giá trị bằng i. Sau đó dựa vào array C để đưa các phần tử trong A vào đúng vị trí. Nó chỉ có thể sorting số nguyên.
Các bước thuật toán
- Tìm giá trị lớn nhất
maxvà nhỏ nhấtmintrong array; - Tạo một array mới
Ccó độ dàimax-min+1, giá trị mặc định của mọi phần tử là 0; - Duyệt array gốc
A, với từng phần tửA[i], dùngA[i] - minlàm index của arrayC, dùng số lần xuất hiện của giá trịA[i]trongAlàm giá trị củaC[A[i] - min]; - Biến đổi array
C, giá trị phần tử mới là tổng của giá trị phần tử đó với phần tử trước, tức khii>1thìC[i] = C[i] + C[i-1]; - Tạo array kết quả
Rcó độ dài bằng array gốc. - Duyệt array gốc
Atừ sau về trước, với từng phần tửA[i], dùngA[i]trừ giá trị nhỏ nhấtminlàm index, tìm trong array đếmCgiá trị tương ứngC[A[i] - min],C[A[i] - min] - 1chính là vị trí củaA[i]trong array kết quảR; sau khi thực hiện xong các thao tác trên, giảmcount[A[i] - min]đi 1.
Minh họa thuật toán
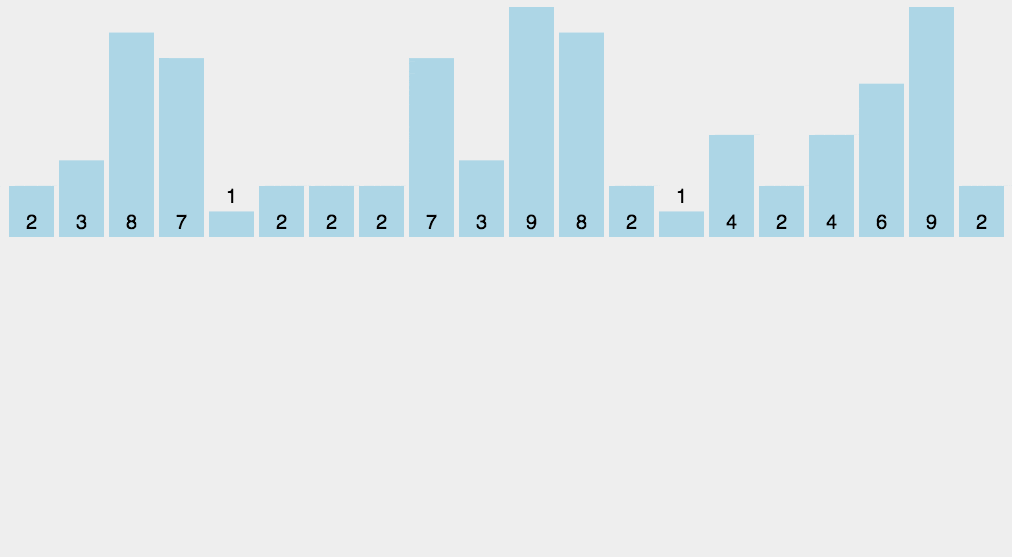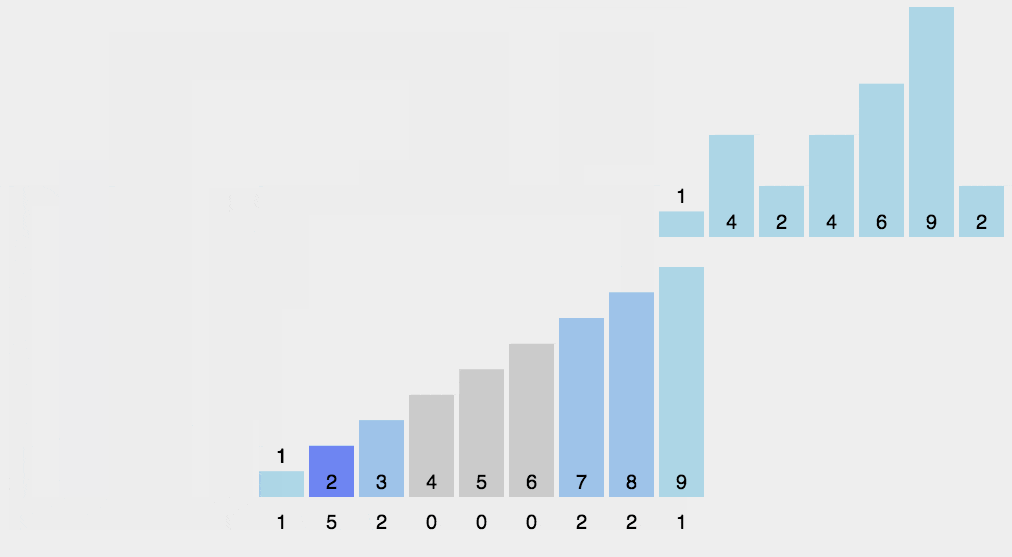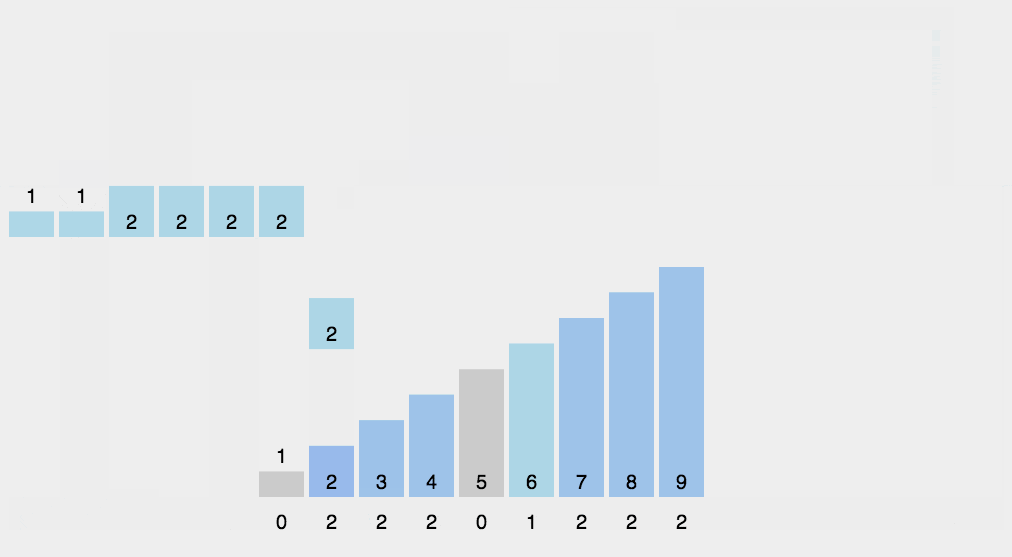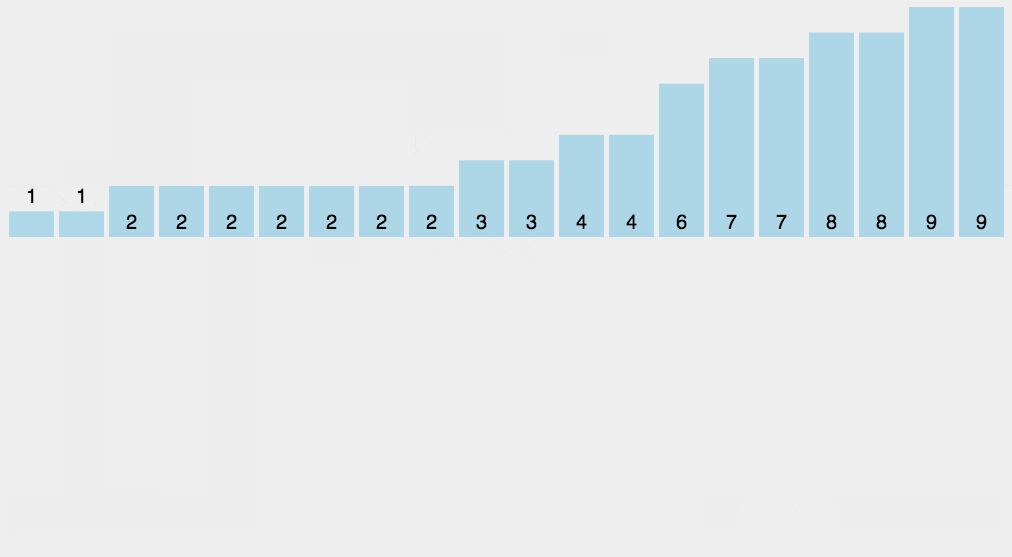
Triển khai code
/**
 * Lấy giá trị lớn nhất và nhỏ nhất trong array
 *
 * @param arr
 * @return
 */
private static int[] getMinAndMax(int[] arr) {
    int maxValue = arr[0];
    int minValue = arr[0];
    for (int i = 0; i < arr.length; i++) {
        if (arr[i] > maxValue) {
            maxValue = arr[i];
        } else if (arr[i] < minValue) {
            minValue = arr[i];
        }
    }
    return new int[] { minValue, maxValue };
}

/**
 * Sắp xếp đếm
 *
 * @param arr
 * @return
 */
public static int[] countingSort(int[] arr) {
    if (arr.length < 2) {
        return arr;
    }
    int[] extremum = getMinAndMax(arr);
    int minValue = extremum[0];
    int maxValue = extremum[1];
    int[] countArr = new int[maxValue - minValue + 1];
    int[] result = new int[arr.length];

    for (int i = 0; i < arr.length; i++) {
        countArr[arr[i] - minValue] += 1;
    }
    for (int i = 1; i < countArr.length; i++) {
        countArr[i] += countArr[i - 1];
    }
    for (int i = arr.length - 1; i >= 0; i--) {
        int idx = countArr[arr[i] - minValue] - 1;
        result[idx] = arr[i];
        countArr[arr[i] - minValue] -= 1;
    }
    return result;
}
Phân tích thuật toán
Khi các phần tử đầu vào là n số nguyên trong khoảng từ 0 đến k, thời gian chạy là $O(n+k)$. Sắp xếp đếm không phải sắp xếp dựa trên so sánh, nên sorting nhanh hơn mọi thuật toán sắp xếp dựa trên so sánh. Vì độ dài của array C dùng để đếm phụ thuộc vào phạm vi dữ liệu trong array cần sắp xếp (bằng hiệu giữa giá trị lớn nhất và nhỏ nhất cộng 1), sắp xếp đếm cần rất nhiều không gian memory bổ sung với array có phạm vi dữ liệu lớn.
- Tính ổn định: ổn định
- Độ phức tạp thời gian: tốt nhất: $O(n+k)$, tệ nhất: $O(n+k)$, trung bình: $O(n+k)$
- Độ phức tạp không gian: $O(n+k)$
Sắp xếp bucket (Bucket Sort)
Sắp xếp bucket là phiên bản nâng cấp của sắp xếp đếm. Nó tận dụng quan hệ ánh xạ giữa dữ liệu và bucket, trong đó việc xác định hàm ánh xạ là yếu tố then chốt quyết định hiệu quả. Để sắp xếp bucket hiệu quả hơn, cần làm hai việc:
- Khi không gian bổ sung đủ, cố gắng tăng số lượng bucket
- Sử dụng hàm ánh xạ có thể phân phối đều N dữ liệu đầu vào vào K bucket
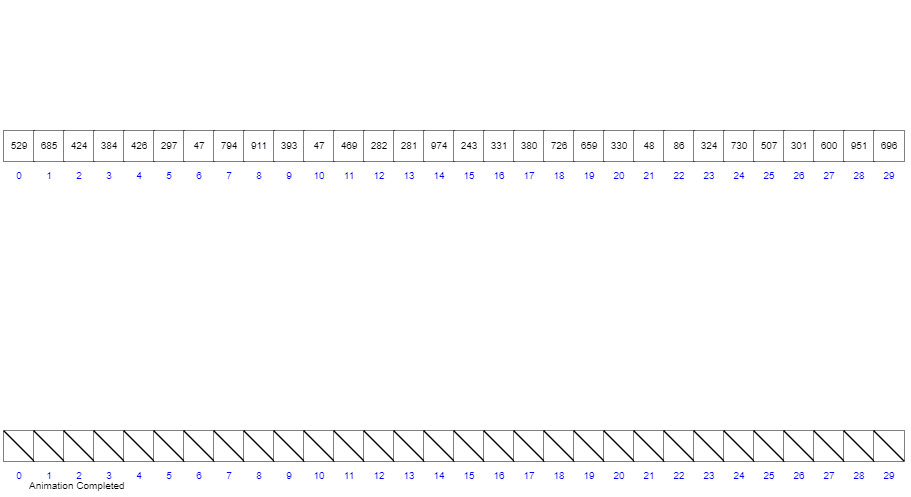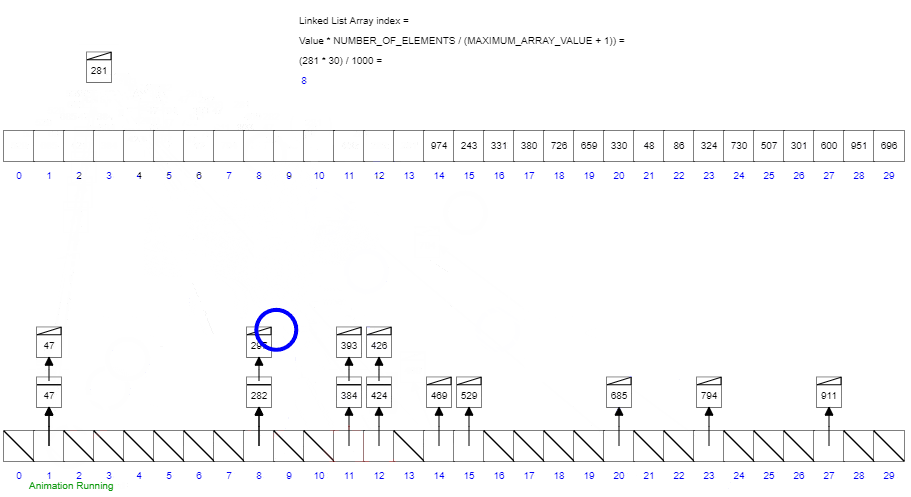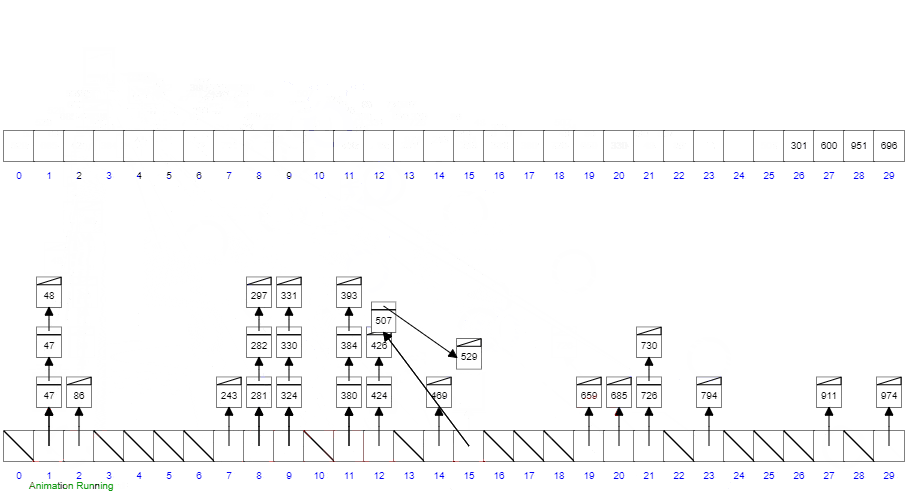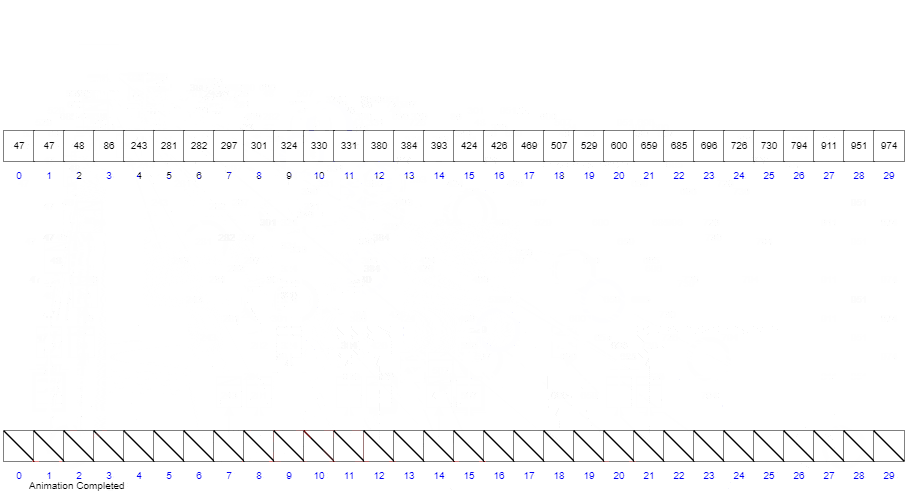
Nguyên lý hoạt động của sắp xếp bucket: giả sử dữ liệu đầu vào tuân theo phân bố đều, phân phối dữ liệu vào một số lượng bucket hữu hạn, sau đó sorting riêng từng bucket (có thể sử dụng algorithm sorting khác hoặc tiếp tục sử dụng sắp xếp bucket theo cách đệ quy).
Các bước thuật toán
- Thiết lập một BucketSize, biểu thị mỗi bucket có thể chứa bao nhiêu giá trị khác nhau;
- Duyệt dữ liệu đầu vào và lần lượt ánh xạ dữ liệu vào bucket tương ứng;
- Sorting từng bucket không rỗng, có thể dùng phương pháp sorting khác hoặc đệ quy dùng sắp xếp bucket;
- Nối dữ liệu đã sorting từ các bucket không rỗng.
Minh họa thuật toán
Triển khai code
/**
 * Lấy giá trị lớn nhất và nhỏ nhất trong array
 * @param arr
 * @return
 */
private static int[] getMinAndMax(List<Integer> arr) {
    int maxValue = arr.get(0);
    int minValue = arr.get(0);
    for (int i : arr) {
        if (i > maxValue) {
            maxValue = i;
        } else if (i < minValue) {
            minValue = i;
        }
    }
    return new int[] { minValue, maxValue };
}

/**
 * Sắp xếp bucket
 * @param arr
 * @return
 */
public static List<Integer> bucketSort(List<Integer> arr, int bucket_size) {
    if (bucket_size <= 0) {
        throw new IllegalArgumentException("bucket_size must be positive");
    }
    if (arr.size() < 2) {
        return arr;
    }
    int[] extremum = getMinAndMax(arr);
    int minValue = extremum[0];
    int maxValue = extremum[1];
    int bucket_cnt = (maxValue - minValue) / bucket_size + 1;
    List<List<Integer>> buckets = new ArrayList<>();
    for (int i = 0; i < bucket_cnt; i++) {
        buckets.add(new ArrayList<Integer>());
    }
    for (int element : arr) {
        int idx = (element - minValue) / bucket_size;
        buckets.get(idx).add(element);
    }
    for (int i = 0; i < buckets.size(); i++) {
        if (buckets.get(i).size() > 1) {
            buckets.get(i).sort(Integer::compareTo);
        }
    }
    ArrayList<Integer> result = new ArrayList<>();
    for (List<Integer> bucket : buckets) {
        for (int element : bucket) {
            result.add(element);
        }
    }
    return result;
}
Phân tích thuật toán
- Tính ổn định: phụ thuộc vào sorting trong bucket. Triển khai hiện tại đưa phần tử vào bucket theo thứ tự ban đầu và dùng
List.sortổn định, vì vậy là ổn định - Độ phức tạp thời gian: với triển khai hiện tại, tốt nhất là $O(n+k)$; khi dữ liệu phân bố đều, kỳ vọng gần $O(n+k)$; tệ nhất là $O(nlogn+k)$. Nếu đổi sang insertion sort trong bucket, trường hợp tệ nhất sẽ suy biến thành $O(n^2)$
- Độ phức tạp không gian: $O(n+k)$
Sắp xếp radix (Radix Sort)
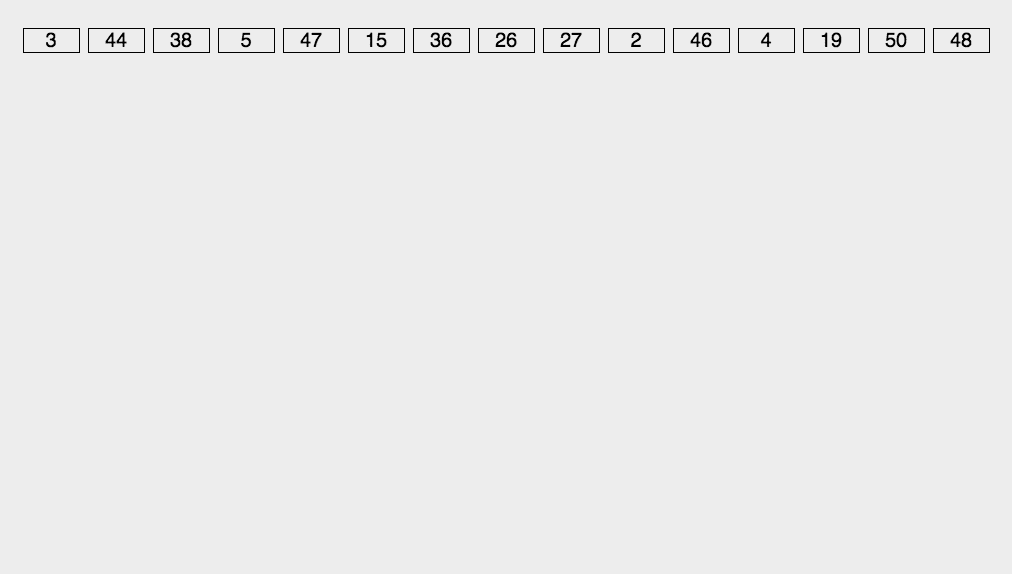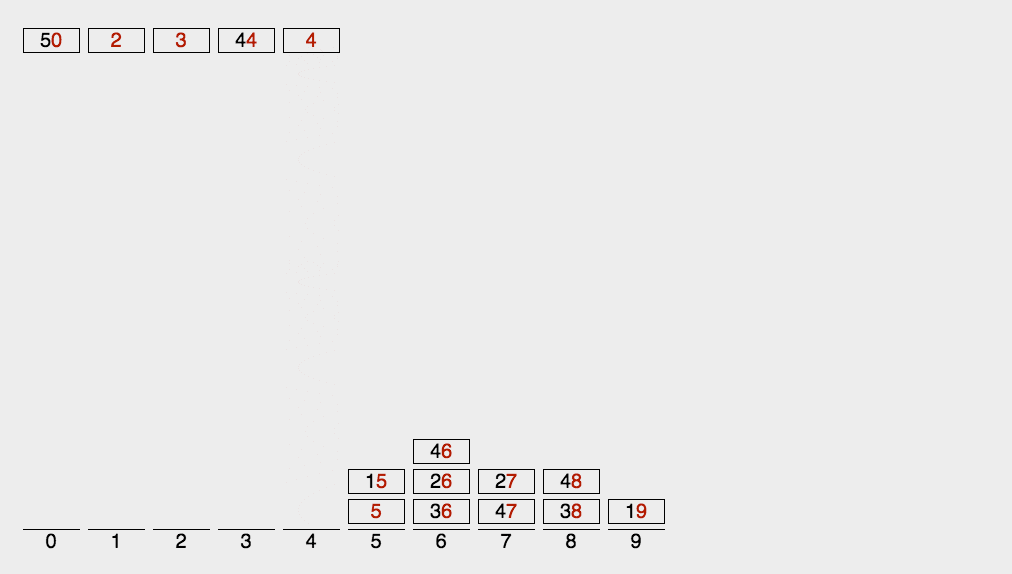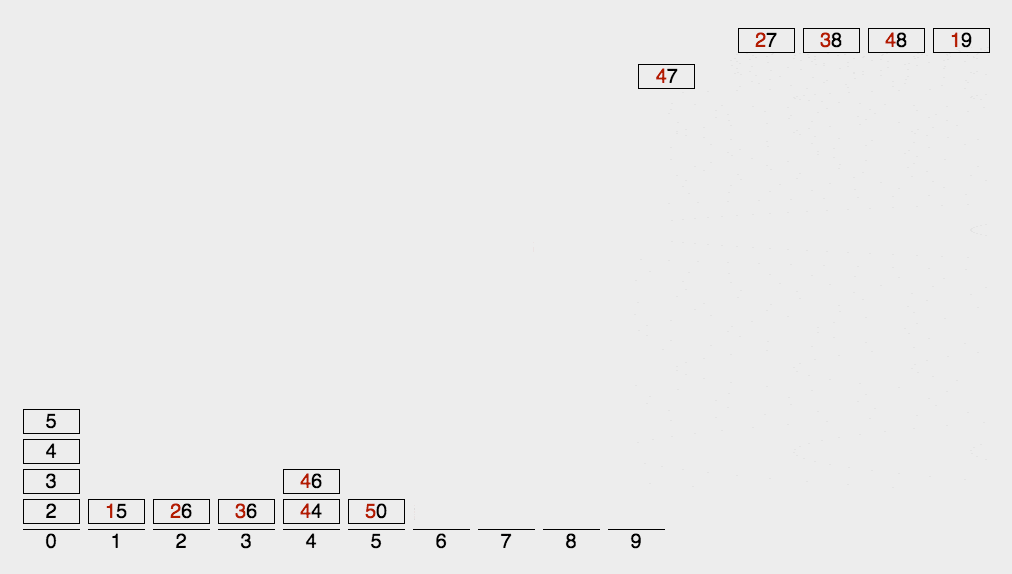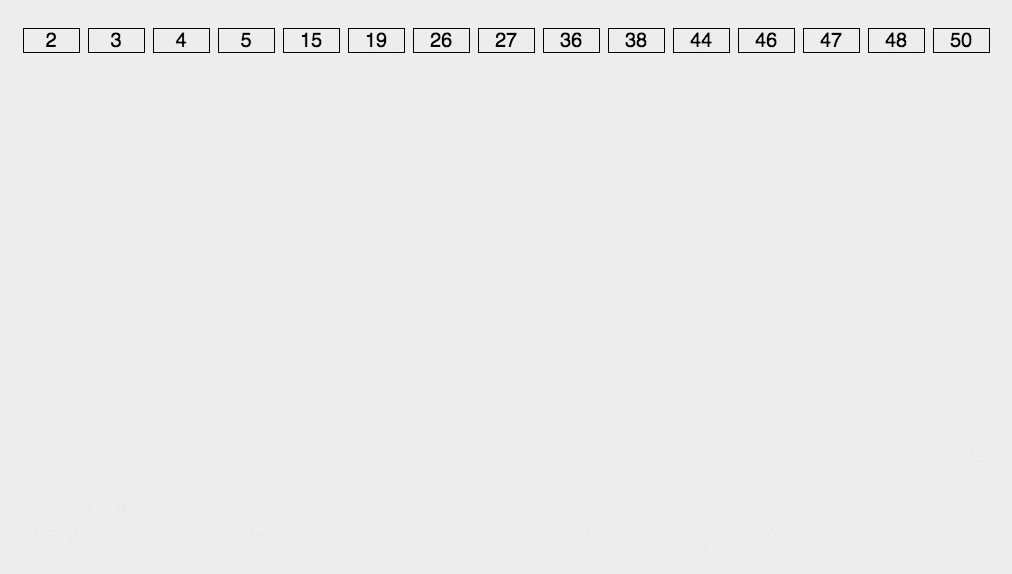
Sắp xếp radix cũng là một thuật toán sắp xếp không dựa trên so sánh, sorting từng chữ số của phần tử, bắt đầu từ chữ số thấp nhất. Gọi độ dài array là $n$, số chữ số lớn nhất là $d$, radix là $r$, độ phức tạp là $O(d(n+r))$. Triển khai LSD trong hệ thập phân dưới đây chỉ hỗ trợ số nguyên không âm.
Sắp xếp radix bắt đầu bằng việc sorting từ chữ số thấp rồi thu thập; sau đó sorting từ chữ số cao rồi thu thập; cứ tiếp tục như vậy cho đến chữ số cao nhất. Đôi khi một số thuộc tính có thứ tự ưu tiên: sorting trước theo ưu tiên thấp, sau đó theo ưu tiên cao. Thứ tự cuối cùng là thuộc tính có ưu tiên cao hơn nằm trước; nếu ưu tiên cao bằng nhau thì thuộc tính có ưu tiên thấp hơn nằm trước. Sắp xếp radix dựa trên việc sorting và thu thập riêng nên là sorting ổn định.
Các bước thuật toán
- Lấy số lớn nhất trong array và xác định số chữ số, đó là số lần lặp $N$ (ví dụ: nếu giá trị lớn nhất trong array là 1000 thì $N=4$);
Alà array gốc, bắt đầu từ chữ số thấp nhất, lấy từng chữ số tạo thành arrayradix;- Thực hiện sắp xếp đếm trên
radix(tận dụng đặc điểm sắp xếp đếm phù hợp với các số trong phạm vi nhỏ); - Lần lượt gán
radixvào array gốc; - Lặp lại bước 2~4 $N$ lần
Minh họa thuật toán
Triển khai code
/**
 * Sắp xếp radix
 *
 * @param arr
 * @return
 */
public static int[] radixSort(int[] arr) {
    if (arr.length < 2) {
        return arr;
    }
    for (int element : arr) {
        if (element < 0) {
            throw new IllegalArgumentException("radixSort only supports non-negative integers");
        }
    }
    int N = 1;
    int maxValue = arr[0];
    for (int element : arr) {
        if (element > maxValue) {
            maxValue = element;
        }
    }
    while (maxValue / 10 != 0) {
        maxValue = maxValue / 10;
        N += 1;
    }
    for (int i = 0; i < N; i++) {
        List<List<Integer>> radix = new ArrayList<>();
        for (int k = 0; k < 10; k++) {
            radix.add(new ArrayList<Integer>());
        }
        for (int element : arr) {
            int idx = (element / (int) Math.pow(10, i)) % 10;
            radix.get(idx).add(element);
        }
        int idx = 0;
        for (List<Integer> l : radix) {
            for (int n : l) {
                arr[idx++] = n;
            }
        }
    }
    return arr;
}
Phân tích thuật toán
- Tính ổn định: ổn định
- Độ phức tạp thời gian: tốt nhất, tệ nhất và trung bình đều là $O(d(n+r))$
- Độ phức tạp không gian: $O(n+r)$
Sắp xếp radix vs sắp xếp đếm vs sắp xếp bucket
Cả ba thuật toán sorting này đều tận dụng khái niệm bucket, nhưng cách sử dụng bucket có khác biệt rõ rệt:
- Sắp xếp radix: phân phối vào bucket dựa trên từng chữ số của key
- Sắp xếp đếm: mỗi bucket chỉ lưu một giá trị key duy nhất
- Sắp xếp bucket: mỗi bucket lưu các giá trị trong một phạm vi nhất định
Bài viết tham khảo
- Tổng hợp thuật toán sắp xếp (nguồn tham khảo chính của bài viết)
- https://en.wikipedia.org/wiki/Sorting_algorithm
- https://sort.hust.cc/
Trọng tâm ôn tập phỏng vấn
Phỏng vấn về thuật toán sorting thường không yêu cầu bạn tự viết cả 10 thuật toán, nhưng cần trình bày rõ độ phức tạp, tính ổn định, sorting in-place và trường hợp sử dụng.
| Thuật toán sắp xếp | Độ phức tạp thời gian trung bình | Độ phức tạp thời gian tệ nhất | Độ phức tạp không gian | Tính ổn định | In-place |
|---|---|---|---|---|---|
| Sắp xếp nổi bọt | O(n^2) | O(n^2) | O(1) | Ổn định | Có |
| Sắp xếp chọn | O(n^2) | O(n^2) | O(1) | Không ổn định | Có |
| Sắp xếp chèn | O(n^2) | O(n^2) | O(1) | Ổn định | Có |
| Sắp xếp trộn | O(nlogn) | O(nlogn) | O(n) | Ổn định | Không |
| Sắp xếp nhanh | O(nlogn) | O(n^2) | Trung bình O(logn), tệ nhất O(n) | Không ổn định | Có |
| Sắp xếp heap | O(nlogn) | O(nlogn) | O(1) | Không ổn định | Có |
| Sắp xếp đếm | O(n+k) | O(n+k) | O(n+k) | Ổn định | Không |
| Sắp xếp bucket | Liên quan đến phân bố dữ liệu | Phụ thuộc sorting trong bucket | O(n+k) | Phụ thuộc sorting trong bucket | Không |
| Sắp xếp radix | O(d(n+r)) | O(d(n+r)) | O(n+r) | Ổn định | Không |
Một số câu hỏi đào sâu thường gặp:
- Vì sao quick sort có trường hợp tệ nhất là
O(n^2)? Làm thế nào giảm xác suất suy biến? Có thể chọn pivot ngẫu nhiên hoặc lấy trung vị của ba số. - Vì sao merge sort ổn định? Vì khi merge, các phần tử bằng nhau có thể ưu tiên lấy phần tử bên trái.
- Vì sao heap sort không ổn định? Vì điều chỉnh và hoán đổi heap có thể làm xáo trộn thứ tự ban đầu của các phần tử bằng nhau.
- Khi nào insertion sort hoạt động tốt? Khi array gần như đã có thứ tự và quy mô không lớn.
- Vì sao counting sort, bucket sort và radix sort không phải sorting tổng quát? Vì chúng phụ thuộc vào phạm vi, phân bố hoặc số chữ số của dữ liệu.
Java code template
Trong phỏng vấn sorting, quick sort và merge sort là hai thuật toán thường phải tự viết nhất. Với quick sort cần đặc biệt chú ý đến biên phân vùng. Dưới đây là một cách viết thường gặp:
void quickSort(int[] nums, int left, int right) {
    if (left >= right) {
        return;
    }
    int pivotIndex = partition(nums, left, right);
    quickSort(nums, left, pivotIndex - 1);
    quickSort(nums, pivotIndex + 1, right);
}

int partition(int[] nums, int left, int right) {
    int pivot = nums[right];
    int less = left;
    for (int i = left; i < right; i++) {
        if (nums[i] <= pivot) {
            swap(nums, less, i);
            less++;
        }
    }
    swap(nums, less, right);
    return less;
}

void swap(int[] nums, int i, int j) {
    int temp = nums[i];
    nums[i] = nums[j];
    nums[j] = temp;
}
Nếu lo array đã có thứ tự khiến quick sort suy biến, có thể chọn pivot ngẫu nhiên trước khi phân vùng và hoán đổi nó đến vị trí right.
int randomIndex = left + new Random().nextInt(right - left + 1);
swap(nums, randomIndex, right);
Sơ đồ quy trình và ví dụ biên
Một lần phân vùng của quick sort có thể được hiểu như sau:
Khoảng của array gốc: [left ... right]
pivot: chọn nums[right]
less: trỏ đến vị trí tiếp theo của “vùng nhỏ hơn hoặc bằng pivot”
i: quét từ left đến right - 1

Sau khi quét xong:
[left ... less - 1] <= pivot
[less ... right - 1] > pivot
Hoán đổi pivot đến less, rồi đệ quy sắp xếp riêng hai phía trái và phải của pivot
Một số ví dụ biên nên tự kiểm tra trước khi viết code:
- Array rỗng hoặc chỉ có một phần tử: trả về trực tiếp.
- Đã có thứ tự hoặc ngược thứ tự: cố định chọn phần tử đầu/cuối làm pivot dễ bị suy biến.
- Nhiều phần tử trùng lặp: phân vùng hai ngả thông thường có thể chưa tối ưu, có thể tìm hiểu quick sort ba ngả.
- Khi người phỏng vấn hỏi về tính ổn định, không được nói quick sort ổn định; quick sort thông thường sẽ làm xáo trộn thứ tự các phần tử bằng nhau khi hoán đổi.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.