
Tổng hợp câu hỏi phỏng vấn MongoDB thường gặp (phần dưới)
Index MongoDB
Index MongoDB có tác dụng gì?
Tương tự database quan hệ, MongoDB cũng có index. Mục đích chính của index là nâng cao hiệu quả truy vấn. Nếu không có index, MongoDB phải thực hiện collection scan, tức là quét từng document trong collection để chọn các document khớp với câu truy vấn. Nếu truy vấn có index phù hợp, MongoDB có thể dùng index đó để giới hạn số document phải kiểm tra. Ngoài ra, MongoDB có thể dùng thứ tự sắp xếp trong index để trả về kết quả đã được sắp xếp.
Mặc dù index có thể rút ngắn đáng kể thời gian truy vấn, việc sử dụng và duy trì index cũng có chi phí. Khi thực hiện thao tác ghi, ngoài việc cập nhật document, còn phải cập nhật index, điều này chắc chắn ảnh hưởng đến performance ghi. Vì vậy, khi có nhiều thao tác ghi nhưng ít thao tác đọc, hoặc không quan tâm đến performance đọc, không nên tạo index.
MongoDB hỗ trợ những loại index nào?
MongoDB hỗ trợ nhiều loại index, gồm single-field index, compound index, multikey index, hashed index, text index, geospatial index và các loại khác. Mỗi loại index phù hợp với những trường hợp sử dụng khác nhau.
- Single-field index: Index được tạo trên một field. Thứ tự sắp xếp khi tạo index không quan trọng, MongoDB có thể duyệt từ đầu hoặc cuối.
- Compound index: Index được tạo trên nhiều field, còn gọi là combination index hoặc compound index.
- Multikey index: Một field của MongoDB có thể là array. Khi tạo index trên field này, đó là multikey index. MongoDB tạo index cho từng giá trị trong array. Nghĩa là bạn có thể truy vấn theo giá trị trong array, và index vẫn được sử dụng.
- Hashed index: Index theo giá trị hash của dữ liệu, được dùng trên sharded cluster.
- Text index: Hỗ trợ truy vấn text search trên nội dung string. Text index có thể bao gồm các field có giá trị là string hoặc array chứa các phần tử string. Một collection chỉ có thể có một text search index, nhưng index đó có thể bao phủ nhiều field. MongoDB hỗ trợ full-text index, nhưng performance thấp nên hiện chưa khuyến nghị sử dụng.
- Geospatial index: Index dựa trên kinh độ và vĩ độ, phù hợp với truy vấn vị trí 2D và 3D.
- Unique index: Đảm bảo field được index không lưu các giá trị trùng lặp. Nếu collection đã có document vi phạm ràng buộc unique của index, việc tạo unique index ở background sẽ thất bại.
- TTL index: TTL index cung cấp cơ chế hết hạn, cho phép đặt thời gian hết hạn cho từng document. Khi document đạt thời gian hết hạn đã thiết lập, document sẽ bị xóa.
- …
Thứ tự field trong compound index có ảnh hưởng không?
Thứ tự field trong compound index rất quan trọng. Ví dụ, compound index trong hình dưới được tạo từ {userid:1, score:-1}, nên trước tiên compound index sắp xếp tăng dần theo userid; sau đó trong từng giá trị userid, sắp xếp giảm dần theo score.
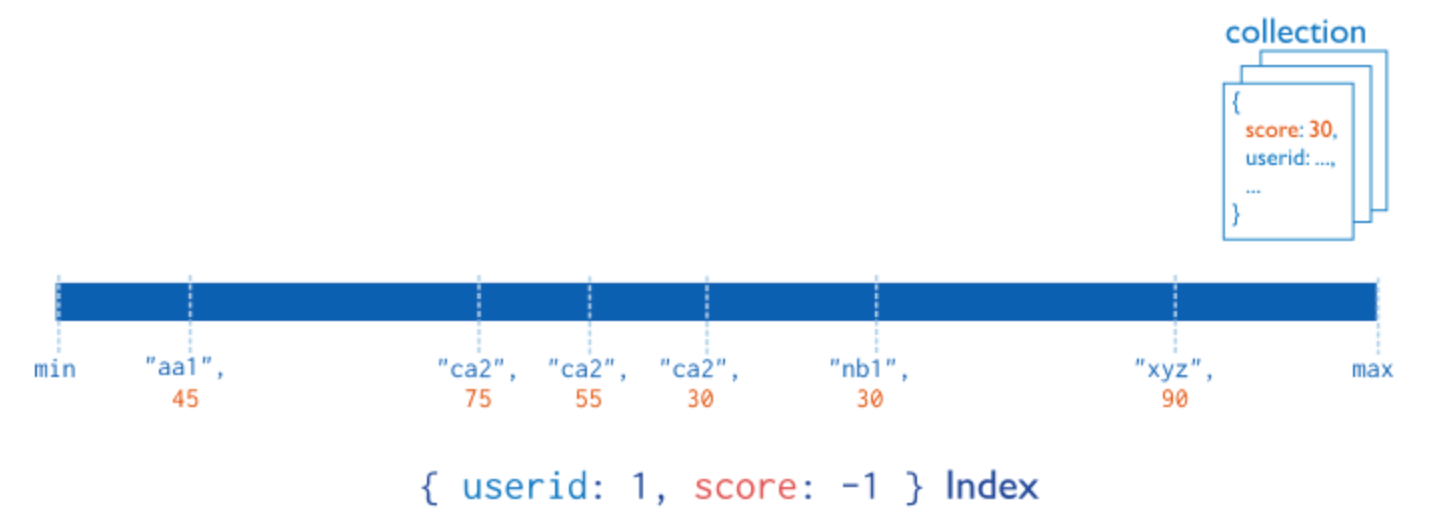
Cách sắp xếp trong compound index quyết định index đó có được áp dụng trong truy vấn hay không.
Sort sử dụng compound index:
db.s2.find().sort({"userid": 1, "score": -1})
db.s2.find().sort({"userid": -1, "score": 1})
Sort không sử dụng compound index:
db.s2.find().sort({"userid": 1, "score": 1})
db.s2.find().sort({"userid": -1, "score": -1})
db.s2.find().sort({"score": 1, "userid": -1})
db.s2.find().sort({"score": 1, "userid": 1})
db.s2.find().sort({"score": -1, "userid": -1})
db.s2.find().sort({"score": -1, "userid": 1})
Có thể dùng explain để phân tích:
db.s2.find().sort({"score": -1, "userid": 1}).explain()Compound index có tuân theo nguyên tắc leftmost prefix không?
Compound index của MongoDB tuân theo nguyên tắc leftmost prefix: Index có nhiều key đồng thời cung cấp các index được tạo bởi mọi prefix của các key đó, nhưng không cung cấp các subset không bắt đầu từ leftmost prefix. Ví dụ, nếu có index dạng {a: 1, b: 1, c: 1, ..., z: 1}, thì trên thực tế cũng có {a: 1}, {a: 1, b: 1}, {a: 1, b: 1, c: 1} và một loạt index tương tự, nhưng không có index không bắt đầu từ leftmost prefix như {b: 1}.
TTL index là gì?
TTL index cung cấp cơ chế hết hạn, cho phép đặt thời gian hết hạn cho từng document bằng expireAfterSeconds. Khi document đạt thời gian hết hạn đã thiết lập, document sẽ bị xóa. Ngoài thuộc tính expireAfterSeconds, TTL index giống index thông thường.
Việc làm hết hạn dữ liệu hữu ích với một số loại thông tin, chẳng hạn dữ liệu event do máy tạo, log và thông tin session. Những thông tin này chỉ cần được lưu trong database trong một khoảng thời gian giới hạn.
Nguyên lý hoạt động của TTL index:
- MongoDB khởi chạy một background thread để đọc giá trị của TTL index và xác định document đã hết hạn hay chưa, nhưng không đảm bảo dữ liệu hết hạn được xóa ngay lập tức. Background thread kích hoạt task xóa mỗi 60 giây. Nếu lượng dữ liệu cần xóa lớn, lần xóa trước có thể chưa hoàn tất nhưng task tiếp theo đã bắt đầu, khiến dữ liệu hết hạn có thể tồn tại quá thời gian lưu trữ hơn 60 giây.
- Với replica set, background process của TTL index chỉ chạy trên node Primary và luôn ở trạng thái idle trên các node Secondary. Việc xóa dữ liệu trên Secondary được đồng bộ qua oplog do node Primary tạo ra sau khi xóa.
Giới hạn của TTL index:
- TTL index là single-field index. Compound index không hỗ trợ TTL.
- Field
_idkhông hỗ trợ TTL index. - Không thể tạo TTL index trên Capped Collection, vì MongoDB không thể xóa document khỏi Capped Collection.
- Nếu một field đã có non-TTL index, không thể tạo thêm TTL index trên field đó.
Covered query là gì?
Theo tài liệu chính thức, covered query là query thỏa mãn các điều kiện sau:
- Tất cả field được truy vấn đều là một phần của index.
- Tất cả field được trả về trong kết quả đều nằm trong cùng index đó.
- Không có field nào trong query có giá trị bằng
null.
Vì tất cả field xuất hiện trong query đều là một phần của index, MongoDB không cần tìm trong toàn bộ document để kiểm tra điều kiện truy vấn và trả về kết quả bằng chính index đó. Vì index nằm trong memory, lấy dữ liệu từ index nhanh hơn nhiều so với đọc dữ liệu bằng cách quét document.
Ví dụ, chúng ta có collection users như sau:
{
   "_id": ObjectId("53402597d852426020000002"),
   "contact": "987654321",
   "dob": "01-01-1991",
   "gender": "M",
   "name": "Tom Benzamin",
   "user_name": "tombenzamin"
}
Tạo compound index trong collection users với các field gender và user_name:
db.users.ensureIndex({gender:1,user_name:1})Index này sẽ bao phủ query sau:
db.users.find({gender:"M"},{user_name:1,_id:0})Để query được bao phủ bởi index đã chỉ định, phải chỉ rõ _id: 0 để loại field _id khỏi kết quả, vì index không bao gồm _id.
High availability của MongoDB
Replica set
Replica set là gì?
Replica set của MongoDB, còn gọi là replication cluster, là một nhóm các process mongod duy trì cùng một collection dữ liệu.
Client kết nối đến toàn bộ MongoDB replication cluster. Node Primary chịu trách nhiệm ghi cho toàn bộ cluster, node Secondary có thể thực hiện thao tác đọc, nhưng mặc định Primary vẫn chịu trách nhiệm đọc cho toàn bộ cluster. Khi Primary gặp sự cố, một Primary mới sẽ tự động được bầu từ các Secondary, đảm bảo cluster tiếp tục hoạt động bình thường mà client không nhận biết được.
Thông thường, một replica set gồm 1 Primary, nhiều Secondary và 0 hoặc 1 Arbiter.
- Primary: Cổng vào của mọi thao tác ghi trong cluster, nhận tất cả thao tác ghi và ghi lại mọi thay đổi của collection vào operation log, tức oplog. Khi Primary dừng hoạt động, một Primary mới sẽ được tự động bầu.
- Secondary: Đồng bộ dữ liệu từ Primary và bầu node mới khi Primary dừng hoạt động. Tuy nhiên, Secondary có thể được cấu hình priority bằng 0 để ngăn node này trở thành Primary trong quá trình election.
- Arbiter: Được dùng để tiết kiệm tài nguyên hoặc phục vụ disaster recovery giữa nhiều data center. Arbiter chỉ bỏ phiếu trong quá trình bầu Primary và không lưu dữ liệu, đảm bảo có node nhận được đa số phiếu thuận.
Hình dưới là một replica set ba member điển hình:
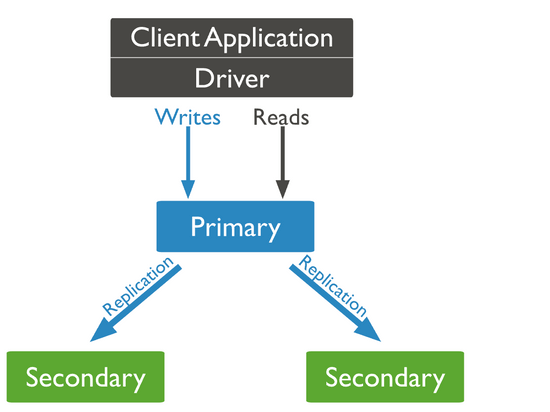
Primary và Secondary đồng bộ dữ liệu thông qua oplog (operation log). Oplog là một Capped Collection đặc biệt trong database local, dùng để lưu incremental log do thao tác ghi tạo ra, tương tự Binlog của MySQL.
Capped Collection tương tự một circular queue có độ dài cố định. Dữ liệu được nối tuần tự vào cuối collection; khi dung lượng collection đạt giới hạn, nó sẽ ghi đè document cũ nhất trong collection. Dữ liệu của Capped Collection được ghi tuần tự vào vùng cố định trên disk, nên tốc độ I/O rất nhanh; nếu không tạo index thì performance còn tốt hơn.
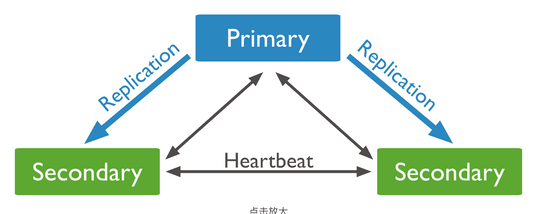
Sau khi thao tác ghi trên Primary hoàn tất, một log tương ứng được ghi vào collection oplog. Secondary liên tục lấy log mới thông qua oplog này và replay tại local để đồng bộ dữ liệu.
Một replica set có tối đa một Primary. Nếu Primary hiện tại không khả dụng, một election sẽ chọn ra Primary mới. Quy tắc election của MongoDB đảm bảo node mới được chọn sau khi Primary dừng hoạt động luôn là node có dữ liệu đầy đủ nhất trong cluster.
Vì sao nên dùng replica set?
- Thực hiện failover: Cung cấp khả năng tự động khôi phục sau sự cố. Khi Primary gặp sự cố, một Primary mới được tự động bầu từ các Secondary, đảm bảo cluster tiếp tục hoạt động bình thường mà client không nhận biết được.
- Thực hiện read/write separation: Có thể cấu hình cho phép đọc dữ liệu trên Secondary và ghi dữ liệu trên Primary, từ đó thực hiện read/write separation, giảm áp lực đọc và ghi quá lớn trên Primary. Với các phiên bản trước MongoDB 4.0, nếu Primary không chịu áp lực lớn thì không khuyến nghị read/write separation, vì ghi sẽ block đọc, trừ khi business không quá quan tâm đến response time và chấp nhận độ trễ nhất định khi đọc dữ liệu lịch sử.
Sharded cluster
Sharded cluster là gì?
Sharded cluster là phiên bản distributed của MongoDB. So với replica set, dữ liệu trong sharded cluster được phân phối cân bằng trên các shard khác nhau, không chỉ nâng cao đáng kể giới hạn dung lượng dữ liệu của toàn cluster mà còn phân tán áp lực đọc và ghi sang các shard khác nhau, giải quyết bottleneck performance của replica set.
Sharded cluster của MongoDB gồm ba thành phần sau (hình dưới lấy từ tài liệu chính thức giới thiệu về sharded cluster):
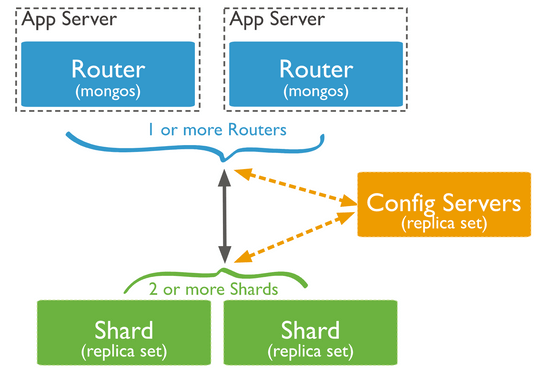
- Config Servers: Config server về bản chất là một replica set của MongoDB, chịu trách nhiệm lưu metadata và config khác nhau của cluster, chẳng hạn địa chỉ shard, Chunk...
- Mongos: Routing service, không lưu dữ liệu cụ thể. Mongos lấy config cluster từ Config Servers, chuyển tiếp request đến shard tương ứng, đồng thời tổng hợp kết quả từ các shard và trả về client.
- Shard: Mỗi shard là một subset của toàn bộ dữ liệu. Từ MongoDB 3.6, mỗi Shard phải được triển khai theo kiến trúc replica set.
Vì sao nên dùng sharded cluster?
Khi data volume và throughput của hệ thống tăng lên, có hai cách xử lý phổ biến: vertical scaling và horizontal scaling.
Vertical scaling được thực hiện bằng cách tăng năng lực của một server, chẳng hạn disk space, memory capacity, số lượng CPU; horizontal scaling được thực hiện bằng cách lưu dữ liệu trên nhiều server và thêm server tùy theo nhu cầu để tăng capacity.
Tương tự Redis Cluster, MongoDB cũng có thể thực hiện horizontal scaling bằng sharding. Horizontal scaling linh hoạt hơn, có thể đáp ứng nhu cầu lưu trữ data volume lớn hơn và hỗ trợ throughput cao hơn. Ngoài ra, tổng chi phí cần thiết cho horizontal scaling thấp hơn, chỉ cần các server đơn có cấu hình tương đối thấp; đổi lại là tăng độ phức tạp của infrastructure và maintenance.
Nói cách khác, có thể dùng sharded cluster để giải quyết các vấn đề sau:
- Storage capacity bị giới hạn bởi một server, tức tài nguyên disk gặp bottleneck.
- Read/write capacity bị giới hạn bởi một server. CPU, memory hoặc network card có thể gặp bottleneck, khiến read/write capacity không thể scale.
Shard key là gì?
Shard key là tiền đề của data partitioning, từ đó phân phối dữ liệu đến các server khác nhau và giảm tải cho server. Nói cách khác, shard key quyết định document trong collection được phân phối như thế nào giữa nhiều shard của cluster.
Shard key là một field trong document, nhưng không phải field thông thường mà có một số yêu cầu:
- Phải xuất hiện trong tất cả document.
- Phải là một index của collection, có thể là single index hoặc prefix index của compound index, không thể là multikey index, text index hoặc geospatial index.
- Trước MongoDB 4.2, giá trị của field shard key trong document không thể thay đổi. Từ MongoDB 4.2, có thể cập nhật giá trị shard key của document, trừ khi field shard key là field
_idimmutable. Từ MongoDB 5.0, MongoDB hỗ trợ live resharding, cho phép chọn lại hoàn toàn shard key. - Kích thước không được vượt quá 512 byte.
Chọn shard key như thế nào?
Chọn shard key phù hợp ảnh hưởng rất lớn đến hiệu quả sharding, chủ yếu dựa trên bốn yếu tố sau (trích từ Lưu ý khi sử dụng sharded cluster - tài liệu Tencent Cloud):
- Cardinality: Cardinality nên lớn nhất có thể. Nếu dùng shard key có cardinality nhỏ, số giá trị thay thế có giới hạn nên tổng số chunk cũng có giới hạn. Khi dữ liệu tăng, kích thước chunk ngày càng lớn, khiến việc di chuyển chunk khi horizontal scaling trở nên rất khó khăn. Ví dụ, nếu chọn tuổi làm cardinality thì phạm vi tối đa chỉ có 100 giá trị. Khi data volume tăng, quá nhiều dữ liệu có cùng một giá trị khiến chunk tăng vượt phạm vi
chunksize, tạo ra jumbo chunk, không thể migrate, dẫn đến dữ liệu phân bố không đều và xuất hiện performance bottleneck. - Phân bố giá trị: Phân bố giá trị nên càng đồng đều càng tốt. Shard key phân bố không đều khiến một số chunk có data volume rất lớn, cũng gây ra vấn đề dữ liệu phân bố không đều và performance bottleneck như trên.
- Query có shard key: Nên thêm shard key khi query. Khi query điều kiện bằng shard key, mongos có thể định vị trực tiếp shard cụ thể; nếu không, mongos phải phân phối query đến tất cả shard rồi chờ response trả về.
- Tránh tăng hoặc giảm đơn điệu: Với sharding key tăng đơn điệu, việc di chuyển data file ít hơn nhưng thao tác ghi sẽ tập trung, khiến chunk cuối cùng liên tục tăng kích thước và liên tục phải migrate; trường hợp giảm đơn điệu cũng tương tự.
Tóm lại, khi chọn shard key cần cân nhắc bốn điều kiện trên, cố gắng đáp ứng càng nhiều điều kiện càng tốt để giảm ảnh hưởng của MoveChunks đến performance và đạt performance tối ưu.
Có những chiến lược sharding nào?
MongoDB hỗ trợ hai thuật toán sharding để đáp ứng các nhu cầu query khác nhau (trích từ Giới thiệu sharded cluster MongoDB - tài liệu Alibaba Cloud):
1. Range-based sharding:
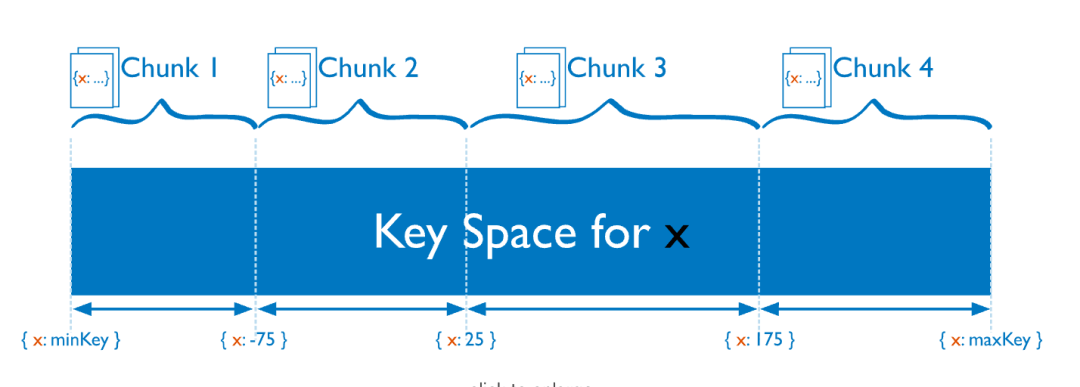
MongoDB chia dữ liệu thành các chunk khác nhau theo range của giá trị shard key. Mỗi chunk chứa dữ liệu trong một range. Khi shard key có cardinality lớn, frequency thấp và giá trị không thay đổi đơn điệu, range-based sharding sẽ hiệu quả hơn.
- Ưu điểm: Mongos có thể nhanh chóng định vị dữ liệu request cần và chuyển request đến Shard tương ứng.
- Nhược điểm: Có thể khiến dữ liệu phân bố không cân bằng trên các Shard, dễ tạo read/write hotspot và không có khả năng phân tán ghi.
- Trường hợp sử dụng: Giá trị shard key không tăng hoặc giảm đơn điệu, shard key có cardinality lớn và tần suất trùng lặp thấp, cần range query và các business scenario tương tự.
2. Hash-based sharding:
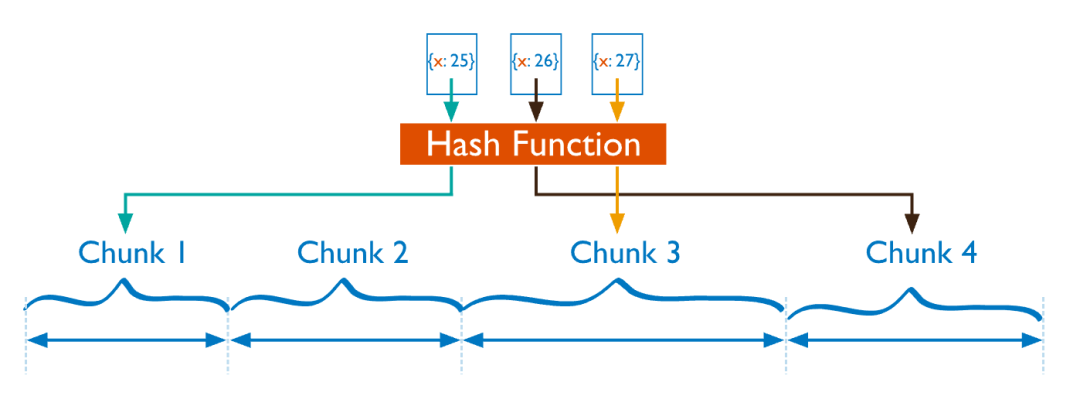
MongoDB tính hash của một field làm giá trị index, sau đó chia dữ liệu thành các chunk khác nhau theo range của giá trị hash.
- Ưu điểm: Có thể phân phối dữ liệu cân bằng hơn giữa các Shard, có khả năng phân tán ghi.
- Nhược điểm: Không phù hợp với range query. Khi thực hiện range query, phải phân phối read request đến tất cả Shard.
- Trường hợp sử dụng: Giá trị shard key tăng hoặc giảm đơn điệu, shard key có cardinality lớn và tần suất trùng lặp thấp, cần phân phối ngẫu nhiên dữ liệu ghi, dữ liệu đọc có tính ngẫu nhiên cao và các business scenario tương tự.
Ngoài hai chiến lược sharding trên, cũng có thể cấu hình compound shard key, chẳng hạn gồm một key có cardinality thấp và một key tăng đơn điệu.
Dữ liệu shard được lưu trữ như thế nào?
Chunk là một khái niệm cốt lõi của MongoDB sharded cluster. Về bản chất, Chunk là một data unit logic gồm một nhóm Document. Mỗi Chunk chứa dữ liệu của một range shard key nhất định; các range không giao nhau và hợp của chúng là toàn bộ dữ liệu, tức khái niệm partition trong toán học rời rạc.
Sharded cluster không ghi lại từng dữ liệu nằm trên shard nào, mà ghi lại Chunk nằm trên shard nào và Chunk đó chứa dữ liệu nào.
Theo mặc định, giá trị tối đa của một Chunk là 64MB (có thể điều chỉnh, phạm vi từ 1 đến 1024 MB. Nếu không có nhu cầu đặc biệt, nên giữ giá trị mặc định). Khi insert, update hoặc delete dữ liệu, nếu Mongos nhận biết kích thước của Chunk đích hoặc data volume trong đó vượt quá giới hạn, Chunk splitting sẽ được kích hoạt.
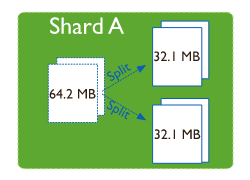
Dữ liệu tăng sẽ khiến số Chunk được split ngày càng nhiều. Khi đó, số lượng Chunk trên mỗi shard có thể mất cân bằng. Component Balancer trong Mongos sẽ tự động cân bằng, cố gắng giữ số lượng Chunk trên mỗi Shard cân bằng. Quá trình này gọi là Rebalance. Theo mặc định, Rebalance của database và collection được bật.
Như hình dưới, khi dữ liệu được insert, Chunk bị split khiến hai shard A và B có 3 Chunk còn shard C chỉ có một. Khi đó, một Chunk được phân bổ cho B sẽ được migrate sang shard C để cân bằng dữ liệu trong cluster.
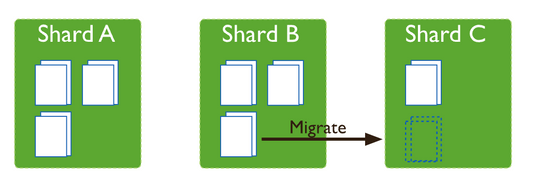
Balancer là một background process của MongoDB chạy trên node Primary của Config Server (từ MongoDB 3.4). Balancer giám sát số lượng Chunk trên mỗi shard và migrate khi số lượng Chunk trên một shard đạt ngưỡng.
Chunk chỉ được split, không được merge, kể cả khi giá trị chunkSize tăng.
Thao tác Rebalance tiêu tốn khá nhiều system resource. Có thể giảm ảnh hưởng đến việc sử dụng MongoDB bình thường bằng cách thực hiện vào business low-traffic period, pre-sharding hoặc thiết lập time window cho Rebalance.
Nguyên lý Chunk migration là gì?
Để tìm hiểu chi tiết về nguyên lý Chunk migration, nên đọc bài viết Đọc hiểu Chunk migration trong MongoDB của MongoDB Chinese Community.
Tài liệu học tập đề xuất
- MongoDB Manual tiếng Việt | tài liệu chính thức (khuyến nghị): Dựa trên version 4.2 và liên tục đồng bộ với version mới nhất của tài liệu chính thức.
- Tutorial MongoDB cho người mới bắt đầu - học MongoDB trong 7 ngày: Nhập môn nhanh.
- Thực hành tích hợp SpringBoot với MongoDB - 2022: Một bài viết nhập môn MongoDB khá tốt, chủ yếu giới thiệu các thao tác CRUD cơ bản bằng Java client của MongoDB.
Tham khảo
- Tài liệu chính thức MongoDB (tài liệu tham khảo chính, lấy tài liệu chính thức làm chuẩn): https://www.mongodb.com/docs/manual/
- 《MongoDB Definitive Guide》
- Indexes - tài liệu chính thức MongoDB: https://www.mongodb.com/docs/manual/indexes/
- MongoDB - kiến thức về index - Lập trình viên Xiangzai - 2022: https://fatedeity.cn/posts/database/mongodb-index-knowledge.html
- MongoDB - Index: https://www.cnblogs.com/Neeo/articles/14325130.html
- Sharding - tài liệu chính thức MongoDB: https://www.mongodb.com/docs/manual/sharding/
- Giới thiệu sharded cluster MongoDB - tài liệu Alibaba Cloud: https://help.aliyun.com/document_detail/64561.html
- Lưu ý khi sử dụng sharded cluster - tài liệu Tencent Cloud: https://cloud.tencent.com/document/product/240/44611
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.