
Best practices về Java thread pool
Khi thấy cấu hình corePoolSize = 8, maximumPoolSize = 16, queueCapacity = 1000, chỉ dựa vào việc máy có 8 CPU core thì vẫn chưa thể đánh giá cấu hình đó có phù hợp hay không. Thời gian xử lý của việc nén ảnh, truy vấn database hàng loạt và gọi external interface có đặc điểm khác nhau, nên số thread cần thiết có thể chênh lệch rất lớn. Tốc độ task đi vào, thời gian thực thi, thời gian cho phép xếp hàng, cùng số request đồng thời mà database và downstream có thể tiếp nhận đều ảnh hưởng đến cấu hình cuối cùng.
Kiến thức cơ bản về bảy tham số, flow thực thi task, blocking queue và rejection policy có thể xem trước tại Giải thích chi tiết về Java thread pool. Trong môi trường production còn phải xử lý việc ước tính tham số, quá tải, timeout task và monitoring; những vấn đề này phụ thuộc nhiều hơn vào khả năng chịu tải của nghiệp vụ và dữ liệu runtime.
Khai báo thread pool đúng cách
Thread pool cho nghiệp vụ thường cần chỉ định rõ số thread, capacity của queue, tên thread và rejection policy. Các phương thức tiện lợi của Executors tuy dễ dùng, nhưng một số phương thức sẽ tạo queue gần như không giới hạn hoặc cho phép số thread tăng liên tục; trong giờ cao điểm, hệ thống dễ tích tụ nhiều task hoặc tạo quá nhiều thread.
newFixedThreadPool()vànewSingleThreadExecutor()sử dụngLinkedBlockingQueuekhông giới hạn; khi task liên tục đi vào, queue có thể không ngừng tăng.newCachedThreadPool()sử dụngSynchronousQueue, số thread tối đa làInteger.MAX_VALUE; khi tốc độ submit cao hơn tốc độ xử lý trong thời gian dài, nó có thể tạo ra rất nhiều thread.newScheduledThreadPool()sử dụngDelayedWorkQueuekhông giới hạn; tương tự, cần cân nhắc vấn đề delayed task liên tục tích tụ.
Vì vậy, thread pool cho nghiệp vụ thông thường phù hợp hơn khi sử dụng trực tiếp ThreadPoolExecutor và đặt giới hạn capacity ngay trong cấu hình:
ThreadFactory threadFactory = new NamingThreadFactory("order-query");

ThreadPoolExecutor executor = new ThreadPoolExecutor(
        8,
        16,
        60L,
        TimeUnit.SECONDS,
        new ArrayBlockingQueue<>(200),
        threadFactory,
        new ThreadPoolExecutor.AbortPolicy()
);
Các giá trị 8, 16 và 200 trong ví dụ chỉ dùng để minh họa vị trí của tham số, không thể dùng trực tiếp trong môi trường production. Tham số phải được xác định dựa trên capacity nghiệp vụ và kết quả load test.
Thread factory ít nhất nên đặt tên thread có ý nghĩa với nghiệp vụ:
import java.util.concurrent.ThreadFactory;
import java.util.concurrent.atomic.AtomicInteger;

public final class NamingThreadFactory implements ThreadFactory {

    private final AtomicInteger sequence = new AtomicInteger();
    private final String prefix;

    public NamingThreadFactory(String prefix) {
        this.prefix = prefix;
    }

    @Override
    public Thread newThread(Runnable task) {
        Thread thread = new Thread(task);
        thread.setName(prefix + "-" + sequence.incrementAndGet());
        thread.setDaemon(false);
        return thread;
    }
}
Tên thread sẽ xuất hiện trong thread dump, log và dữ liệu monitoring. pool-1-thread-3 rất khó xác định thuộc nghiệp vụ nào, còn order-query-3 có thể trực tiếp thu hẹp phạm vi điều tra.
Ước tính tham số thread pool như thế nào?
Task thiên về CPU thường bắt đầu với số thread gần bằng số CPU core, còn task thiên về I/O có thể cấu hình nhiều thread hơn. Kinh nghiệm này phù hợp để phán đoán ban đầu, nhưng cấu hình thực tế còn phải trả lời các câu hỏi cụ thể hơn: trong giờ cao điểm mỗi giây sẽ submit bao nhiêu task? Một task chạy trong bao lâu? Trong đó có bao nhiêu thời gian chờ I/O? Downstream có thể tiếp nhận bao nhiêu request đồng thời? Task được phép xếp hàng tối đa bao lâu?
Trong một khoảng cao điểm tương đối ổn định, giả sử số task submit mỗi giây là $\lambda$, thời gian thực thi trung bình của task là $T$ giây, số task đang thực thi $L$ có thể ước tính sơ bộ như sau:
$$
L \approx \lambda \times T
$$
Ví dụ, một interface trong giờ cao điểm tạo ra 400 async task mỗi giây, mỗi task thực thi trung bình 80 ms, nhu cầu concurrency trung bình tương ứng khoảng 400 × 0.08 = 32. Đây chỉ là điểm bắt đầu để ước tính, không thể dựa vào đó để đặt số thread là 32, vì:
- Thời gian trung bình sẽ che khuất slow task; P95, P99 có thể cao hơn nhiều so với trung bình.
- Khi thời gian xử lý task tăng, nhu cầu concurrency cũng tăng theo.
- CPU, memory và context switch sẽ giới hạn số platform thread.
- Database connection pool hoặc downstream interface có thể chỉ cho phép concurrency thấp hơn.
《Java Concurrency in Practice》 từng đưa ra công thức ước tính có tính đến target CPU utilization. Với task kết hợp giữa tính toán và chờ, có thể dùng công thức này để hỗ trợ xác định giá trị ban đầu:
$$
N_{threads} \approx N_{cpu} \times U_{cpu} \times \left(1 + \frac{W}{C}\right)
$$
Trong đó, $N_{cpu}$ là số CPU core, $U_{cpu}$ là target CPU utilization, còn $W/C$ là tỷ lệ giữa thời gian chờ và thời gian tính toán của task.
Thời gian chờ càng dài thì về lý thuyết có thể bố trí càng nhiều thread, để khi một phần task đang chờ I/O, các task khác vẫn tiếp tục sử dụng CPU. Tuy nhiên, khi việc chờ xuất phát từ database connection pool cạn kiệt, downstream rate limiting hoặc lock contention, tăng thread chỉ tạo ra nhiều thời gian chờ hơn. Công thức không thể nhận biết sự khác biệt này.
Sau khi xác định giá trị ban đầu, vẫn cần điều chỉnh từng bước bằng load test gần với traffic thực tế. Khi load test, đồng thời theo dõi throughput, P95/P99 latency, CPU, context switch, queue wait time và downstream connection pool; không thể chỉ nhìn application QPS.
Nên đặt bounded queue lớn đến đâu?
Queue chủ yếu dùng để hấp thụ dao động traffic trong thời gian ngắn, không phù hợp để lưu lâu dài các task xử lý không kịp. Queue quá nhỏ thì chỉ cần dao động nhẹ cũng có thể kích hoạt rejection; queue quá lớn thì dù task được tiếp nhận, trước khi thực sự thực thi có thể đã vượt quá business timeout, đồng thời còn chiếm nhiều heap memory.
Có thể dùng traffic burst trước tiên để ước tính lượng buffer cần thiết. $\lambda_{in}$ biểu thị tốc độ task đi vào, $\lambda_{out}$ biểu thị tốc độ hoàn thành, còn $\Delta t$ biểu thị thời gian kéo dài của burst:
$$
Q \approx (\lambda_{in} - \lambda_{out}) \times \Delta t
$$
Ví dụ, thread pool có thể hoàn thành khoảng 500 task mỗi giây, một đợt traffic peak đẩy tốc độ submit lên 600 task mỗi giây trong 2 giây, thì trong khoảng thời gian này sẽ phát sinh thêm khoảng 200 task. Con số này chỉ cho biết nhu cầu buffer ngắn hạn; capacity cuối cùng còn bị giới hạn bởi thời hạn xử lý task và memory.
Queue wait time cũng có thể dùng để phán đoán sơ bộ: queue có 500 task, thread pool hoàn thành 500 task mỗi giây, task ở cuối queue vẫn phải chờ khoảng 1 giây. Khi tổng timeout của interface chỉ là 800 ms, nhóm task này dù đã vào queue cũng khó trả kết quả đúng hạn.
Sau khi số worker thread đạt corePoolSize, task mới sẽ trước tiên đi vào queue; chỉ khi queue đầy, thread pool mới tiếp tục tạo thread cho đến maximumPoolSize. Khi queue được đặt quá lớn, số thread có thể lâu dài dừng ở số core thread, khiến số thread tối đa hiếm khi có cơ hội phát huy tác dụng. Với unbounded queue, maximumPoolSize trên thực tế sẽ không tham gia mở rộng.
Khi xác định queue capacity, ít nhất cần thực hiện bốn bước xác minh:
- Dùng traffic peak và thời gian kéo dài của burst để ước tính nhu cầu buffer.
- Kiểm tra thời gian chờ dự kiến của task cuối queue có vượt quá thời hạn nghiệp vụ hay không.
- Đo memory mà các task đang xếp hàng chiếm dụng, đặc biệt là task chứa file, request body hoặc collection lớn.
- Khi queue đầy và task bị reject, xác minh cơ chế degrade và alert có hoạt động hay không.
Vì sao số thread phải được thiết kế cùng capacity của downstream?
Không ít task I/O cuối cùng sẽ truy cập database, Redis hoặc external interface. Thread pool có thể cho phép nhiều task thực hiện call cùng lúc hơn, nhưng không làm tăng năng lực xử lý của downstream.
Giả sử order service được deploy thành 4 instance, mỗi instance cấu hình 40 thread cho một loại database task, về lý thuyết có thể đồng thời phát sinh 160 database request. Khi database connection pool của mỗi instance chỉ có 20 connection, nhiều thread sẽ bị block tại vị trí lấy connection; nếu bản thân database chỉ có thể ổn định chịu 80 query đồng thời, thì ngay cả khi tiếp tục mở rộng connection pool, áp lực vẫn có thể bị chuyển sang database.
Khi cấu hình, cần phân bổ concurrency budget từ toàn bộ call chain:
- Phải dành trước một phần database connection cho Web request, scheduled task và các thread pool nghiệp vụ khác, không thể giao toàn bộ cho một thread pool.
- Giới hạn theo route và tổng số connection của HTTP client connection pool phải phù hợp với concurrency thực tế của call.
- Khi downstream có ngưỡng rate limit, tổng concurrency của tất cả instance upstream không được vượt quá ngưỡng đó trong thời gian dài.
- Khi một task truy cập tuần tự hoặc song song nhiều dependency, cần tính riêng thời gian chiếm dụng của từng dependency.
Sau khi tăng số thread, nếu active connection, thời gian chờ lấy connection, downstream P99 và error rate đồng thời tăng, tiếp tục tăng thread thường không có ích. Khi đó nên giảm concurrency không hiệu quả, xử lý slow SQL, downstream timeout hoặc resource hotspot.
Xử lý thế nào khi queue tích tụ?
Queue liên tục tăng cho thấy tốc độ task đi vào đã vượt tốc độ hoàn thành. Traffic tăng đột ngột sẽ gây tích tụ, bản thân task chậm đi cũng gây tích tụ, nhưng cách xử lý hai trường hợp này khác nhau.
| Hiện tượng | Bằng chứng cần kiểm tra | Hướng xử lý |
|---|---|---|
| Tốc độ submit tăng, thời gian thực thi task về cơ bản không đổi | Entry QPS, traffic thực tế, retry của caller | Rate limiting ở entry, scale instance hoặc dùng MQ để san bằng peak |
| Tốc độ submit ổn định, thời gian thực thi task tăng | Thread stack, slow SQL, lock wait, downstream latency | Xử lý slow task và lỗi downstream, không vội tăng thread |
| Active thread đã đầy, CPU lâu dài gần mức tối đa | CPU utilization, run queue, context switch | Tối ưu tính toán, tách task hoặc scale machine |
| Nhiều thread chờ database connection | Active connection của pool, số lượng đang chờ, timeout khi lấy connection | Giới hạn concurrency, tối ưu SQL, phân bổ lại connection budget |
| Queue wait time đã vượt thời hạn hiệu lực của task | Queue wait P95/P99, business timeout | Fail fast, loại bỏ expired task hoặc chuyển vào compensation flow |
| Queue và rejection tăng, downstream vẫn còn capacity | CPU, connection pool và downstream metric đều bình thường | Sau load test điều chỉnh số thread, queue hoặc số instance |
Scale machine phù hợp khi capacity tổng thể của service không đủ và task có thể được tách theo chiều ngang. Tăng thread phù hợp khi một instance vẫn còn CPU và downstream capacity, nhưng concurrency hiện tại quá thấp. Khi task đã quá thời hạn xử lý, tiếp tục xếp hàng không còn nhiều ý nghĩa; với async task không thể mất, trước tiên nên ghi vào MQ hoặc database, sau đó xử lý bằng consumer flow có thể retry.
Khi thread pool đã xuất hiện tích tụ trên production, có thể tham khảo Điều tra vấn đề production của Java backend, kết hợp tốc độ submit, tốc độ hoàn thành, thread stack và trạng thái downstream để xác định vấn đề.
CallerRunsPolicy có thể tạo backpressure không?
CallerRunsPolicy sẽ để thread gọi execute() thực thi task bị reject. Vì vậy submit thread trở nên chậm hơn, tốc độ submit các task tiếp theo cũng có thể giảm, nên nó có tác dụng điều chỉnh phản hồi ở mức nhất định.
Hiệu quả phụ thuộc vào caller là ai. Khi message consumer thread hoặc batch scheduling thread bị buộc phải thực thi task, tốc độ pull của upstream có thể tự nhiên giảm xuống; khi Tomcat request thread thực thi long task, request thread sẽ bị chiếm giữ, latency của interface và áp lực lên request thread pool cũng tăng. Khi submit thread đang giữ lock hoặc database transaction, việc task thực thi trên caller thread còn kéo dài thời gian chiếm dụng lock và transaction.
Sau khi thread pool shutdown, CallerRunsPolicy sẽ không tiếp tục thực thi task mà trực tiếp loại bỏ task. Khi nghiệp vụ không thể chấp nhận mất task, cần rejection handler tùy chỉnh: ghi lại số lần reject, trả về failure rõ ràng, hoặc ghi task vào reliable storage. Không nên chỉ đổi một rejection policy rồi để vấn đề reliability của task cho caller xử lý.
Có nên cô lập thread pool cho các nghiệp vụ khác nhau không?
Shared thread pool sẽ khiến một loại slow task chiếm dụng execution resource của nghiệp vụ khác. Payment callback, report export và notification thông thường khác nhau về thời hạn xử lý, cách xử lý failure và resource dependency; rất khó cấu hình số thread, queue và rejection policy thống nhất khi đặt chúng trong cùng một thread pool.
Cô lập cũng không có nghĩa là tạo một thread pool cho mỗi interface. Thông thường nên phân chia theo task priority, đặc điểm thời gian xử lý và downstream dependency: các task gọi cùng một slow service có thể được cô lập riêng; core transaction không dùng chung queue với non-core notification; CPU-intensive task không trộn với số lượng lớn blocking I/O task. Quá nhiều thread pool sẽ làm tăng chi phí thread, queue, monitoring và configuration; các task cùng loại có thể dùng chung một pool.
Bài viết trước đây từng dẫn một case sự cố do task cha và task con dùng chung thread pool (nguồn: Một sự cố production do sử dụng thread pool không đúng cách):
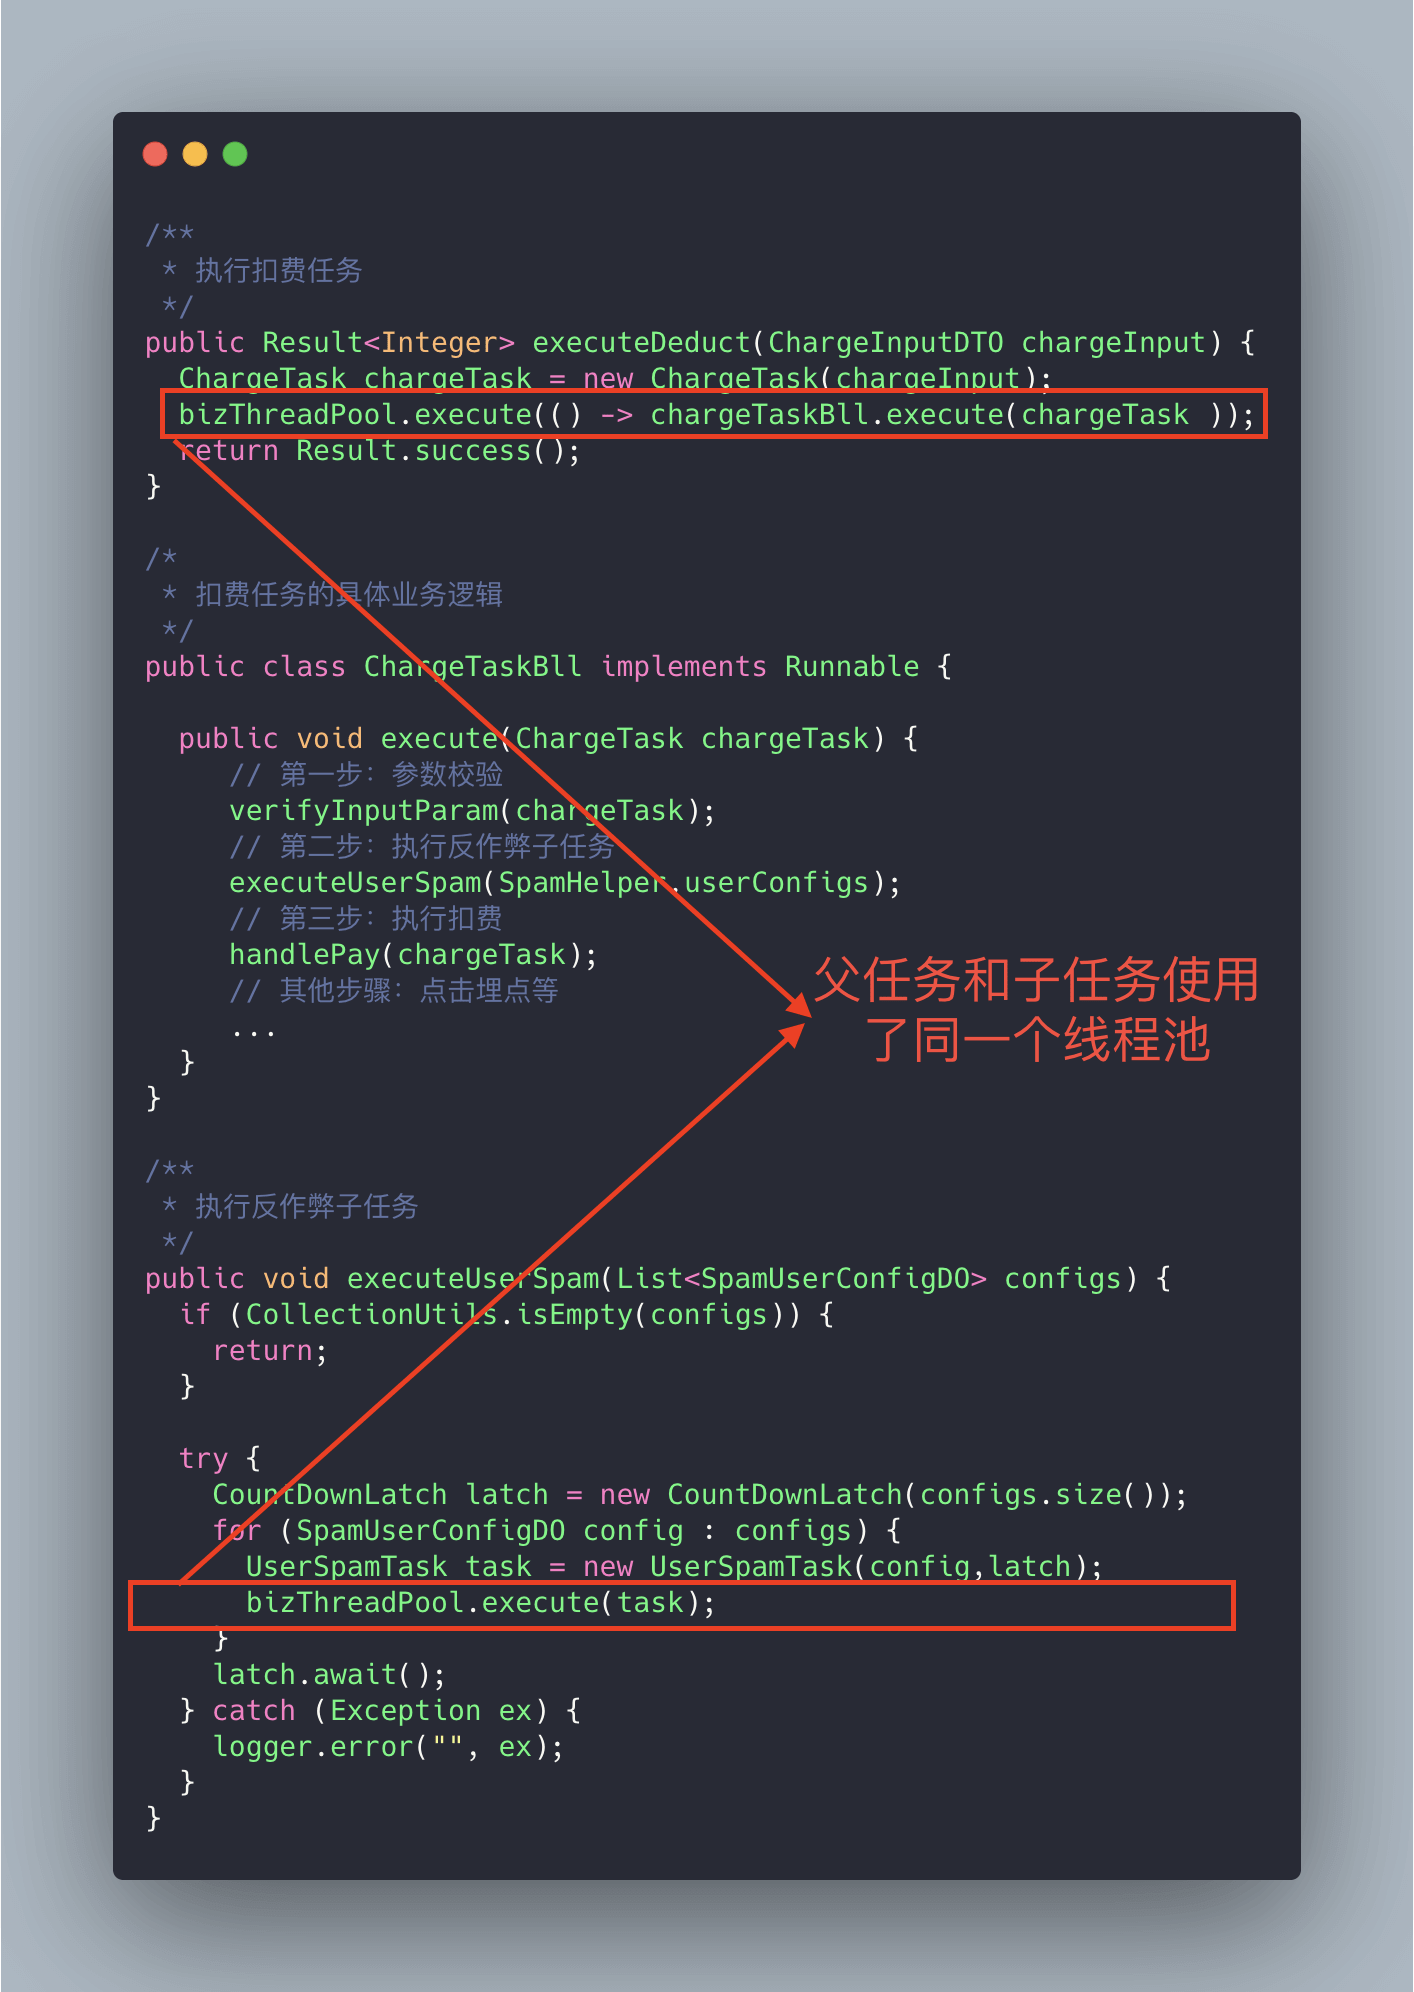
Giả sử thread pool có $n$ worker thread và đồng thời chạy $n$ parent task. Mỗi parent task submit child task rồi đồng bộ chờ child task kết thúc. Child task đi vào queue nhưng không có thread rảnh để thực thi; parent task không kết thúc nên worker thread cũng không được giải phóng, cuối cùng hình thành thread starvation deadlock.
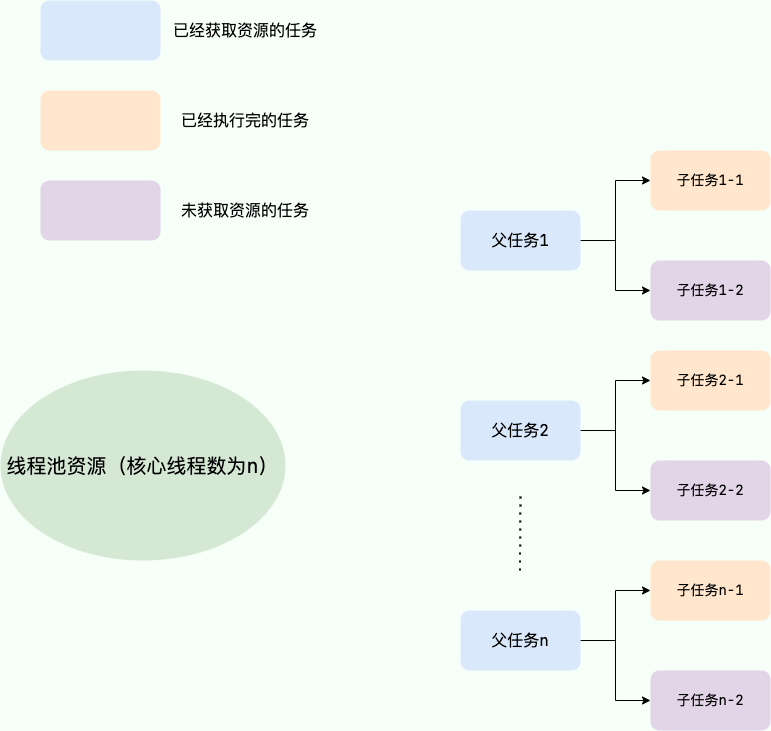
Parent task và child task mà parent task đồng bộ chờ không nên dùng bounded thread pool này để tạo thành vòng chờ. Có thể để parent task trực tiếp thực thi child logic, đổi sang task orchestration không blocking, hoặc phân bổ execution resource riêng cho child task thực sự cần isolation.
Task timeout có tự động dừng không?
Future.get(timeout, unit) chỉ giới hạn thời gian caller thread chờ kết quả. Khi bị ném TimeoutException, background task có thể vẫn đang chạy. Gọi cancel(true) có thể thử interrupt execution thread, nhưng interrupt là cơ chế phối hợp; nếu task không kiểm tra interrupt status hoặc underlying call không phản hồi interrupt, task vẫn có thể tiếp tục thực thi.
Future<String> future = executor.submit(this::callRemoteService);

try {
    return future.get(200, TimeUnit.MILLISECONDS);
} catch (TimeoutException e) {
    future.cancel(true);
    throw new IllegalStateException("Call timeout", e);
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
    throw new IllegalStateException("Interrupted while waiting for task", e);
} catch (ExecutionException e) {
    throw new IllegalStateException("Task execution failed", e.getCause());
}
Đoạn code này vẫn chưa đủ để thay thế network timeout. HTTP, database và Redis client vẫn phải cấu hình connection timeout, read timeout và tổng call timeout; nếu không, thread có thể bị kẹt mãi trong underlying operation không phản hồi interrupt.
Sau khi task nhận InterruptedException, thông thường cần kết thúc công việc hiện tại; nếu không thể kết thúc ở layer hiện tại thì phải khôi phục interrupt flag để layer bên trên tiếp tục xử lý:
try {
    blockingCall();
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
    return;
}
CompletableFuture.orTimeout() sẽ khiến CompletableFuture hoàn thành với exception sau khi timeout, nhưng không tự động dừng underlying task. Đối số của CompletableFuture.cancel(true) cũng không kích hoạt thread interrupt trong implementation này. Khi dùng CompletableFuture để orchestration blocking task, vẫn cần cấu hình timeout và phương án cancel cho underlying call.
Vì sao exception của async task dễ bị mất?
Khi Runnable được submit bằng execute() ném uncaught exception, worker thread sẽ kết thúc bất thường và có thể được ghi lại bởi UncaughtExceptionHandler của thread. Khi submit bằng submit(), task thường được bọc thành FutureTask, exception được lưu trong Future trả về; nếu caller không lưu Future cũng không gọi get(), exception có thể không xuất hiện trong log nghiệp vụ.
ThreadPoolExecutor.afterExecute() cũng có khác biệt tương tự. Khi dùng submit(), Throwable truyền vào afterExecute() thường là null; cần kiểm tra task có phải Future đã hoàn thành hay không, rồi gọi get() để lấy exception.
Cách xử lý exception nên được thống nhất trong project: caller consume Future, entry point của task chủ động catch và ghi log exception, hoặc mở rộng thread pool để xử lý tập trung. Log phải có task type, business ID và Trace ID; không thể chỉ in một thread stack tách rời khỏi nghiệp vụ.
Thread pool nên monitor những metric nào?
Các thống kê có sẵn của ThreadPoolExecutor cho biết số thread hiện tại, số active thread, số thread tối đa trong lịch sử, tổng số task, số task đã hoàn thành và queue length. Phần lớn các giá trị này là giá trị gần đúng, phù hợp cho monitoring và phân tích xu hướng, không phù hợp để dùng trong quyết định nghiệp vụ yêu cầu tính nhất quán nghiêm ngặt.
Monitoring trong production ít nhất phải bao phủ:
- Task traffic: tốc độ submit, tốc độ bắt đầu thực thi và tốc độ hoàn thành.
- Thread state: số thread hiện tại, số active thread, số thread tối đa trong lịch sử và mức độ hoạt động.
- Queue state: độ dài hiện tại, tổng capacity, utilization và queue wait time.
- Task result: execution time, số task thành công, số exception, số timeout, số cancel và số reject.
- Resource liên quan: CPU, heap memory, database connection pool, HTTP connection pool và downstream latency.
Tổng số task và số task đã hoàn thành là giá trị tích lũy; cần tính chênh lệch trong một khoảng thời gian để có được tốc độ. Queue length cũng phải kết hợp với xu hướng thay đổi: cùng là queue 100, một queue đang giảm từ 500 xuống 100 và một queue tăng từ 10 lên 100 có mức rủi ro hoàn toàn khác nhau.
Queue time và execution time không được trộn thành một metric. Queue time tăng nhưng execution time ổn định thường là do capacity không đủ hoặc traffic tăng đột biến; execution time tăng trước, sau đó queue bắt đầu tăng thì nên ưu tiên kiểm tra logic của task và downstream. Có thể ghi timestamp khi submit task, rồi lần lượt tính hai khoảng thời gian khi task thực sự bắt đầu và kết thúc.
Queue đột nhiên dài hơn trong một chu kỳ thu thập có thể chỉ là traffic spike và sẽ nhanh chóng giảm xuống. Ngoài threshold, alert cũng nên thêm thời gian kéo dài và xác nhận tình trạng tích tụ có thể tự xử lý hết hay không. Queue ở mức cao trong thời gian dài, tốc độ hoàn thành liên tục thấp hơn tốc độ submit cho thấy task cũ ngày càng tích tụ; khi P99 queue time gần với thời gian task có thể chờ, dù queue chưa đầy cũng nên alert. Số lần reject cần được thống kê riêng. Core task bị reject thì alert ngay, còn task được phép loại bỏ thì đặt threshold theo tỷ lệ reject và thời gian kéo dài.
Điều chỉnh tham số động có thể giải quyết vấn đề gì?
Khi thời gian xử lý task không thay đổi rõ rệt, CPU, connection pool và downstream vẫn còn capacity, chỉ là concurrency hiện tại không theo kịp tốc độ submit, có thể điều chỉnh số thread. Nếu tất cả thread đều bị kẹt ở database connection, slow SQL hoặc downstream timeout, tăng số thread chỉ tạo thêm một nhóm thread chờ.
Một số tham số của ThreadPoolExecutor có thể được sửa online, nhưng cách chúng có hiệu lực không giống nhau. Trong runtime có thể sửa corePoolSize, maximumPoolSize, keepAliveTime, rejection policy và thread factory. Sau khi tăng core thread count, chỉ cần queue vẫn còn task thì thread pool sẽ tạo thread mới theo nhu cầu. Giảm core thread count hoặc maximum thread count không interrupt task đang thực thi; worker thread vượt quá giới hạn sẽ thoát sau khi idle. Thread factory mới đặt chỉ ảnh hưởng các thread được tạo từ sau đó, không đổi tên các worker thread đã tồn tại.
Khi sửa core thread count và maximum thread count cần chú ý thứ tự:
- Nếu core thread count mới cao hơn maximum thread count cũ, trước tiên tăng maximum thread count rồi mới điều chỉnh core thread count.
- Nếu maximum thread count mới thấp hơn core thread count cũ, trước tiên giảm core thread count rồi mới điều chỉnh maximum thread count.
Nếu không, việc kiểm tra tham số sẽ ném IllegalArgumentException.
JDK không cung cấp phương thức chung để sửa capacity của blocking queue hiện có. Khi cần điều chỉnh queue, có thể sử dụng queue có capacity thay đổi đã được kiểm chứng hoặc dynamic thread pool framework; nếu tự sửa implementation của LinkedBlockingQueue, đồng thời phải xử lý concurrency visibility, điều kiện enqueue và logic wake-up, không thể chỉ sửa một field capacity.
Meituan Technical Team từng giới thiệu cách triển khai dynamic configuration cho thread pool, monitoring và alert trong 《Nguyên lý triển khai thread pool Java và thực tiễn trong nghiệp vụ Meituan》. Trong các giải pháp open source, Hippo4j và Dynamic TP đều cung cấp khả năng dynamic configuration, monitoring và alert. Trước khi đưa vào sử dụng, vẫn cần kiểm tra loại thread pool, configuration center, version framework và cơ chế degrade khi có sự cố mà project sử dụng.
Nên điều chỉnh tham số trước giờ cao điểm, tốt nhất dựa trên metric lịch sử hoặc kết quả load test. Sau khi điều chỉnh, nếu tốc độ hoàn thành không tăng mà CPU lại tăng, xuất hiện connection pool wait hoặc downstream error rate tăng, nên rollback tham số và tiếp tục kiểm tra bản thân task cùng dependency.
Khi thay đổi trên production cần giữ lại giới hạn trên và dưới của tham số, change record, phạm vi canary và giá trị rollback. Mỗi lần nên cố gắng chỉ thay đổi một biến chính, quan sát tốc độ hoàn thành task, queue time, số lần reject và áp lực downstream, rồi mới quyết định có tiếp tục điều chỉnh hay không.
Còn vấn đề nào dễ bị bỏ qua?
Không tạo lại thread pool
Thread pool dùng để tái sử dụng thread, không nên tạo lại trong mỗi request hoặc mỗi lần gọi method. Việc tạo thường xuyên sẽ làm tăng chi phí khởi tạo và hủy thread, đồng thời dễ bỏ sót logic shutdown. Thread pool ở cấp application thường được giao cho container thống nhất quản lý lifecycle.
Spring @Async, scheduled task, Web container và một số client bên trong cũng sử dụng thread pool. Việc project không gọi trực tiếp new ThreadPoolExecutor() không có nghĩa là không tồn tại thread pool cần cấu hình và monitoring.
Không để long task chiếm đầy shared thread pool
Task bị block trong thời gian dài sẽ chiếm worker thread, khiến short task phía sau chỉ có thể xếp hàng. Report export, file processing và các external interface chậm nên dùng execution resource riêng, hoặc chuyển thành async task và trả task state cho user.
CompletableFuture chỉ phụ trách task orchestration, không biến blocking network request thành non-blocking operation. Các async method không chỉ định rõ Executor thường sử dụng common thread pool; khi common thread pool bị block, các async task khác trong application cũng có thể bị ảnh hưởng.
Dọn dẹp thread context
Thread pool sẽ reuse thread. Nếu task trước ghi vào ThreadLocal nhưng không cleanup, task sau có thể đọc được giá trị cũ trên cùng thread, đồng thời còn có thể khiến object lớn bị worker thread giữ reference trong thời gian dài.
Việc truyền và cleanup context nên do một task wrapper thống nhất xử lý; trong finally, khôi phục hoặc xóa giá trị cũ. Cần cân nhắc cả log MDC, thông tin đăng nhập và thông tin tenant. Trong trường hợp truyền giữa các thread cũng có thể sử dụng TransmittableThreadLocal, nhưng vẫn phải xác nhận cách wrapper hoạt động và thời điểm cleanup.
Shutdown thread pool đúng cách
shutdown() không tiếp nhận task mới, nhưng sẽ tiếp tục xử lý task đã submit; shutdownNow() sẽ thử interrupt task đang thực thi và trả về task chưa bắt đầu thực thi. Cả hai đều không chờ thread pool terminate hoàn toàn.
executor.shutdown();
try {
    if (!executor.awaitTermination(30, TimeUnit.SECONDS)) {
        executor.shutdownNow();
        if (!executor.awaitTermination(30, TimeUnit.SECONDS)) {
            System.err.println("Thread pool could not terminate normally");
        }
    }
} catch (InterruptedException e) {
    executor.shutdownNow();
    Thread.currentThread().interrupt();
}
Task cần phản hồi interrupt đúng cách, nếu không shutdownNow() cũng không thể đảm bảo dừng ngay lập tức. Trong quá trình application shutdown còn phải quyết định task trong queue có thể bị mất hay không; task nghiệp vụ không thể mất không nên chỉ tồn tại trong process memory.
Sau khi sử dụng virtual thread còn cần thread pool truyền thống không?
Virtual thread phù hợp với task chứa nhiều blocking wait. Chi phí tạo và chuyển đổi của nó thấp hơn platform thread, thông thường dùng một virtual thread cho mỗi task, không đưa virtual thread vào fixed-size pool để reuse.
Khi cần giới hạn concurrency của database hoặc downstream interface, vẫn tiếp tục sử dụng connection pool, Semaphore, rate limiter và các cơ chế khác để ràng buộc resource cụ thể. Dù số lượng virtual thread rất lớn, chúng cũng không làm tăng số database connection, số CPU core hay capacity của downstream interface.
Platform thread pool truyền thống vẫn phù hợp với CPU-intensive task, task cần scheduling thread cố định và các component cần kiểm soát tường minh platform thread cùng work queue. Việc project có migration hay không còn phụ thuộc vào JDK version, framework support, monitoring tool và async model hiện có. Có thể tham khảo giải thích chi tiết tại Tổng hợp các câu hỏi thường gặp về virtual thread.
Trả lời thế nào về cấu hình tham số thread pool trong phỏng vấn?
Khi trả lời về tham số thread pool, có thể bắt đầu từ task và system capacity: trước tiên ước tính nhu cầu concurrency dựa trên tốc độ submit task giờ cao điểm và thời gian xử lý task, sau đó phân biệt computation time với I/O wait time; số thread còn chịu ràng buộc của CPU, database connection pool, HTTP connection pool và downstream rate limit. Queue chỉ hấp thụ burst ngắn hạn, capacity phải đồng thời đáp ứng thời hạn chờ của nghiệp vụ và giới hạn bộ nhớ. Sau khi xác định tham số ban đầu, thông qua load test và production monitoring quan sát tốc độ submit, tốc độ hoàn thành, queue time, execution time và số lần reject, rồi điều chỉnh từng bước.
Khi interviewer hỏi thêm về queue tích tụ, không nên chỉ trả lời là mở rộng thread pool. Trước tiên so sánh tốc độ submit task với tốc độ hoàn thành, sau đó xem execution time, thread stack, CPU, connection pool và downstream latency. Traffic tăng có thể xử lý bằng rate limiting hoặc scale instance; task chậm đi thì phải xử lý SQL, lock hoặc lỗi downstream; khi task đã hết hạn thì nên fail fast hoặc chuyển sang compensation. Điều chỉnh động chỉ xử lý trường hợp cấu hình capacity không phù hợp, không thể thay thế timeout, isolation, rate limiting và downstream governance.
Tham khảo
- ThreadPoolExecutor API Documentation
- Future API Documentation
- CompletableFuture API Documentation
- JEP 444: Virtual Threads
- Nguyên lý triển khai thread pool Java và thực tiễn trong nghiệp vụ Meituan
- 《Java Concurrency in Practice》
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.