
Giải thích nâng cao về ZooKeeper: giao thức ZAB, bầu chọn Leader, triển khai cluster và cơ chế session
Được FrancisQ đóng góp.
ZooKeeper là gì
ZooKeeper do Yahoo phát triển, sau đó được tặng cho Apache và hiện đã trở thành dự án cấp cao nhất của Apache. ZooKeeper là một server điều phối ứng dụng phân tán mã nguồn mở, cung cấp dịch vụ consistency cho hệ thống phân tán. Consistency này được hoàn thành thông qua giao thức ZAB (ZooKeeper Atomic Broadcast) được thiết kế riêng cho ZooKeeper. Các chức năng chính gồm: duy trì cấu hình, đồng bộ phân tán, quản lý cluster, v.v.
Nói đơn giản, ZooKeeper là một framework dịch vụ điều phối phân tán. Phân tán? Dịch vụ điều phối? Đó là gì vậy? 🤔🤔
Thực ra, khi giải thích khái niệm phân tán, tôi nhận thấy một số bạn vẫn chưa hiểu rõ phân tán và cluster. Trước đây có bạn trao đổi với tôi về hệ thống phân tán và nói rằng hệ thống phân tán chẳng phải chỉ là thêm máy sao? Một máy không đủ thì thêm một máy để chịu tải là được. Cách nói thêm máy dĩ nhiên không hẳn sai: một hệ thống phân tán chắc chắn liên quan đến nhiều máy. Nhưng trong ngành máy tính còn có một khái niệm tương tự là Cluster; cluster cũng là thêm máy, vậy cluster và hệ thống phân tán chẳng phải giống nhau sao? Thực tế, cluster và hệ thống phân tán là hai khái niệm hoàn toàn khác nhau.
Ví dụ, tôi có một service flash sale với concurrency quá lớn khiến hệ thống đơn máy không chịu nổi, nên thêm vài server nhưng các server này vẫn cùng cung cấp service flash sale. Đây là cluster.
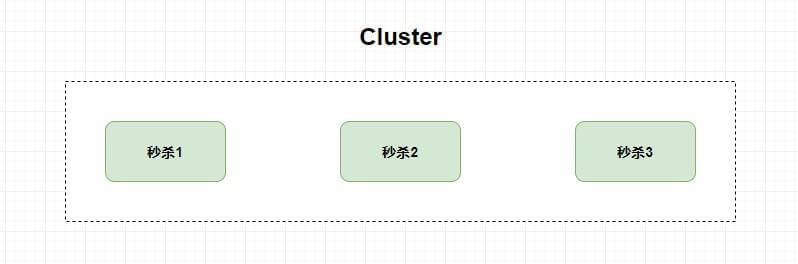
Nhưng nếu đổi cách làm, tôi tách một service flash sale thành nhiều sub-service, chẳng hạn service tạo order, service cộng điểm, service trừ coupon, v.v., sau đó triển khai các sub-service này trên những server khác nhau, thì đây là hệ thống phân tán.
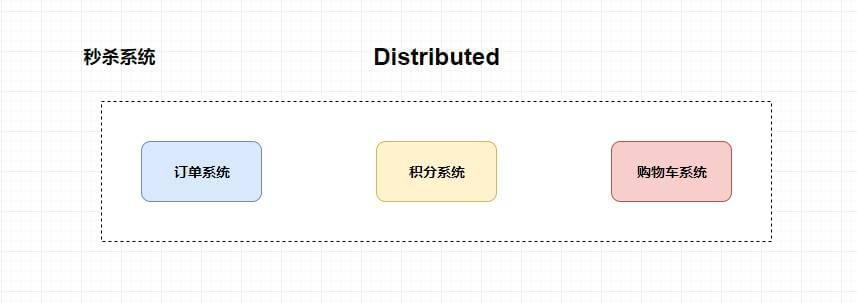
Vì sao tôi phản biện quan điểm hệ thống phân tán chỉ là thêm máy? Vì thêm máy phù hợp hơn với việc xây dựng cluster: đúng là chỉ thêm máy. Còn với hệ thống phân tán, trước hết cần tách business, sau đó mới thêm máy (không chỉ đơn giản là thêm máy), đồng thời còn phải giải quyết hàng loạt vấn đề do phân tán mang lại.
Ví dụ: các thành phần phân tán phối hợp với nhau thế nào, giảm coupling giữa các hệ thống ra sao, xử lý distributed transaction thế nào, cấu hình toàn bộ hệ thống phân tán ra sao, v.v. ZooKeeper chủ yếu giải quyết những vấn đề này.
Vấn đề consistency
Khi thiết kế hệ thống phân tán, chắc chắn sẽ gặp một vấn đề: do partition tolerance tồn tại, chúng ta buộc phải cân bằng giữa availability và consistency của dữ liệu. Đây là định lý CAP nổi tiếng.
Có thể hiểu rất đơn giản. Hãy coi một lớp học là toàn bộ hệ thống, còn học sinh là các sub-system độc lập. Tiểu Hồng và Tiểu Minh bí mật yêu nhau, bị Tiểu Hoa nhiều chuyện phát hiện. Tiểu Hoa vui mừng kể cho mọi người xung quanh, rồi tin này lan ra cả lớp. Trong lúc tin đang lan truyền, nếu bạn hỏi một học sinh về chuyện đó mà bạn ấy trả lời không biết, thì hệ thống cả lớp có vấn đề consistency dữ liệu (vì Tiểu Hoa đã biết). Còn nếu bạn ấy không trả lời vì tin đang được truyền đi trong lớp (để đảm bảo consistency, phải đợi tất cả mọi người biết mới cung cấp service), thì hệ thống lại gặp vấn đề availability.
Cách xử lý thứ nhất ở trên là của Eureka, đảm bảo AP (availability); cách thứ hai là của ZooKeeper mà chúng ta tìm hiểu hôm nay, đảm bảo CP (consistency của dữ liệu).
Consistency protocol và algorithm
Để giải quyết vấn đề consistency dữ liệu, sau quá trình tìm tòi không ngừng của các nhà khoa học và lập trình viên, nhiều consistency protocol và algorithm đã ra đời. Ví dụ: 2PC (two-phase commit), 3PC (three-phase commit), algorithm Paxos, v.v.
Hãy suy nghĩ một vấn đề: nếu các bạn học sinh truyền tin bằng cách chuyền giấy, làm sao biết tờ giấy của mình đã đến tay đúng người cần nhận? Nếu bị ai đó chặn lại rồi sửa nội dung thì sao?

Từ đó dẫn đến khái niệm bài toán các vị tướng Byzantine. Nó có nghĩa là không thể đạt được consistency bằng cách truyền message trên một kênh không đáng tin cậy. Vì vậy, tiền đề cần thiết của mọi consistency algorithm là một message channel an toàn và đáng tin cậy.
Vì sao phải giải quyết consistency dữ liệu? Hãy nghĩ xem: nếu một hệ thống flash sale tách thành service đặt order và service cộng điểm, hai service này được triển khai trên hai máy khác nhau. Nếu service điểm bị dừng trong lúc message đang được truyền, chẳng lẽ order đã đặt nhưng điểm lại không được cộng? Dữ liệu ở hai phía phải consistency chứ?
2PC (two-phase commit)
Two-phase commit là protocol đảm bảo consistency dữ liệu trong hệ thống phân tán. Hiện nay, nhiều database dùng two-phase commit protocol để xử lý distributed transaction.
Trước khi giới thiệu 2PC, hãy nghĩ xem distributed transaction thực sự gặp vấn đề gì.
Vẫn lấy hai hệ thống đặt order và cộng điểm của flash sale làm ví dụ (có lẽ bạn đã ngán ví dụ này rồi 🤮🤮🤮). Sau khi đặt order, chúng ta gửi một message cho service điểm, báo rằng nó cần cộng điểm. Nếu chỉ gửi message mà không nhận response, làm sao service order biết service điểm đã nhận message hay chưa? Nếu thêm bước nhận response, sau khi service điểm nhận message và trả về Response cho service order, nhưng mạng chập chờn khiến response không gửi thành công, service order sẽ nghĩ service điểm nhận thất bại và rollback transaction. Trong khi đó service điểm thực tế đã nhận message, xử lý message và cộng điểm cho người dùng. Kết quả là điểm đã được cộng nhưng order lại chưa đặt thành công.
Vì vậy, điều cần giải quyết là trong toàn bộ call chain của hệ thống phân tán, việc xử lý dữ liệu của tất cả service hoặc đều thành công hoặc đều thất bại, tức vấn đề atomicity của tất cả service.
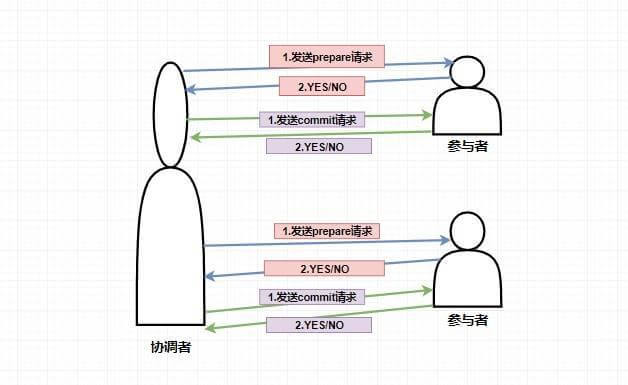
2PC chủ yếu có hai role: coordinator và participant.
Giai đoạn một: khi thực hiện một distributed transaction, transaction initiator trước hết gửi yêu cầu transaction cho coordinator. Sau đó coordinator gửi yêu cầu prepare (bao gồm nội dung transaction) cho tất cả participant, báo rằng cần thực hiện transaction. Nếu có thể thực hiện nội dung transaction thì hãy thực hiện trước nhưng chưa commit, rồi phản hồi. Sau khi nhận message prepare, các participant bắt đầu thực hiện transaction (nhưng chưa commit), ghi thông tin Undo và Redo vào transaction log, rồi phản hồi cho coordinator biết đã sẵn sàng hay chưa.
Giai đoạn hai: coordinator quyết định có thể commit transaction hay không dựa trên phản hồi của participant, tức commit transaction hoặc rollback transaction.
Nếu tất cả participant đều phản hồi đã sẵn sàng, transaction sẽ được commit. Coordinator gửi yêu cầu Commit cho tất cả participant. Khi nhận yêu cầu Commit, participant thực hiện commit operation của transaction đã thực hiện trước đó, rồi gửi response commit thành công cho coordinator.
Nếu ở giai đoạn một không phải tất cả participant đều phản hồi sẵn sàng, coordinator gửi yêu cầu rollback transaction cho tất cả participant. Participant rollback phần xử lý transaction đã thực hiện ở giai đoạn một, sau đó phản hồi kết quả cho coordinator. Cuối cùng coordinator nhận response và trả về kết quả xử lý thất bại cho transaction initiator.
Theo tôi, 2PC khá bất tiện vì thực tế nó chỉ giải quyết atomicity của từng transaction, đồng thời kéo theo nhiều vấn đề.
- Vấn đề single point of failure: nếu coordinator dừng, toàn bộ hệ thống sẽ không khả dụng.
- Vấn đề blocking: khi coordinator gửi yêu cầu
prepare, participant nhận được và có thể xử lý thì sẽ thực hiện transaction nhưng chưa commit, tiếp tục chiếm resource mà không giải phóng. Nếu coordinator dừng lúc này, các resource đó sẽ không được giải phóng nữa, ảnh hưởng lớn đến performance. - Vấn đề consistency dữ liệu: ở giai đoạn hai, nếu coordinator chỉ gửi một phần yêu cầu
commitrồi dừng, participant nhận được message sẽ commit transaction, còn participant chưa nhận sẽ không commit. Khi đó consistency dữ liệu bị phá vỡ.
3PC (three-phase commit)
Do 2PC có nhiều vấn đề như single point, thiếu sót trong cơ chế fault tolerance, v.v., 3PC (three-phase commit) ra đời. Ba phase này lần lượt là gì?
Đừng hiểu PC là máy tính cá nhân. Đây là viết tắt của phase-commit, nghĩa là phase commit.
- Giai đoạn CanCommit: coordinator gửi yêu cầu
CanCommitcho tất cả participant. Participant kiểm tra theo tình trạng của mình xem có thể thực hiện transaction hay không. Nếu có thể, participant trả về response YES và chuyển sang trạng thái chuẩn bị; nếu không, trả về NO. - Giai đoạn PreCommit: coordinator quyết định có thể thực hiện thao tác
PreCommithay không dựa trên response của participant. Nếu tất cả participant ở trên đều trả về YES, coordinator gửi yêu cầu pre-commitPreCommitcho tất cả participant. Sau khi nhận yêu cầu pre-commit, participant thực hiện transaction và ghi thông tinUndo,Redovào transaction log; cuối cùng, nếu thực hiện transaction thành công, participant trả về response thành công cho coordinator. Nếu coordinator nhận bất kỳ một phản hồi NO nào ở giai đoạn đầu, hoặc không nhận đủ response của participant trong một khoảng thời gian, transaction sẽ bị dừng. Coordinator gửi yêu cầu dừng (abort) cho tất cả participant. Participant nhận yêu cầu dừng sẽ lập tức dừng transaction; nếu không nhận được yêu cầu của coordinator trong một khoảng thời gian, participant cũng dừng transaction. - Giai đoạn DoCommit: giai đoạn này gần giống giai đoạn hai của
2PC. Nếu coordinator nhận được response YES từ tất cả participant ở giai đoạnPreCommit, coordinator gửi yêu cầuDoCommitcho tất cả participant. Sau khi nhận yêu cầuDoCommit, participant thực hiện commit transaction, rồi trả về response cho coordinator. Sau khi nhận response commit transaction thành công từ tất cả participant, coordinator hoàn tất transaction. Nếu coordinator nhận bất kỳ một NO nào ở giai đoạnPreCommithoặc không nhận được response của tất cả participant trong một khoảng thời gian, coordinator gửi yêu cầu dừng. Participant nhận yêu cầu dừng sẽ rollback transaction bằng rollback log đã ghi ở trên, phản hồi trạng thái rollback cho coordinator, rồi coordinator dừng transaction sau khi nhận message từ participant.
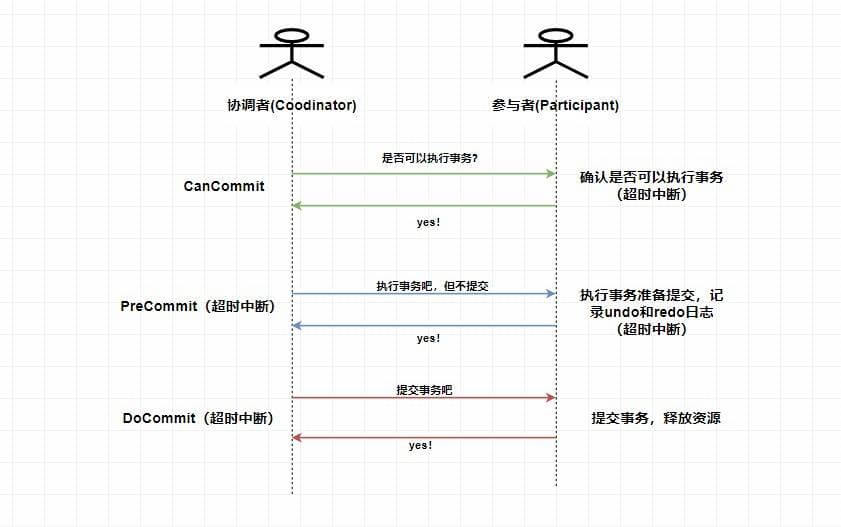
Đây là flow chart của
3PCtrong trường hợp thành công. Có thể thấy3PCxử lý timeout và dừng ở nhiều nơi, chẳng hạn coordinator dừng transaction nếu không nhận đủ confirmation trong thời gian quy định, nhờ đó giảm thời gian synchronous blocking. Cũng cần lưu ý: ở giai đoạnDoCommit, nếu participant không nhận được yêu cầu commit transaction từ coordinator, participant vẫn commit transaction trong một khoảng thời gian nhất định. Vì sao? Vì lúc này chúng ta chắc chắn tất cả participant ở giai đoạn một đều đã phản hồi có thể thực hiện transaction. Do đó, chúng ta có lý do để tin rằng các hệ thống khác đều có thể thực hiện và commit transaction. Vì vậy, bất kể coordinator có gửi message cho participant hay không, participant vẫn commit transaction khi bước vào giai đoạn ba.
Tóm lại, 3PC giảm đáng kể vấn đề blocking bằng hàng loạt cơ chế timeout, nhưng consistency quan trọng nhất vẫn chưa được giải quyết tận gốc. Ví dụ ở giai đoạn DoCommit, sau khi một participant nhận request mà các participant khác và coordinator dừng hoặc xảy ra network partition, participant nhận message vẫn commit transaction, dẫn đến consistency dữ liệu bị phá vỡ.
Vì vậy, muốn giải quyết consistency vẫn phải dựa vào algorithm Paxos ⭐️ ⭐️ ⭐️.
Algorithm Paxos
Algorithm Paxos là consistency algorithm dựa trên message passing và có khả năng fault tolerance cao, hiện được công nhận là một trong những algorithm hiệu quả nhất để giải quyết consistency trong hệ thống phân tán. Vấn đề nó giải quyết là làm sao đạt được agreement về một value (decision) trong hệ thống phân tán.
Paxos có ba role chính: Proposer (bên đề xuất), Acceptor (bên biểu quyết), Learner (bên học). Giống 2PC, algorithm Paxos cũng có hai phase: phase Prepare và phase accept.
Phase prepare
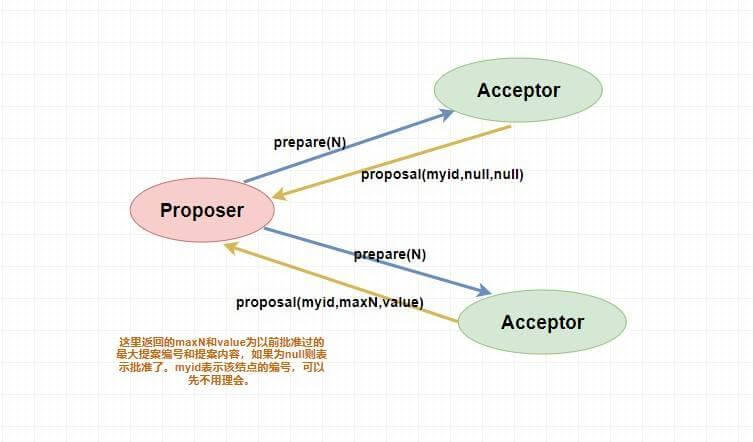
Proposer: chịu trách nhiệm đưa raproposal. Mỗi proposer trước khi đưa ra proposal sẽ lấy một proposal number N có tính duy nhất toàn cục và tăng dần, tức là number N duy nhất trong toàn cluster, rồi gán number đó cho proposal muốn đưa ra. Ở phase đầu, chỉ proposal number được gửi cho tất cả acceptor.Acceptor: sau khiacceptmột proposal, mỗi acceptor ghi proposal number N vào local. Vì vậy, trong các proposal đã được accept mà mỗi acceptor lưu lại sẽ có một proposal có number lớn nhất, giả sử làmaxN. Mỗi acceptor chỉacceptproposal có number lớn hơnmaxNlocal. Khi phê duyệt proposal, acceptor gửi lại choProposerproposal có number lớn nhất từng được accept trước đó.
Dưới đây là flow chart của phase
prepare, bạn có thể đối chiếu.
Phase accept
Sau khi một proposal được Proposer đưa ra, nếu Proposer nhận được sự phê duyệt từ hơn một nửa Acceptor (bao gồm cả sự đồng ý của chính Proposer), Proposer sẽ gửi proposal thực sự cho tất cả Acceptor (có thể hiểu phase đầu là thăm dò). Lúc này Proposer gửi nội dung proposal cùng proposal number.
Sau khi nhận yêu cầu proposal, acceptor lại so sánh proposal number lớn nhất mà mình đã phê duyệt với proposal number hiện tại. Nếu proposal number hiện tại lớn hơn hoặc bằng proposal number lớn nhất đã phê duyệt, acceptor sẽ accept proposal đó (thực hiện nội dung proposal nhưng chưa commit), rồi trả về kết quả cho Proposer. Nếu không thỏa điều kiện, acceptor không phản hồi hoặc trả về NO.
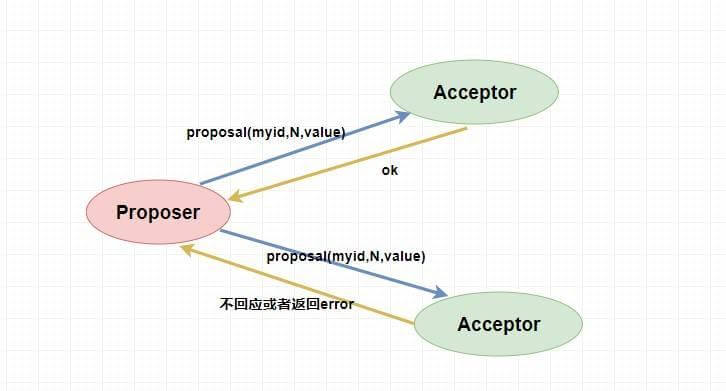
Khi Proposer nhận được hơn một nửa accept, nó gửi yêu cầu commit proposal cho tất cả acceptor. Cần lưu ý rằng ở trên chỉ hơn một nửa acceptor phê duyệt thực hiện nội dung proposal, còn các acceptor khác chưa thực hiện. Vì vậy, lúc này cần gửi nội dung và proposal number cho các acceptor chưa phê duyệt, yêu cầu chúng thực hiện và commit vô điều kiện. Với các acceptor đã phê duyệt proposal, chỉ cần gửi proposal number, để acceptor thực hiện commit.
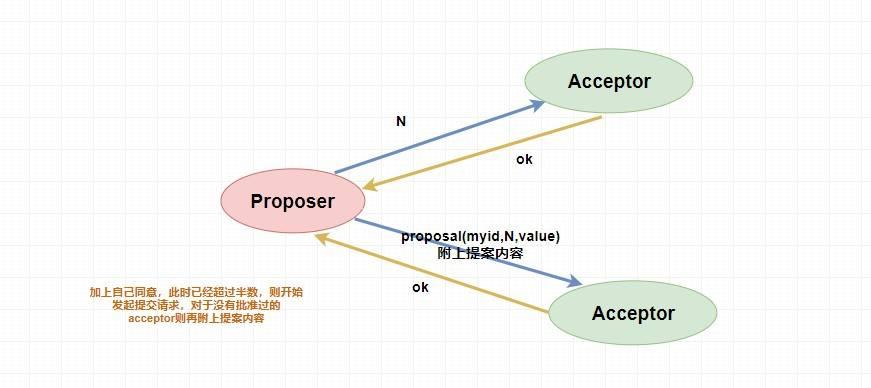
Nếu Proposer không nhận được hơn một nửa accept, nó sẽ tăng dần number của Proposal, sau đó quay lại phase Prepare.
Với
Learner, có nhiều cách để học nội dung proposal đượcAcceptorphê duyệt. Bạn có thể tự tìm hiểu; phần này không giải thích thêm.
Vấn đề vòng lặp vô hạn của algorithm Paxos
Điều này hơi giống hai người cãi nhau: Tiểu Minh nói mình đúng, Tiểu Hồng nói mình mới đúng, cả hai tranh luận mãi không ai nhường ai 🤬🤬.
Ví dụ, proposer P1 đưa ra proposal M1 và hoàn tất phase Prepare. Lúc này acceptor phê duyệt M1. Nhưng đồng thời proposer P2 cũng đưa ra proposal M2 và hoàn tất phase Prepare. Proposal P1 không thể được phê duyệt ở phase hai nữa (vì acceptor đã phê duyệt M2 lớn hơn M1), nên P1 tăng number của proposal thành M3 rồi quay lại phase Prepare. Sau đó acceptor lại phê duyệt proposal M3 mới, khiến M2 không thể được phê duyệt. M2 lại tăng number rồi quay lại phase Prepare...
Cứ như vậy, các proposal được đưa ra không ngừng. Đây là vấn đề vòng lặp vô hạn của algorithm paxos.
Giải quyết thế nào? Rất đơn giản: nhiều người thì dễ cãi nhau, vậy chỉ cho phép một người đưa ra proposal là được.
Dẫn đến ZAB
Kiến trúc Zookeeper
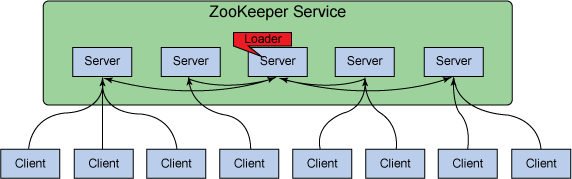
Là một framework điều phối phân tán hiệu quả, đáng tin cậy, ZooKeeper không trực tiếp dùng Paxos để giải quyết consistency dữ liệu phân tán, mà thiết kế riêng một consistency protocol có tên ZAB (ZooKeeper Atomic Broadcast), tức protocol atomic broadcast. Protocol này hỗ trợ tốt crash recovery.
Ba role trong ZAB
Tương tự khi giới thiệu Paxos, trước khi giới thiệu protocol ZAB, chúng ta tìm hiểu ba role chính trong ZAB: Leader (leader), Follower (follower), Observer (observer).
Leader: request ghi duy nhất được xử lý trong cluster, có thể khởi xướng vote (vote cũng nhằm xử lý write request).Follower: có thể nhận request từ client; nếu là read request thì tự xử lý, nếu là write request thì phải chuyển tiếp choLeader. Trong quá trình election, Follower tham gia vote và có quyền bầu cử cũng như quyền được bầu.Observer:Followerkhông có quyền bầu cử và quyền được bầu.
Trong protocol ZAB, zkServer (tên gọi chung của ba role trên) còn có hai mode: message broadcast và crash recovery.
Mode message broadcast
Nói đơn giản, đây là cách protocol ZAB xử lý write request. Ở trên ta nói chỉ Leader có thể xử lý write request, vậy Follower và Observer cũng cần đồng bộ cập nhật dữ liệu đúng không? Không thể chỉ cập nhật dữ liệu ở Leader mà các role khác không được cập nhật.
Chẳng phải là duy trì consistency dữ liệu trong toàn cluster sao? Nếu là bạn, bạn sẽ làm thế nào?
Tất nhiên bước đầu tiên là Leader phải broadcast write request, hỏi Follower có đồng ý cập nhật không. Nếu hơn một nửa đồng ý thì cập nhật Follower và Observer (giống Paxos). Nói vậy hơi trừu tượng, hãy xem hình để dễ hiểu hơn.
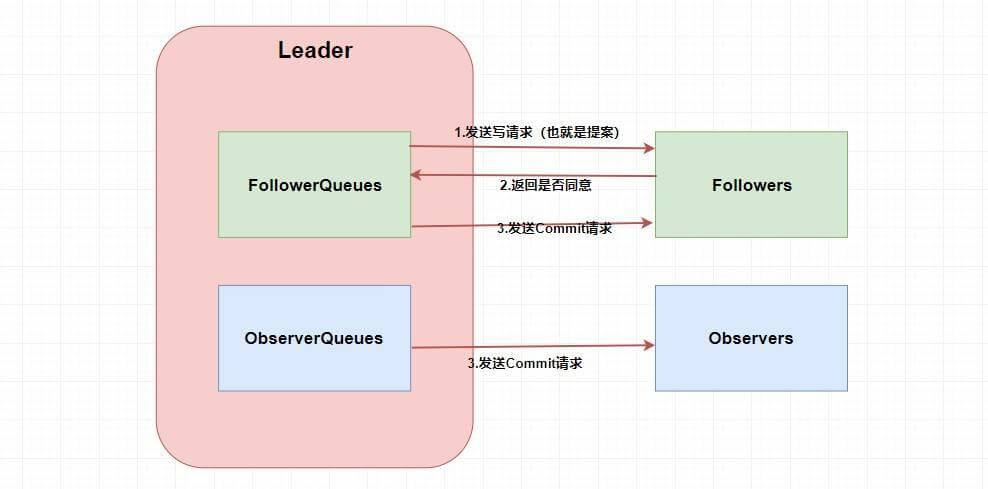
Ừm... có vẻ đơn giản, hình như hiểu rồi 🤥🤥🤥. Hai Queue này từ đâu ra? Câu trả lời là ZAB cần đảm bảo thứ tự cho Follower và Observer. Thứ tự là gì? Giả sử có write request A, Leader broadcast request A. Vì chỉ cần một nửa đồng ý, có thể một Follower F1 chưa nhận được A do vấn đề mạng. Sau đó Leader broadcast request B; do vấn đề mạng, F1 lại nhận B trước rồi mới nhận A. Khi thứ tự xử lý request khác nhau, dữ liệu sẽ khác nhau và phát sinh vấn đề consistency dữ liệu.
Vì vậy, ở phía Leader, nó chuẩn bị một queue cho mỗi zkServer khác và gửi message theo cơ chế FIFO. Do protocol dùng TCP để giao tiếp mạng, thứ tự gửi message được đảm bảo, nên thứ tự nhận cũng được đảm bảo.
Ngoài ra, ZAB còn định nghĩa một transaction ID ZXID tăng đơn điệu trên toàn cục. Đây là kiểu long 64-bit: 32 bit cao biểu thị epoch, 32 bit thấp biểu thị transaction id. epoch thay đổi theo Leader; khi một Leader dừng và Leader mới lên thay, epoch cũng thay đổi. Có thể hiểu đơn giản 32 bit thấp là transaction id tăng dần.
Mục đích của định nghĩa này cũng là đảm bảo thứ tự. Sau khi mỗi proposal được tạo ở Leader, nó cần được sắp xếp theo ZXID rồi mới xử lý.
Mode crash recovery
Khi nói về crash recovery, trước hết phải nhắc đến algorithm election Leader trong ZAB. Khi hệ thống gặp sự cố, sự cố của Leader gây ảnh hưởng lớn nhất vì chỉ có một Leader. Do đó, khi Leader gặp vấn đề, chắc chắn cần election lại Leader.
Leader election có thể chia thành hai phase. Phase thứ nhất là election lại khi Leader dừng; phase thứ hai là election khởi tạo Leader khi ZooKeeper khởi động. Trước hết hãy xem ZAB thực hiện election khởi tạo thế nào.
Giả sử cluster có 3 máy, nghĩa là cần ít nhất hai máy đồng ý (hơn một nửa). Khi server1 khởi động, nó vote cho chính mình trước. Nội dung vote là myid và ZXID của server. Vì là khởi tạo nên ZXID đều bằng 0, vote của server1 là (1,0). Nhưng vote của server1 chỉ có 1 nên chưa thể trở thành Leader. Vì vẫn đang election nên toàn cluster ở trạng thái Looking.
Tiếp đó server2 khởi động, nó cũng vote cho chính mình (2,0) trước rồi broadcast thông tin vote (server1 cũng broadcast, chỉ là lúc đó chưa có server khác). Sau khi nhận vote của server2, server1 so sánh vote đó với vote của mình. Trước hết so sánh ZXID: ZXID lớn hơn được ưu tiên làm Leader; nếu bằng nhau thì so sánh myid, myid lớn hơn được ưu tiên. Vì vậy server1 nhận thấy server2 phù hợp làm Leader hơn, đổi vote của mình thành (2,0) rồi broadcast. Sau đó server2 nhận được và thấy giống vote của mình nên không cần đổi. Vì vote đã vượt quá một nửa, server2 được xác định là Leader. server1 cũng chuyển server của mình sang trạng thái Following, trở thành Follower. Toàn server chuyển từ Looking sang trạng thái bình thường.
Khi server3 khởi động và phát hiện cluster không ở trạng thái Looking, nó sẽ trực tiếp tham gia cluster với tư cách Follower.
Vẫn với ví dụ ba server trên, nếu server2 dừng trong lúc cluster đang chạy, cluster sẽ election lại Leader thế nào? Thực ra gần giống election khởi tạo.
Trước hết, không cần nói cũng biết hai Follower còn lại sẽ chuyển trạng thái từ Following sang Looking. Sau đó mỗi server, giống lúc vote khởi tạo, trước tiên vote cho chính mình (nhưng zxid lúc này có thể không còn là 0; để tiện, lấy một số bất kỳ).
Giả sử server1 vote cho mình là (1,99), rồi broadcast cho các server khác. server3 cũng vote cho mình là (3,95), rồi broadcast cho các server khác. Lúc này server1 và server3 nhận vote của nhau, giống election ban đầu, chúng so sánh vote của mình với vote nhận được (zxid lớn hơn được ưu tiên; nếu bằng nhau thì myid lớn hơn được ưu tiên). server1 nhận vote của server3 và thấy vote của mình phù hợp hơn nên không đổi. server3 nhận kết quả vote của server1, thấy vote đó phù hợp hơn nên đổi thành (1,99) rồi broadcast. Cuối cùng server1 nhận được và thấy vote của mình đã vượt quá một nửa, nên đặt mình làm Leader; server3 theo đó trở thành Follower.
Lưu ý vì sao
ZooKeeperdùng số node lẻ. Ví dụ ở đây có ba node: dừng một node vẫn hoạt động bình thường, dừng hai node thì không thể hoạt động bình thường (không còn hơn một nửa node để vote và thực hiện các operation). Nếu có bốn node, dừng một node vẫn hoạt động, nhưng dừng hai node cũng không hoạt động bình thường. Khả năng này giống ba node, trong khi ba node ít hơn bốn node một node nhưng hiệu quả tương đương. Vì vậyZooKeeperkhuyến nghị sốserverlẻ.
Sau khi tìm hiểu cách Leader election trong ZAB, hãy xem crash recovery là gì.
Chủ yếu là: khi một máy trong cluster dừng, toàn cluster đảm bảo consistency dữ liệu thế nào?
Nếu chỉ Follower dừng và số Follower dừng không vượt quá một nửa, vì như đã nói ở đầu, Leader duy trì queue nên không cần lo dữ liệu phía sau không được nhận dẫn đến inconsistency.
Nếu Leader dừng thì phức tạp hơn. Trước hết phải tạm dừng service, chuyển sang trạng thái Looking, rồi election lại Leader (đã nói ở trên). Việc này có hai trường hợp: đảm bảo proposal đã được Leader commit cuối cùng có thể được tất cả Follower commit và bỏ qua các proposal đã bị loại bỏ.
Đảm bảo proposal đã được Leader commit cuối cùng có thể được tất cả Follower commit nghĩa là gì?
Giả sử Leader (server2) gửi yêu cầu commit (nếu quên, xem mode message broadcast ở trên), gửi cho server3, rồi đột nhiên dừng khi chuẩn bị gửi cho server1. Nếu lúc election lại chúng ta chọn server1 làm Leader, chắc chắn sẽ có inconsistency dữ liệu vì server3 sẽ commit proposal của yêu cầu commit mà server2 vừa gửi, còn server1 chưa nhận nên sẽ loại bỏ proposal đó.
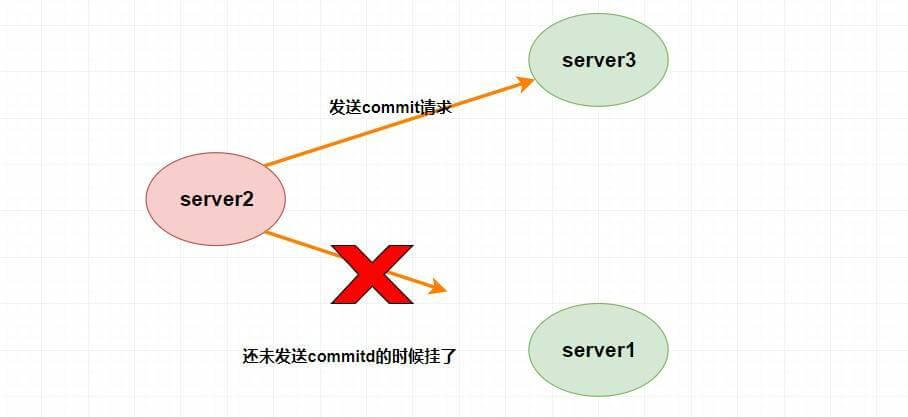
Giải quyết thế nào?
Bạn tinh ý chắc chắn sẽ đặt câu hỏi: lúc này server1 không thể trở thành Leader nữa, vì khi server1 và server3 vote election, chúng sẽ so sánh ZXID, mà ZXID của server3 chắc chắn lớn hơn server1 (nếu chưa hiểu, xem algorithm election ở trên).
Vậy bỏ qua các proposal đã bị loại bỏ nghĩa là gì?
Giả sử Leader (server2) đồng ý proposal N1, tự commit transaction này và chuẩn bị gửi yêu cầu commit cho tất cả Follower, nhưng lại dừng đúng lúc đó. Khi ấy chắc chắn phải election lại Leader, chẳng hạn chọn server1 làm Leader (chọn ai cũng được). Một lúc sau, Leader đã dừng lại khôi phục, nó sẽ tham gia cluster với tư cách Follower. Cần lưu ý server2 vừa đồng ý commit proposal N1, nhưng các server khác chưa nhận thông tin commit, nên các server khác không thể commit proposal N1 nữa. Điều này gây inconsistency dữ liệu, vì vậy proposal N1 cuối cùng phải bị loại bỏ.

Một số kiến thức lý thuyết về Zookeeper
Hiểu protocol ZAB vẫn chưa đủ. Đây chỉ là một cách triển khai bên trong ZooKeeper. Vậy dùng ZooKeeper để xây dựng các trường hợp sử dụng điển hình như quản lý cluster, distributed lock, election Master, v.v. thế nào?
Điều này liên quan đến cách sử dụng ZooKeeper. Nhưng trước khi sử dụng, chúng ta còn cần nắm một số khái niệm như data model, session mechanism, ACL, Watcher mechanism, v.v.
Data model
Cấu trúc lưu trữ dữ liệu của ZooKeeper rất giống Unix file system chuẩn: dưới root node có nhiều sub-node (dạng tree). Tuy nhiên, ZooKeeper không có khái niệm directory và file như file system, mà dùng znode làm data node. znode là đơn vị dữ liệu nhỏ nhất trong ZooKeeper; mỗi znode có thể lưu dữ liệu và gắn sub-node, tạo thành một namespace dạng tree.
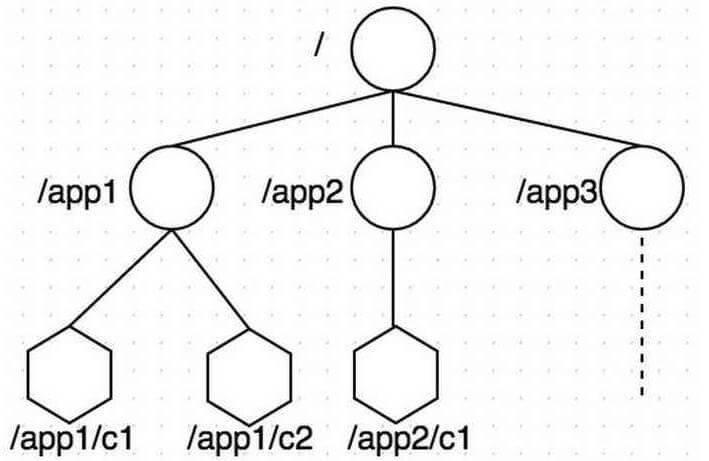
Mỗi znode có node type và node state riêng.
Node type gồm persistent node, persistent sequential node, ephemeral node và ephemeral sequential node.
- Persistent node: sau khi tạo sẽ tồn tại mãi cho đến khi bị xóa.
- Persistent sequential node: parent node có thể duy trì thứ tự tạo của các child node. Thứ tự này thể hiện trong tên node: phía sau tên node tự động thêm một chuỗi số gồm 10 chữ số, bắt đầu đếm từ 0.
- Ephemeral node: vòng đời của ephemeral node gắn với client session; session biến mất thì node cũng biến mất. Ephemeral node chỉ có thể là leaf node, không thể tạo child node.
- Ephemeral sequential node: parent node có thể tạo ephemeral node có duy trì thứ tự (giống persistent sequential node ở trên).
Node state chứa nhiều thuộc tính như czxid, mzxid, v.v. Trong ZooKeeper, class Stat dùng để quản lý chúng. Dưới đây là một số thuộc tính.
czxid:Created ZXID, transaction ID khi data node được tạo.mzxid:Modified ZXID, transaction ID khi node được update lần cuối.ctime:Created Time, thời điểm node được tạo.mtime:Modified Time, thời điểm node được sửa lần cuối.version: version của node.cversion: version của child node.aversion: versionACLcủa node.ephemeralOwner:sessionIDcủa session tạo node; nếu là persistent node thì giá trị bằng 0.dataLength: độ dài nội dung dữ liệu của node.numChildre: số child node của node; nếu là ephemeral node thì bằng 0.pzxid: transaction ID khi danh sách child node của node được sửa lần cuối. Lưu ý đây là list child node, không phải nội dung.
Session
Các bạn làm backend chắc chắn không xa lạ với khái niệm này, chẳng phải là session sao? Chỉ là client và server của zk duy trì session mechanism thông qua kết nối dài TCP. Với session, có thể hiểu là duy trì trạng thái kết nối.
Trong ZooKeeper, session còn có các event tương ứng như CONNECTION_LOSS (event mất kết nối), SESSION_MOVED (event chuyển session), SESSION_EXPIRED (event session hết hạn).
ACL
ACL là viết tắt của Access Control Lists, một cơ chế access control. ZooKeeper định nghĩa 5 permission:
CREATE: permission tạo child node.READ: permission lấy dữ liệu node và danh sách child node.WRITE: permission update dữ liệu node.DELETE: permission xóa child node.ADMIN: permission thiết lập ACL của node.
Cơ chế Watcher
Watcher là event listener, một feature rất quan trọng của zk; nhiều chức năng phụ thuộc vào nó. Cơ chế này hơi giống subscription: client register watcher được chỉ định với server. Khi server có event hoặc điều kiện phù hợp với watcher, server gửi event notification cho client. Sau khi nhận notification, client tìm Watcher do mình định nghĩa rồi thực thi callback method tương ứng.

Một số trường hợp sử dụng điển hình của Zookeeper
Nãy giờ nói nhiều lý thuyết như vậy, có thể bạn vẫn chưa hiểu gì: những thứ này dùng để làm gì? Có thể làm được gì? Đừng vội, hãy xem tiếp.
Bầu chọn leader
Còn nhớ ephemeral node ở trên không? Nhờ consistency mạnh của ZooKeeper, nó có thể đảm bảo tính duy nhất toàn cục khi tạo node trong điều kiện concurrency cao (không thể tạo trùng cùng một node).
Dựa vào feature này, chúng ta có thể cho nhiều client cùng tạo một node được chỉ định; client tạo thành công sẽ là master.
Nhưng nếu master dừng thì sao?
Hãy nghĩ xem tại sao cần tạo ephemeral node. Còn nhớ vòng đời của ephemeral node không? master dừng có phải session bị ngắt không? Session bị ngắt có phải node biến mất không? Còn nhớ watcher không? Chúng ta có thể cho các node không phải master theo dõi state của node, chẳng hạn theo dõi parent node của ephemeral node. Nếu số child node thay đổi, nghĩa là master đã dừng; lúc này trigger callback function để election lại, hoặc theo dõi trực tiếp state của node và dựa vào việc node còn kết nối hay không để phán đoán master đã dừng.
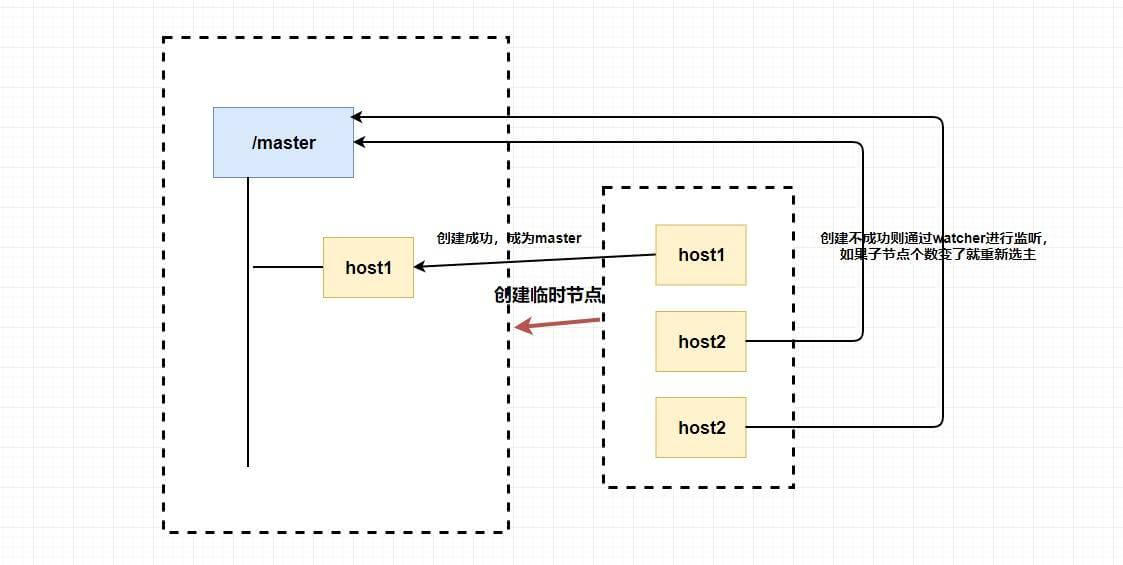
Tóm lại, có thể dùng ephemeral node, node state và watcher để xây dựng chức năng election leader. Ephemeral node dùng cho election, còn node state và watcher dùng để kiểm tra liveness của master và election lại.
Data publish/subscribe
Còn nhớ cơ chế Watcher của ZooKeeper không? ZooKeeper dùng cách kết hợp push và pull để tương tác giữa client và server: client register node với server. Khi dữ liệu của node tương ứng thay đổi, server gửi Watcher event notification cho client đang “theo dõi” node đó. Sau khi nhận notification, client cần chủ động lấy dữ liệu mới nhất từ server. Dựa trên cách này, ZooKeeper triển khai chức năng data publish/subscribe.
Một trường hợp sử dụng điển hình là quản lý tập trung global configuration. Khi khởi động, client chủ động lấy configuration từ server ZooKeeper, đồng thời register một Watcher để theo dõi node được chỉ định. Khi configuration thay đổi, server thông báo cho tất cả client subscriber lấy lại configuration, thực hiện cập nhật configuration theo thời gian thực.
Global configuration nói trên thường gồm thông tin danh sách máy, runtime switch configuration, database configuration, v.v. Cần lưu ý các global configuration này thường có các đặc điểm:
- Dung lượng dữ liệu nhỏ
- Nội dung dữ liệu thay đổi động trong runtime
- Các máy trong cluster dùng chung configuration nhất quán
Load balancing
Có thể dùng ephemeral node của ZooKeeper để thực hiện load balancing. Nhắc lại đặc điểm của ephemeral node: khi client tạo node mất kết nối với server, tức client session biến mất, node tương ứng cũng tự động biến mất. Vì vậy, có thể dùng ephemeral node để duy trì danh sách địa chỉ của Server, đảm bảo request không được phân phối đến service đã dừng.
Cụ thể, cần dùng client ZooKeeper kết nối đến server ZooKeeper trên mỗi Server trong cluster, đồng thời dùng thông tin địa chỉ của chính Server để tạo ephemeral node trong directory được chỉ định trên server. Khi client request gọi cluster service, trước hết lấy danh sách node trong directory đó từ ZooKeeper (tức tất cả Server khả dụng), sau đó dựa trên strategy load balancing khác nhau để chuyển tiếp request đến một Server cụ thể.
Distributed lock
Có nhiều cách triển khai distributed lock, chẳng hạn Redis, database, ZooKeeper, v.v. Theo tôi, ZooKeeper rất đơn giản để triển khai distributed lock.
Ở trên đã đề cập zk đảm bảo tính duy nhất toàn cục khi tạo node trong điều kiện concurrency cao. Nhìn là biết feature này dùng để làm gì: triển khai mutual exclusion lock. Vì hoạt động trong môi trường phân tán, nó có thể triển khai distributed lock.
Triển khai thế nào? Thực ra gần giống leader election; có thể dùng việc tạo ephemeral node để triển khai.
Trước hết là cách lấy lock. Vì node có tính duy nhất, có thể cho nhiều client cùng tạo một ephemeral node; client tạo thành công nghĩa là đã lấy được lock. Client chưa lấy được lock cũng giống non-master node trong leader election ở trên: tạo một watcher để theo dõi node state. Khi mutual exclusion lock được giải phóng (có thể client giữ lock dừng hoặc chủ động giải phóng lock), callback function có thể được gọi để lấy lock lại.
Trong
zk, không cần nhưredisphải lo lock không được giải phóng, vì khi client dừng, node cũng dừng và lock cũng được giải phóng. Rất đơn giản đúng không?
Vậy có thể dùng ZooKeeper để đồng thời triển khai shared lock và exclusive lock không? Có, chỉ là hơi phức tạp hơn.
Còn nhớ sequential node không?
Lúc này quy định tất cả node tạo ra phải có thứ tự. Nếu là read request (cần lấy shared lock), khi không có node nào nhỏ hơn nó, hoặc các node nhỏ hơn đều là read request, client có thể lấy read lock rồi bắt đầu đọc. Nếu trong các node nhỏ hơn có write request, client hiện tại chưa thể lấy read lock, chỉ có thể chờ write request phía trước hoàn tất.
Nếu là write request (lấy exclusive lock), khi không có node nào nhỏ hơn nó, client hiện tại có thể trực tiếp lấy write lock để sửa dữ liệu. Nếu phát hiện có node nhỏ hơn mình, bất kể là read operation hay write operation, client hiện tại đều không thể lấy write lock, phải chờ tất cả operation phía trước hoàn tất.
Như vậy có thể triển khai shared lock và exclusive lock cùng lúc. Dĩ nhiên vẫn có chỗ tối ưu, chẳng hạn khi một lock được giải phóng, nó thông báo cho tất cả client đang chờ, gây ra hiệu ứng bầy đàn. Lúc này có thể cho node đang chờ chỉ theo dõi node ngay trước nó.
Cụ thể làm thế nào? Rất đơn giản: read request theo dõi node write request cuối cùng nhỏ hơn nó; write request chỉ theo dõi node cuối cùng nhỏ hơn nó. Nếu quan tâm, bạn có thể tự tìm hiểu.
Naming service
Khi cần đặt ID cho một object, có lẽ mọi người sẽ nghĩ đến UUID. Nhưng vấn đề lớn nhất của UUID là nó quá dài... (dài không nhất thiết là tốt, hehe). Vậy trong điều kiện cho phép, có thể dùng ZooKeeper để triển khai không?
Ở trên đã nói ZooKeeper lưu data node bằng cấu trúc dạng tree. Điều đó có nghĩa là full path của mỗi node chắc chắn là duy nhất, nên có thể dùng full path của node làm naming. Quan trọng hơn, path do chúng ta tự định nghĩa, giúp việc đặt ID cho một số object có ngữ nghĩa dễ hiểu hơn.
Cluster management và service registry
Đọc đến đây, có phải bạn thấy ZooKeeper thật mạnh mẽ, việc gì cũng làm được!
Đừng vội, nó còn làm được nhiều việc khác. Có thể chúng ta có nhu cầu biết toàn cluster đang có bao nhiêu máy hoạt động, thu thập runtime state của từng máy trong cluster, thực hiện thao tác đưa máy lên hoặc xuống, v.v.
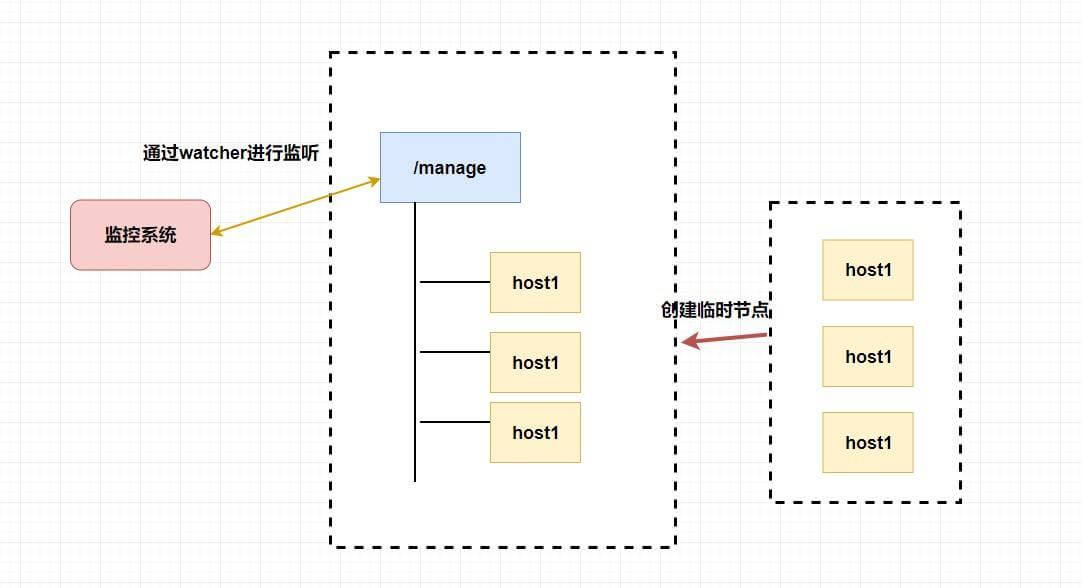
Watcher và ephemeral node được ZooKeeper hỗ trợ tự nhiên có thể đáp ứng tốt các nhu cầu này. Có thể tạo ephemeral node cho từng máy và theo dõi parent node của nó. Nếu danh sách child node thay đổi (có thể ephemeral node được tạo hoặc xóa), có thể dùng watcher gắn trên parent node để theo dõi state và callback.
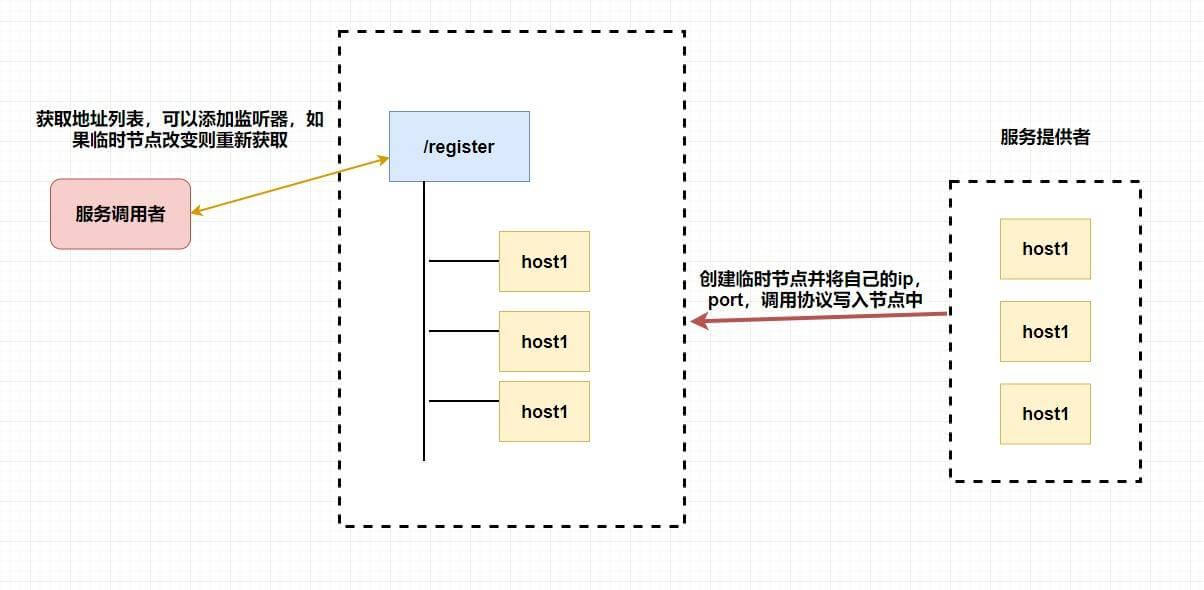
Service registry cũng đơn giản. Tương tự, service provider tạo một ephemeral node trong ZooKeeper và ghi ip, port, cách gọi của mình vào node. Khi service consumer cần gọi, nó tìm danh sách địa chỉ service tương ứng qua service registry (IP, port, v.v.), rồi cache vào local (để tiện gọi lần sau). Khi consumer gọi service, nó không request service registry nữa mà lấy một service provider từ danh sách địa chỉ bằng algorithm load balancing rồi gọi service trên server đó.
Khi một server của service provider dừng hoặc offline, địa chỉ tương ứng sẽ bị xóa khỏi danh sách địa chỉ service provider. Đồng thời, service registry gửi danh sách địa chỉ mới cho máy service consumer và cache tại máy consumer (dĩ nhiên có thể cho consumer theo dõi node; tôi nhớ Eureka sẽ thử lỗi trước rồi mới cập nhật).
Tổng kết
Bạn đọc đến đây thật kiên nhẫn 👍👍👍 Không biết mọi người còn nhớ tôi đã nói gì không 😒.
Trong bài viết này, tôi đã giúp bạn nhập môn framework điều phối phân tán mạnh mẽ ZooKeeper. Bây giờ hãy cùng tóm tắt nội dung toàn bài.
Khác biệt giữa hệ thống phân tán và cluster
Nguyên lý và cách triển khai các consistency framework như
2PC,3PCvà algorithmPaxos.Nội dung protocol atomic broadcast
ZAB, consistency algorithm riêng củaZooKeeper(Leaderelection, crash recovery, message broadcast).Một số khái niệm cơ bản trong
ZooKeepernhưACL, data node, session, cơ chếWatcher, v.v.Các trường hợp sử dụng điển hình của
ZooKeepernhư leader election, service registry, v.v.Nếu quên, bạn có thể quay lại xem để hiểu thêm. Nếu có thắc mắc hoặc góp ý, hãy chia sẻ 🤝🤝🤝.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.