
Tổng hợp giải pháp lọc từ nhạy cảm
Lọc từ nhạy cảm là khâu cốt lõi của content safety. Dù là social media, nền tảng e-commerce, game online hay các ứng dụng AI hiện nay, đều cần lọc realtime nội dung đầu vào và nội dung được tạo ra để ngăn nội dung vi phạm như nội dung khiêu dâm, bạo lực và phát ngôn thù ghét lan truyền.
Về mặt kỹ thuật, lọc từ nhạy cảm về bản chất là bài toán multi-pattern string matching: đồng thời tìm nhiều keyword trong một đoạn text.
Bài viết này dài gần 20.000 chữ. Tôi sẽ bắt đầu từ quá trình phát triển của các algorithm, đồng thời chia sẻ một số kinh nghiệm production như đối phó với từ biến thể, tối ưu high concurrency và quản lý word list.
Kết luận cốt lõi:
| Algorithm | Trường hợp sử dụng | Đặc điểm |
|---|---|---|
| Trie tree | Word list nhỏ (< 10.000) | Dễ triển khai, dễ hiểu |
| AC automaton | Trường hợp throughput cao | Quét một lần, match mọi từ, hiệu năng tốt nhất |
| Double-Array Trie (DAT) | Word list lớn (> 10.000) | Tốn ít memory, chi phí xây dựng cao |
Quá trình phát triển của algorithm
Dưới đây là phần giới thiệu từng loại algorithm lọc từ nhạy cảm theo thứ tự từ đơn giản đến phức tạp, để thấy động lực và hiệu quả của mỗi bước tối ưu.
Brute-force matching (BF algorithm)
Brute-force matching (Brute Force) là giải pháp trực quan nhất: duyệt từng vị trí trong text, thử match bằng từng từ nhạy cảm.
Giả sử word list có n từ, độ dài trung bình là m, độ dài text cần match là L:
public List<String> bruteForceMatch(String text, List<String> words) {
    List<String> result = new ArrayList<>();
    for (String word : words) {              // O(n): duyệt từng từ nhạy cảm
        if (text.contains(word)) {           // O(L × m): naive substring matching
            result.add(word);
        }
    }
    return result;
}
Độ phức tạp thời gian: O(n × L × m)
| Trường hợp | Số từ nhạy cảm | Độ dài text | Độ dài từ trung bình | Số phép tính |
|---|---|---|---|---|
| Quy mô nhỏ | 100 | 1000 | 5 | 500.000 |
| Quy mô vừa | 1000 | 5000 | 5 | 25 triệu |
| Quy mô lớn | 10000 | 10000 | 5 | 500 triệu |
Phân tích vấn đề:
- Quét lặp lại: mỗi từ nhạy cảm đều phải duyệt toàn bộ text, khiến nhiều character bị so sánh lặp lại.
- Không tái sử dụng state: các từ nhạy cảm không liên quan với nhau, không thể tận dụng thông tin đã match.
- Khả năng mở rộng kém: hiệu năng giảm tuyến tính khi word list tăng.
Khi word list đạt quy mô hàng chục nghìn từ, latency của brute-force matching sẽ đạt mức giây, hoàn toàn không đáp ứng được yêu cầu hiệu năng của service online.
Trie tree: giảm so sánh bằng prefix
Trie tree (phát âm là /ˈtraɪ/), còn gọi là dictionary tree hoặc prefix tree, tối ưu brute-force matching bằng chiến lược đổi space lấy time. Ý tưởng cốt lõi là tận dụng common prefix của các string để giảm chi phí lưu trữ và query.
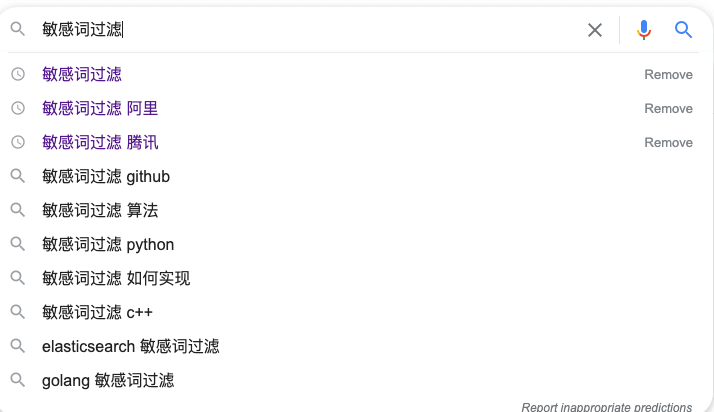
Tính năng gợi ý keyword của ô tìm kiếm trên browser có thể được triển khai dựa trên Trie tree:
Tính chất cơ bản
Trie tree có 3 tính chất cơ bản sau:
- Root node không chứa character; ngoài root node, mỗi node chỉ chứa một character.
- Từ root node đến một node bất kỳ, các character trên path ghép lại chính là string tương ứng với node đó.
- Các child node của mỗi node không chứa character trùng nhau.
Ví dụ cấu trúc
Giả sử word list có các từ sau:
- video HD
- video HD CV
- Hà Nội lạnh
- Hà Nội nóng
Cấu trúc Trie tree được xây dựng như sau (node màu đỏ biểu thị kết thúc string):
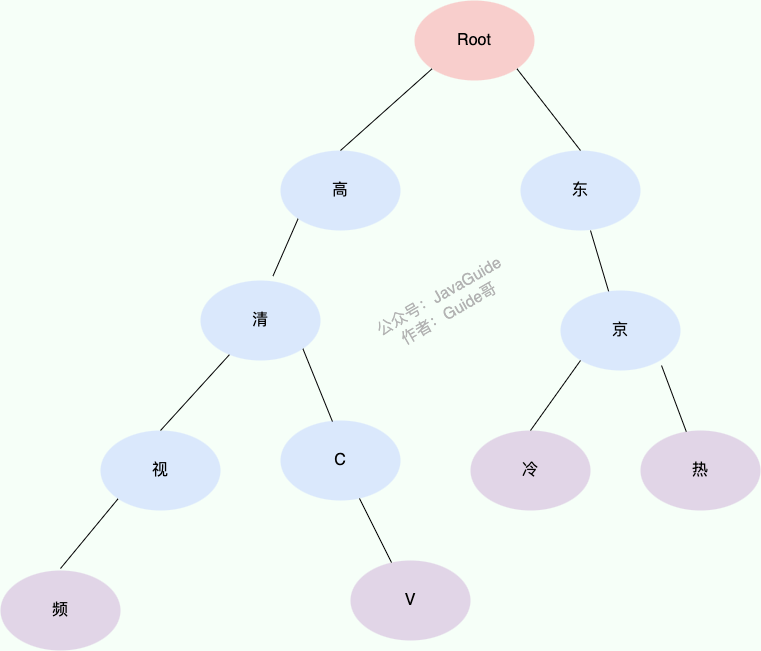
Khi tìm string “Hà Nội nóng”, tách string này thành các character “Hà”, “Nội”, “nóng”, sau đó match từng tầng từ root node.
So sánh với brute-force matching
Giả sử word list là ["she", "he", "his", "hers"], cần tìm trong text "ushers":
| Algorithm | Quá trình match | Số lần so sánh character |
|---|---|---|
| Brute-force matching | Dùng lần lượt 4 từ để quét text | Khoảng 24 lần¹ |
| Trie tree | Bắt đầu từ mỗi vị trí, match theo tree | Khoảng 10 lần |
¹ Đây là ước tính đơn giản (số từ × độ dài text); số lần so sánh tệ nhất thực tế phụ thuộc vào độ dài từng từ và vị trí trong text, có thể cao hơn.
Ưu thế của Trie tree là: mọi từ nhạy cảm dùng chung một tree, chỉ cần duyệt một lần là có thể thử match mọi từ.
Phân tích độ phức tạp
| Chỉ số | Triển khai bằng HashMap | Triển khai bằng array |
|---|---|---|
| Preprocessing | O(n × m) | O(n × m × σ) |
| Query time | O(L × m) | O(L × m) |
| Space complexity | O(n × m) | O(n × m × σ) |
σ là kích thước character set (khoảng 20.000 Chinese character, ASCII chỉ có 128). Ví dụ code trong bài dùng triển khai
HashMap, phù hợp với character set lớn như tiếng Việt; triển khai bằng array phù hợp với character set nhỏ (chẳng hạn chỉ English).
Ví dụ code Trie
public class SimpleTrie {
    private static class Node {
        Map<Character, Node> children = new HashMap<>();
        boolean isEnd;
    }

    private final Node root = new Node();

    // Thêm từ nhạy cảm
    public void addWord(String word) {
        Node node = root;
        for (char c : word.toCharArray()) {
            node = node.children.computeIfAbsent(c, k -> new Node());
        }
        node.isEnd = true;
    }

    // Kiểm tra text có chứa từ nhạy cảm hay không
    public boolean contains(String text) {
        for (int i = 0; i < text.length(); i++) {
            Node node = root;
            for (int j = i; j < text.length(); j++) {
                node = node.children.get(text.charAt(j));
                if (node == null) break;
                if (node.isEnd) return true;
            }
        }
        return false;
    }

    // Lấy tất cả từ nhạy cảm đã match trong text
    public List<String> matchAll(String text) {
        List<String> result = new ArrayList<>();
        for (int i = 0; i < text.length(); i++) {
            Node node = root;
            for (int j = i; j < text.length(); j++) {
                node = node.children.get(text.charAt(j));
                if (node == null) break;
                if (node.isEnd) {
                    result.add(text.substring(i, j + 1));
                }
            }
        }
        return result;
    }
}
Hạn chế của Trie tree
Mặc dù Trie tree cải thiện đáng kể so với brute-force matching, nó vẫn có vấn đề backtracking:
Tìm word list ["she", "he", "his"] trong text "ushers":
- Bắt đầu từ vị trí 1, match
"s" → "h" → "e", tìm thấy"she". - Sau khi match xong, quay lại vị trí 2, match lại
"h" → "e", tìm thấy"he".
Chiến lược “sau khi match thất bại thì lùi về vị trí tiếp theo để bắt đầu lại” sẽ suy biến thành O(L × m) trong trường hợp tệ nhất (chẳng hạn text "aaaaaaaa" match word "aaaaab").
Có thể hoàn toàn không backtrack hay không? Đây là lý do AC automaton ra đời.
Lưu ý: Apache Commons Collections cung cấp PatriciaTrie, một compressed binary Trie dựa trên bit operation (PATRICIA = Practical Algorithm To Retrieve Information Coded In Alphanumeric), khác với nguyên lý character-level Trie được mô tả trong bài và không phù hợp để dùng trực tiếp cho trường hợp lọc từ nhạy cảm tiếng Việt.
AC automaton: quét một lần để match mọi từ
AC automaton (Aho-Corasick Automaton) là một algorithm multi-pattern matching được xây dựng trên Trie tree, do Alfred V. Aho và Margaret J. Corasick của Bell Labs đề xuất năm 1975.
Ý tưởng cốt lõi của nó kế thừa từ thuật toán KMP: tận dụng thông tin đã match, khi mismatch thì chuyển đến vị trí thích hợp để tiếp tục match, tránh backtracking. Khác biệt là KMP xử lý single-pattern string, còn AC automaton xử lý multi-pattern string.
Component cốt lõi
AC automaton vận hành dựa trên ba function cốt lõi:
| Function | Tác dụng |
|---|---|
| goto function | State transition: sau khi đọc character từ state hiện tại thì chuyển đến state nào |
| failure function | Chuyển khi mismatch: khi mismatch thì chuyển đến state có “longest common suffix”, tránh backtracking |
| output function | Output match: ghi lại tập từ match tương ứng với mỗi state |
Các bước xây dựng
Việc xây dựng AC automaton gồm ba bước:
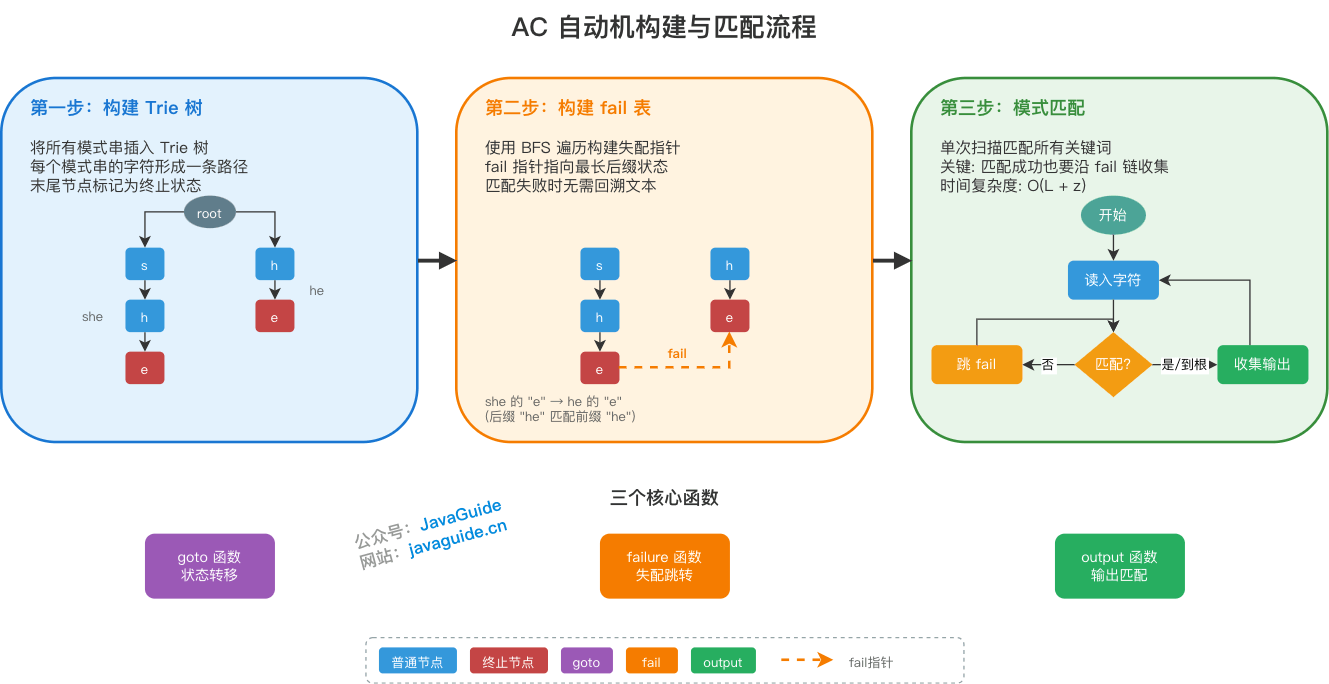
Bước 1: Xây dựng Trie tree
Insert toàn bộ pattern string vào Trie tree để tạo skeleton nền tảng của automaton. Node cuối mỗi pattern string được đánh dấu kết thúc.
Bước 2: Xây dựng fail pointer (cốt lõi)
Fail pointer là cơ chế cốt lõi của AC automaton. Tác dụng của nó là: khi character hiện tại không thể tiếp tục match, chuyển đến state nào để tiếp tục thử, thay vì quay về điểm bắt đầu.
Quá trình xây dựng dùng BFS (breadth-first search) để duyệt từng tầng. Với node hiện tại temp:
- Tìm fail node của parent node của
temp. - Tìm trong child node của fail node đó node có character giống
temp. - Nếu tồn tại, cho
temp.failtrỏ đến child node đó. - Nếu không tồn tại, tiếp tục tìm fail node của fail node, cho đến khi tìm thấy hoặc đến
root.
Bản chất của fail pointer: trỏ đến state chứa longest suffix của string tương ứng với state hiện tại.
Quan hệ với KMP
Fail pointer là sự tổng quát hóa của next array trong KMP algorithm trên Trie tree. Ví dụ: suffix "she" là "he" có prefix giống "he", nên fail pointer của 'e' ở cuối "she" trỏ đến 'e' trong "he".
Bước 3: Pattern matching
Bắt đầu quét từ đầu text string, pointer p ban đầu trỏ đến root:
- State transition: nếu character hiện tại nằm trong child node của
p,pđi xuống; nếu không, đi lùi theo fail chain cho đến khi match được hoặc quay vềroot. - Thu thập output: 【điểm quan trọng】 sau mỗi transition, bắt buộc duyệt fail chain một lần, thu thập từ match của mọi termination state.
Vì sao phải duyệt fail chain? Vì suffix của một từ dài có thể là một từ ngắn khác. Ví dụ khi match thành công "she", có thể tìm thấy "he" theo fail chain; nếu không sẽ bỏ sót từ lồng nhau.
Ví dụ code AC automaton
public class AhoCorasickAutomaton {
    private static class Node {
        Map<Character, Node> children = new HashMap<>();
        Node fail;                    // Fail pointer
        List<String> outputs = new ArrayList<>(); // Từ match tương ứng với state này
    }

    private final Node root = new Node();

    // Bước 1: xây dựng Trie tree
    public void addWord(String word) {
        Node node = root;
        for (char c : word.toCharArray()) {
            node = node.children.computeIfAbsent(c, k -> new Node());
        }
        node.outputs.add(word); // Node cuối ghi lại từ match
    }

    // Bước 2: xây dựng fail pointer (BFS)
    public void buildFailPointer() {
        Queue<Node> queue = new LinkedList<>();
        root.fail = root;

        // Child node trực tiếp của root có fail trỏ đến root
        for (Node child : root.children.values()) {
            child.fail = root;
            queue.offer(child);
        }

        while (!queue.isEmpty()) {
            Node current = queue.poll();
            for (Map.Entry<Character, Node> entry : current.children.entrySet()) {
                char c = entry.getKey();
                Node child = entry.getValue();

                // Tìm transition của character c dọc theo fail chain của parent node
                Node fail = current.fail;
                while (fail != root && !fail.children.containsKey(c)) {
                    fail = fail.fail;
                }
                child.fail = fail.children.getOrDefault(c, root);
                // Tránh self-loop: nếu fail trỏ đến chính nó thì đổi thành root
                if (child.fail == child) {
                    child.fail = root;
                }
                // Gộp output của fail node (quan trọng!)
                child.outputs.addAll(child.fail.outputs);
                queue.offer(child);
            }
        }
    }

    // Bước 3: pattern matching (quét một lần)
    public List<String> match(String text) {
        List<String> result = new ArrayList<>();
        Node state = root;

        for (int i = 0; i < text.length(); i++) {
            char c = text.charAt(i);
            // Đi dọc fail chain để tìm state có thể xử lý character c
            while (state != root && !state.children.containsKey(c)) {
                state = state.fail;
            }
            state = state.children.getOrDefault(c, root);
            // Thu thập mọi từ match ở state hiện tại (đã gộp qua fail chain)
            result.addAll(state.outputs);
        }
        return result;
    }
}
Ví dụ sử dụng:
AhoCorasickAutomaton ac = new AhoCorasickAutomaton();
ac.addWord("she");
ac.addWord("he");
ac.addWord("her");
ac.addWord("hers");
ac.buildFailPointer(); // Xây dựng fail pointer một lần sau khi insert mọi từ

List<String> matches = ac.match("ushers");
// Output: [she, he, her, hers]
So sánh hiệu năng
| Algorithm | Preprocessing | Match time | Đặc điểm |
|---|---|---|---|
| Brute-force matching | O(1) | O(L × n × m) | Quét riêng từng từ |
| Trie tree | O(n × m) | O(L × m) | Có thể backtrack |
| AC automaton | O(n × m)¹ | O(L + z) | Quét một lần, z là tổng số lần match (bao gồm overlap match)² |
- Khi dùng HashMap để lưu child node là O(n × m); nếu dùng array (cần pre-allocate character set size σ) thì là O(n × m × σ).
- Trong trường hợp cực đoan, nếu word list có nhiều từ lồng nhau (như
"a","ab","abc", ...,"abc...z"), z có thể lớn hơn L rất nhiều, khi đó thời gian bị chi phối bởi z. Trong engineering thực tế, word list nhạy cảm thường không có kiểu lồng nhau cực đoan này.
AC automaton thực hiện match trong linear time, không phụ thuộc vào số lượng từ nhạy cảm mà chỉ phụ thuộc vào độ dài text và số lượng match result.
Kết hợp AC automaton với DAT (AhoCorasickDoubleArrayTrie) có thể cân bằng hiệu quả matching và memory usage.
Double-Array Trie (DAT): nén memory usage
Standard Trie tree tốn khá nhiều memory (mỗi node cần một Map). Trong engineering thực tế thường dùng phiên bản cải tiến là Double-Array Trie (DAT).
DAT được Aoe Jun-ichi và cộng sự đề xuất trong paper năm 1989 《An Efficient Implementation of Trie Structures》. Nó nén cấu trúc Trie bằng hai array số nguyên (base[] và check[]):
| Đặc tính | Standard Trie (array implementation) | Double-Array Trie |
|---|---|---|
| Space complexity | O(n × m × σ) | O(n × m) |
| Memory usage | Lớn | Thường giảm còn 20%~30% của array implementation |
| Độ phức tạp triển khai | Đơn giản | Phức tạp hơn (cần xử lý collision) |
Lưu ý: hiệu quả nén của DAT liên quan chặt chẽ đến tỷ lệ common prefix của word list. Trong trường hợp cực đoan (không có common prefix), hiệu quả nén có giới hạn.
Implementation tham khảo: https://github.com/komiya-atsushi/darts-java
DFA implementation: đóng gói cho engineering
DFA (Deterministic Finite Automaton) là một khái niệm trong lý thuyết automaton. Về mặt implementation, một quá trình match từ root trong Trie vốn đã là một lần chạy DFA: mỗi node đại diện cho một state, mỗi edge đại diện cho một character transition. Tuy nhiên, match bằng Trie thông thường phải khởi động lại DFA từ mỗi vị trí trong text; chỉ khi AC automaton bổ sung toàn bộ state transition bằng fail pointer thì mới thực sự trở thành DFA multi-pattern quét một lần.
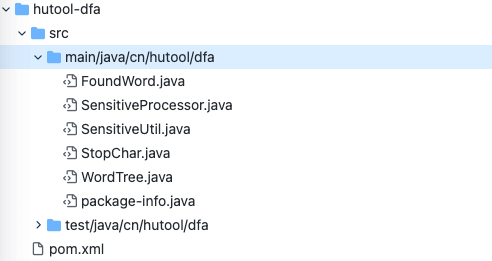
Hutool 5.8.x cung cấp implementation lọc từ nhạy cảm dựa trên DFA (bên dưới là Trie):
WordTree wordTree = new WordTree();
wordTree.addWord("lớn");
wordTree.addWord("lớn ngốc");
wordTree.addWord("ngốc");

String text = "Người đó đúng là lớn ngốc!";

// Lấy keyword match đầu tiên
String matchStr = wordTree.match(text);
System.out.println(matchStr); // Output: lớn

// matchAll(text, limit, isDensityMatch, isGreedy)
// - limit: giới hạn số lượng match, -1 nghĩa là không giới hạn
// - isDensityMatch: có density matching hay không (tiếp tục tìm overlap word bên trong word đã match)
// - isGreedy: có greedy matching hay không (true match keyword dài nhất, false match keyword ngắn nhất)
List<String> matchStrList = wordTree.matchAll(text, -1, false, false);
System.out.println(matchStrList); // Output: [lớn, ngốc]

List<String> matchStrList2 = wordTree.matchAll(text, -1, false, true);
System.out.println(matchStrList2); // Output: [lớn, lớn ngốc]
Giải thích output:
matchAll(text, -1, false, false): non-greedy + non-density matching- Bắt đầu từ vị trí 0,
"lớn"match thành công (shortest match). - Bỏ qua các character đã match,
"ngốc"match thành công từ vị trí 4. - Kết quả:
[lớn, ngốc]
- Bắt đầu từ vị trí 0,
matchAll(text, -1, false, true): greedy + non-density matching- Bắt đầu từ vị trí 0,
"lớn ngốc"match thành công (longest match). - Đồng thời
"lớn"cũng match thành công (với vai trò prefix). - Kết quả:
[lớn, lớn ngốc]
- Bắt đầu từ vị trí 0,
Đối phó với từ biến thể
Trong tình huống thực tế, user thường dùng các cách sau để vượt qua bộ lọc từ nhạy cảm:
| Cách biến thể | Ví dụ | Chiến lược xử lý |
|---|---|---|
| Từ đồng âm | “cờ bạc” → “cờ bạc” | Duy trì word list đồng âm |
| Chèn symbol | "fuck" → "f*u*c*k" | Preprocess để loại bỏ special character |
| Trộn phồn thể và giản thể | “Đài Loan” → “Đài Loan” | Chuyển thống nhất về dạng chuẩn trước khi match |
| Fullwidth character | "abc" → "abc" | Chuyển fullwidth về halfwidth |
Tiền xử lý làm sạch là strategy thường dùng để xử lý từ biến thể: chuẩn hóa bản sao text dùng cho việc detection trước khi match. Code dưới đây bao quát các trường hợp cơ bản như compatibility-equivalent character, chữ hoa/chữ thường, Unicode Code Point và format control character, nhưng vẫn chỉ là ví dụ; production system cần tiếp tục bổ sung rule dựa trên language được hỗ trợ, mức chấp nhận false positive và các mẫu đối kháng thực tế.
import java.text.Normalizer;
import java.util.Locale;

public String preprocess(String text) {
    // NFKC thống nhất các compatibility-equivalent character như fullwidth/halfwidth. Chỉ xử lý bản sao để detection, không ghi đè text gốc của user.
    String normalized = Normalizer.normalize(text, Normalizer.Form.NFKC)
            .toLowerCase(Locale.ROOT);
    StringBuilder sb = new StringBuilder();
    normalized.codePoints()
            // Loại bỏ format control character như zero-width joiner để ngăn chèn character vô hình nhằm vượt qua matching.
            .filter(codePoint -> Character.getType(codePoint) != Character.FORMAT)
            .filter(this::isChineseOrAlphanumeric)
            .forEach(sb::appendCodePoint);
    return toSimplifiedChinese(sb.toString()); // Chuyển phồn thể thành giản thể
}

private boolean isChineseOrAlphanumeric(int codePoint) {
    return Character.isLetterOrDigit(codePoint)
            || Character.UnicodeScript.of(codePoint) == Character.UnicodeScript.HAN;
}
ToolGood.Words và các thư viện mature khác đã tích hợp sẵn chuyển đổi phồn thể/giản thể, fullwidth/halfwidth, có thể dùng trực tiếp.
Lưu ý
- Position mapping: method
preprocessloại bỏ special character, khiến vị trí trong text sau khi làm sạch không còn tương ứng một-một với text gốc. Nếu nghiệp vụ cần trả về vị trí chính xác của từ nhạy cảm trong text gốc (chẳng hạn highlight hoặc replace một phần), cần duy trì mapping từ vị trí sau khi làm sạch đến vị trí trong text gốc. - Ranh giới normalization: NFKC loại bỏ khác biệt giữa một số compatibility character có ý nghĩa nghiệp vụ, vì vậy chỉ nên dùng cho bản sao detection, còn text gốc dùng cho display và audit. Việc xóa character cũng có thể nối các nội dung vốn được ngăn cách thành một từ mới; cần đánh giá false positive bằng corpus thực tế.
- Homoglyph khác code: Unicode confusables có thể hỗ trợ phát hiện character giống nhau giữa các script, nhưng không phù hợp để dùng trực tiếp làm “kết quả normalization” cho text nói chung. Hit có risk cao cần kết hợp context model hoặc manual review, không thể chỉ dựa vào replace character để phán đoán cuối cùng.
:::
Tối ưu high concurrency
Atomic hot-swap: hỗ trợ hot update word list
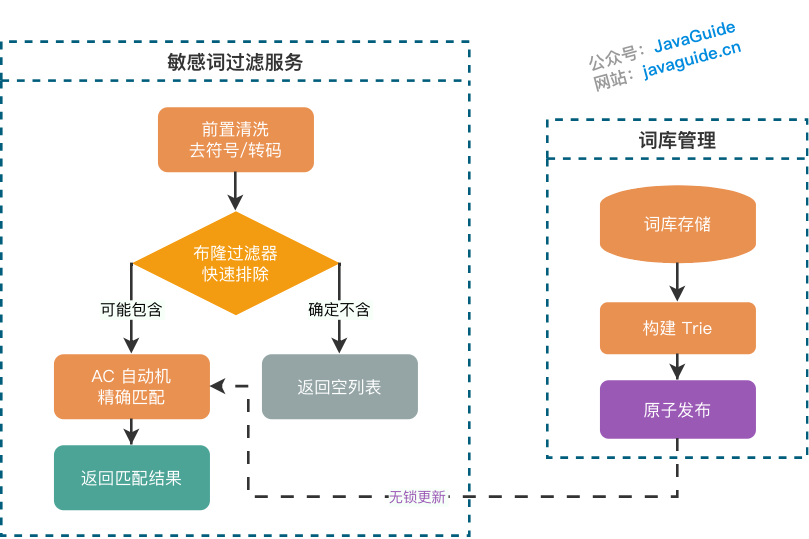
Trong production environment, word list nhạy cảm cần được update thường xuyên nhưng không được ảnh hưởng đến các matching request đang chạy. Dùng AtomicReference để thực hiện atomic hot-swap: xây dựng Trie mới ở background, sau khi xây dựng xong thì atomically replace instance cũ, đảm bảo read thread không bị ảnh hưởng.
public class SensitiveWordFilter {
    private final AtomicReference<SimpleTrie> trieRef;

    public SensitiveWordFilter(List<String> initialWords) {
        this.trieRef = new AtomicReference<>(buildTrie(initialWords));
    }

    // Lấy Trie hiện tại khi match
    public List<String> match(String text) {
        SimpleTrie trie = trieRef.get();
        return trie != null ? trie.matchAll(text) : Collections.emptyList();
    }

    // Update word list: xây dựng Trie mới trước, sau đó publish atomically
    public void refreshWords(List<String> newWords) {
        SimpleTrie newTrie = buildTrie(newWords);
        trieRef.set(newTrie);  // Publish atomically, read thread thấy ngay lập tức
    }

    private SimpleTrie buildTrie(List<String> words) {
        SimpleTrie trie = new SimpleTrie();
        for (String word : words) {
            trie.addWord(word);
        }
        return trie;
    }
}
Điểm quan trọng:
- Dùng
AtomicReferenceđể đảm bảo thao tác switching là atomic. - Trie cũ có thể vẫn đang được thread sử dụng, sau đó phụ thuộc vào GC để tự thu hồi.
- Có thể xây dựng Trie mới bất đồng bộ ở background mà không ảnh hưởng đến service response.
Xử lý song song: chia text rất dài thành các segment
Với text rất dài (chẳng hạn article hoặc comment), có thể chia thành các segment rồi xử lý song song.
Lưu ý: khi chia segment phải thêm vùng overlap, nếu không sẽ bỏ sót từ nhạy cảm băng qua boundary.
// Dùng thread pool riêng để tránh chiếm dụng ForkJoinPool.commonPool()
private final ExecutorService filterExecutor =
    new ThreadPoolExecutor(
        4, 8, 60L, TimeUnit.SECONDS,
        LinkedBlockingQueue<>(1000),
        new ThreadPoolExecutor.CallerRunsPolicy() // Khi queue đầy thì caller thread thực thi để tạo backpressure
    );

public List<String> parallelMatch(String text, int chunkSize, int maxWordLength) {
    // Vùng overlap = độ dài từ nhạy cảm dài nhất - 1, tránh bỏ sót từ băng qua boundary
    int overlap = maxWordLength - 1;
    List<CompletableFuture<List<String>>> futures = new ArrayList<>();

    for (int i = 0; i < text.length(); i += chunkSize) {
        int start = i;
        int end = Math.min(i + chunkSize + overlap, text.length());
        String chunk = text.substring(start, end);

        // Truyền rõ custom thread pool
        futures.add(CompletableFuture.supplyAsync(() ->
            trieRef.get().matchAll(chunk), filterExecutor
        ));
    }

    return futures.stream()
        .flatMap(f -> f.join().stream())
        .distinct()
        .collect(Collectors.toList());
}
Vì sao cần vùng overlap?
Giả sử từ nhạy cảm "trang web cờ bạc" có độ dài 4, kích thước block là 100. Nếu từ này bắt đầu đúng từ vị trí 99 của text, nó sẽ bị chia vào hai chunk:
- chunk1:
...text kết thúc ở vị trí 99 với "trang" - chunk2:
"web cờ bạc" tiếp tục...
Cả hai chunk đều không match được đầy đủ "trang web cờ bạc", dẫn đến bỏ sót. Vùng overlap bảo đảm mỗi từ nhạy cảm đều xuất hiện đầy đủ trong ít nhất một chunk.
Loại nhanh: Bloom Filter
Dùng Bloom Filter để pre-filter có thể nhanh chóng loại bỏ các text không chứa từ nhạy cảm.
Điều kiện áp dụng: giải pháp này chỉ có lợi khi phần lớn text không chứa từ nhạy cảm và false positive rate của Bloom Filter cực thấp. Vì complexity của quickCheck bản thân là O(L × maxWordLen), cùng bậc với Trie matching; nếu text thường xuyên hit Bloom Filter (false positive), nó lại tạo thêm overhead.
Lưu ý: Bloom Filter kiểm tra quan hệ membership của từng element trong set, vì vậy cần kiểm tra substring của text thay vì toàn bộ text.
public List<String> matchWithBloomFilter(String text, int maxWordLength) {
    // Kiểm tra nhanh: quét mọi substring có thể
    if (!quickCheck(text, maxWordLength)) {
        return Collections.emptyList();  // Chắc chắn không chứa từ nhạy cảm
    }
    // Có thể chứa từ nhạy cảm, thực hiện exact matching
    return trieRef.get().matchAll(text);
}

private boolean quickCheck(String text, int maxWordLen) {
    BloomFilter<String> filter = getBloomFilter();  // Bloom Filter chứa mọi từ nhạy cảm
    for (int i = 0; i < text.length(); i++) {
        for (int len = 1; len <= maxWordLen && i + len <= text.length(); len++) {
            if (filter.mightContain(text.substring(i, i + len))) {
                return true;  // Có thể chứa, cần exact matching
            }
        }
    }
    return false;  // Chắc chắn không chứa
}
Trường hợp sử dụng: khi coverage của từ nhạy cảm thấp, Bloom Filter có thể nhanh chóng loại bỏ nhiều text không chứa từ nhạy cảm, giảm số lần Trie matching. Tuy nhiên bản thân việc scan của Bloom Filter cũng có overhead (O(L × maxWordLen)), cần đánh giá có bật hay không dựa trên đặc điểm dữ liệu thực tế.
Open-source project
| Project | Language | JDK tối thiểu | Đặc điểm | Trường hợp sử dụng |
|---|---|---|---|---|
| ToolGood.Words | C#/Java/Python/Go/JS | Java 8+ | Hỗ trợ multi-language, tích hợp chuyển phồn thể/giản thể, fullwidth/halfwidth, chuyển pinyin; bản C# filter hơn 300 triệu character/giây | Project multi-language |
| Hutool DFA | Java | Java 8+ | Lightweight, API đơn giản, triển khai dựa trên Trie | Word list quy mô nhỏ và vừa |
| AhoCorasickDoubleArrayTrie | Java | Java 7+ | AC automaton + Double-Array Trie, hiệu năng tốt | Word list lớn, throughput cao |
Khuyến nghị production
Quản lý word list
- Update định kỳ: word list nhạy cảm cần được maintain liên tục, hỗ trợ hot loading để tránh restart service.
- Quản lý theo cấp độ: chia thành độ nhạy cao/vừa/thấp theo business scenario, dùng strategy khác nhau (block trực tiếp, manual review, ghi log).
- Cơ chế whitelist: duy trì whitelist để tránh false block. Trường hợp điển hình là từ nhạy cảm
"XXX"false block từ bình thường"XXY"(substring match), hoặc"công an"false block"công việc an bài". Các strategy thường dùng gồm loại trừ whitelist phrase, yêu cầu độ dài match tối thiểu (chẳng hạn chỉ match full word thay vì substring), phán đoán theo context window. - Matching log: ghi lại match result để tối ưu word list và phân tích false positive.
Xử lý exception
- Load word list thất bại: khi xây dựng Trie mới thất bại (chẳng hạn OOM hoặc file hỏng), cần giữ nguyên Trie cũ, ghi error log và alert.
- Xử lý word list rỗng: khi word list rỗng cần ghi WARN log thay vì âm thầm cho phép mọi text đi qua.
- Match timeout: với trường hợp text rất dài + word list lớn, có thể thiết lập timeout circuit breaker. Sau khi nội dung risk cao timeout, phải reject, isolate hoặc chuyển sang manual review, không được mặc định allow; chỉ trong scenario risk thấp đã được business approval rõ ràng mới có thể dùng fail-open, đồng thời phải giới hạn input length, ghi metric và alert kịp thời.
Monitoring metric
| Metric | Ngưỡng đề xuất | Mô tả |
|---|---|---|
| Match latency (p99) | < 10ms | Thời gian filter mỗi lần |
| False positive rate | < 1% | Nội dung bình thường bị nhận nhầm là từ nhạy cảm |
| False negative rate | Theo dõi liên tục | Nội dung nhạy cảm không được nhận diện |
| Word list hit rate | Phân tích theo nhu cầu | Tần suất trigger của từng từ nhạy cảm, dùng để tối ưu word list |
Khuyến nghị architecture
Tài liệu tham khảo
Paper học thuật
- Unicode Standard Annex #15 - Unicode Normalization Forms: https://www.unicode.org/reports/tr15/
- Unicode Technical Standard #39 - Unicode Security Mechanisms: https://www.unicode.org/reports/tr39/
- Aho, A.V. and Corasick, M.J. (1975). "Efficient string matching: An aid to bibliographic search." Communications of the ACM, 18(6), 333-340. (Paper gốc về AC automaton)
- Aoe, J., Morimoto, K., and Sato, T. (1989). "An Efficient Implementation of Trie Structures." Software: Practice and Experience.
Patent liên quan
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.