3种常用的缓存读写策略详解
看到很多小伙伴简历上写了“熟练使用缓存”,但是被我问到“缓存常用的 3 种读写策略”的时候却一脸懵逼。
在我看来,造成这个问题的原因是我们在学习 Redis 的时候,可能只是简单写了一些 Demo,并没有去关注缓存的读写策略,或者说压根不知道这回事。
但是,搞懂 3 种常见的缓存读写策略对于实际工作中使用缓存以及面试中被问到缓存都是非常有帮助的!
下面介绍到的三种模式各有优劣,不存在最佳模式,根据具体的业务场景选择适合自己的缓存读写模式。
Cache Aside Pattern(旁路缓存模式)
这是我们日常开发中最常用、最经典的一种模式,几乎是互联网应用缓存方案的事实标准,尤其适合读多写少的业务场景。
这个模式之所以被称为“旁路”(Aside),是因为应用程序的写操作完全绕过了缓存,直接操作数据库。
应用程序扮演了数据流转的“指挥官”,需要同时维护 Cache 和 DB 两个数据源。
下面我们来看一下这个策略模式下的缓存读写步骤。
写操作 :
- 应用先更新 DB,并提交事务。
- 事务提交成功后,删除 Cache 中对应的数据。
简单画了一张图帮助大家理解写的步骤。

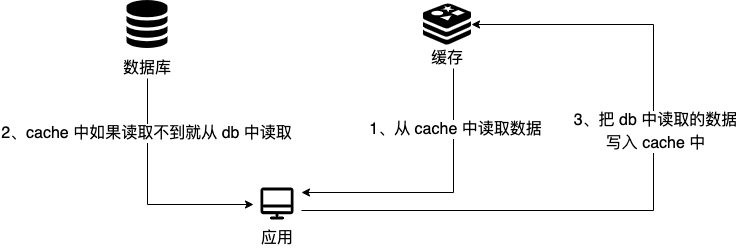
读操作:
- 应用先从 Cache 读取数据。
- 如果命中(Hit),则直接返回。
- 如果未命中(Miss),则从 DB 读取数据,成功读取后,将数据写回 Cache,然后返回。
简单画了一张图帮助大家理解读的步骤。
你仅仅了解了上面这些内容的话是远远不够的,我们还要搞懂其中的原理。
比如说面试官很可能会追问:
- 为什么写操作是“先更新 DB,后删除 Cache”?顺序能反过来吗?
- 那“先更新 DB,后删除 Cache”就绝对安全吗?
- 为什么是“删除 Cache”,而不是“更新 Cache”?
接下来我会以此分析解答这些问题。
1. 为什么写操作是“先更新 DB,后删除 Cache”?顺序能反过来吗?
答: 通常不建议反过来。如果只做“先删 Cache,后更新 DB”,并发读请求就可能把旧数据重新放回缓存。
- 时序分析 (请求 A 写, 请求 B 读):
- 请求 A: 先将 Cache 中的数据删除。
- 请求 B: 此时发现 Cache 为空,于是去 DB 读取旧值,并准备写入 Cache。
- 请求 A : 将新值写入 DB 并提交事务。
- 请求 B: 将之前读到的旧值写入了 Cache。
- 结果: DB 中是新值,而 Cache 中是旧值,数据不一致。
2. 那“先更新 DB,后删除 Cache”就绝对安全吗?
答案: 也不是绝对安全的!因为这样也可能会造成 数据库和缓存数据不一致的问题。
- 时序分析 (请求 A 读, 请求 B 写):
- 请求 A : 缓存未命中,从 DB 读取到旧值。
- 请求 B: 完成 DB 更新并提交事务,随后将 Cache 删除。
- 请求 A : 将自己之前拿到的旧值写入了 Cache。
- 结果: DB 中是新值,Cache 中又是旧值。
- 发生概率取决于什么? 关键是“读 DB → 写 Cache”的时间窗口是否与写请求重叠。慢查询、线程暂停、网络延迟都可能拉长这个窗口,不能仅凭“读一般比写快”就认定概率极小。
这里的“先更新 DB”必须包含事务提交成功。如果在事务方法内部执行 UPDATE 后就删缓存,而事务要等方法返回才提交,其他请求仍可能在提交前读到旧值并回填。提交后的回调可以保证操作顺序,但进程可能在提交后、执行回调前退出,仍需考虑失败补偿。
回源的数据是否足够新也很关键:读写分离时,从库可能尚未应用主库的更新;在 InnoDB 的 REPEATABLE READ 隔离级别下,已经建立快照的长事务也可能继续读到旧版本。对新鲜度敏感的回填,应评估是否需要读主库、使用新的短事务,避免把旧快照当作最新数据写入缓存。快照规则可以参考 MySQL 官方文档。
3. 为什么是“删除 Cache”,而不是“更新 Cache”?
- 性能开销: 写操作往往只更新了对象的部分字段,如果为了“更新 Cache”而去重新查询或计算整个缓存对象,开销可能很大。相比之下,“删除”是一个轻量级操作。
- 懒加载思想: “删除”操作遵循懒加载原则。只有当数据下一次被真正需要(被读取)时,才触发从 DB 加载并写入缓存,避免了无效的缓存更新。
- 避免并发写覆盖: 假设 A 提交版本 1,B 随后提交版本 2,并先完成缓存更新;如果 A 的缓存更新最后才到达,就会把缓存覆盖回版本 1。删除缓存不携带旧值,可以避免这种直接覆盖,但仍要处理前面提到的旧数据回填问题。
采用这套模式,需要满足两个前提:缓存数据可以从数据库重建,读端在缓存未命中时具备回源能力;业务也能接受一定的陈旧读取窗口。这个窗口可能发生在提交后、删缓存前,也可能由删除失败或旧值回填造成,并不一定很短。Cache Aside 本身不保证缓存与数据库始终一致。
4. 删除失败、旧值回填分别怎么处理?
- 删除失败要有可恢复的重试。 可以将失效任务交给消息队列或后台任务,但“提交 DB 后再发消息”仍可能在两步之间宕机。需要可靠衔接时,可以采用事务消息表(Transactional Outbox):在更新业务数据的同一个数据库事务中记录待处理事件,提交后由后台投递;也可以通过 CDC 订阅已提交的数据库变更来触发失效。消费者重复执行删除通常是安全的,同时要监控积压、重试失败并提供补偿入口。可参考 AWS 对事务消息表的说明。
- 旧值回填不能仅靠删除重试解决。 删除可能早已成功,旧请求却在删除之后才写入缓存。延迟再删除一次能清理一部分迟到回填,但固定延迟无法覆盖任意长的请求暂停、事务或复制延迟,第二次删除本身也可能失败。因此,延迟双删只能缩小风险,不能作为强一致性保证。
- TTL 是兜底,不是同步协议。 过期后应从数据库重新加载;如果仍从延迟副本或旧快照回填,陈旧数据会再次获得一段 TTL。也不要在每次读取旧值时续期,否则可能一直保留旧数据。TTL 应根据业务可接受的陈旧时间和回源压力确定。
业务需要进一步约束并发回填时,可以设计覆盖相关读写路径的互斥或版本校验协议。只给写请求加锁,无法阻止未加锁的读请求回填;只比较缓存当前版本,也无法在缓存已经被删除时识别迟到的旧值,需要保留独立的版本水位等信息。Redis 锁或 Lua 脚本都不能让 Redis 与 MySQL 的两次写入自动成为一个原子事务。 对必须读取最新已提交状态的业务,应明确权威读路径和数据库隔离要求。
现在我们再来分析一下 Cache Aside Pattern 的缺陷。
缺陷 1:首次请求数据一定不在 Cache 的问题
解决办法:对于访问量巨大的热点数据,可以在系统启动或低峰期进行缓存预热。
缺陷 2:写操作比较频繁的话导致 Cache 中的数据会被频繁被删除,这样会影响缓存命中率 。
解决办法:
- 先判断这份数据是否适合缓存。读写频率接近、重建成本又低时,直接查询数据库可能更简单。
- 如果确实需要主动更新缓存,应处理并发更新顺序和失败补偿,并设置合理的 TTL。加锁或版本控制可以解决部分并发问题,但不能省略前面讨论的跨系统故障处理。
Read/Write Through Pattern(读写穿透)
在这种模式下,应用程序将Cache 视为唯一的、主要的存储。所有的读写请求都直接打向 Cache,而 Cache 服务自身负责与 DB 进行数据同步。
对应用程序透明,应用开发者无需关心 DB 的存在。
这种缓存读写策略小伙伴们应该也发现了在平时在开发过程中非常少见。抛去性能方面的影响,大概率是因为我们经常使用的分布式缓存 Redis 本身并没有提供 Cache 将数据写入 DB 的功能,需要我们在业务侧或中间件里自己实现。
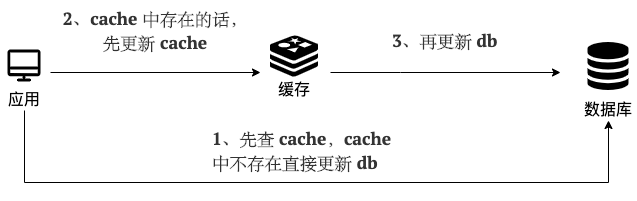
写(Write Through):
- 先查 Cache,Cache 中不存在,直接更新 DB。
- Cache 中存在,则先更新 Cache,然后 Cache 服务自己更新 DB。只有当 Cache 和 DB 都写入成功后,才向上层返回成功。
简单画了一张图帮助大家理解写的步骤。
读(Read Through):
- 应用从 Cache 读取数据。
- 如果命中,直接返回。
- 如果未命中,由Cache 服务自己负责从 DB 加载数据,加载成功后先写入自身,再返回给应用。
简单画了一张图帮助大家理解读的步骤。
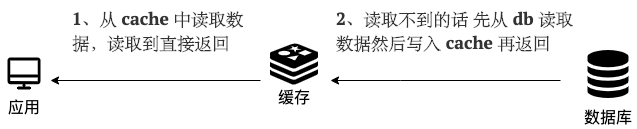
Read-Through 实际只是在 Cache-Aside 之上进行了封装。在 Cache-Aside 下,发生读请求的时候,如果 Cache 中不存在对应的数据,是由客户端自己负责把数据写入 Cache,而 Read Through 则是 Cache 服务自己来写入缓存的,这对客户端是透明的。
从实现角度看,Read-Through 本质上是把 Cache-Aside 中“读 Miss → 读 DB → 回填 Cache”的逻辑,下沉到了缓存服务内部,对客户端透明。
和 Cache Aside 一样, Read-Through 也有首次请求数据一定不再 Cache 的问题,对于热点数据可以提前放入缓存中。
Write Behind Pattern(异步缓存写入)
Write Behind(也常被称为 Write-Back) Pattern 和 Read/Write Through Pattern 很相似,两者都是由 Cache 服务来负责 Cache 和 DB 的读写。
但是,两个又有很大的不同:Read/Write Through 是同步更新 Cache 和 DB,而 Write Behind 则是只更新缓存,不直接更新 DB,而是改为异步批量的方式来更新 DB。
写操作 (Write Behind):
- 应用将数据写入 Cache,然后立即返回。
- Cache 服务将这个写操作放入一个队列中。
- 通过一个独立的异步线程/任务,将队列中的写操作批量地、合并地写入 DB。
这种模式对数据一致性带来了挑战(例如:Cache 中的数据还没来得及写回 DB,系统就宕机了),因此不适用于需要强一致性的场景(如交易、库存)。
但是,它的异步和批量特性,带来了无与伦比的写性能。它在很多高性能系统中都有广泛应用:
- MySQL 的 InnoDB Buffer Pool 机制: 数据修改先在内存 Buffer Pool 中完成,然后由后台线程异步刷写到磁盘。
- 操作系统的页缓存(Page Cache): 文件写入也是先写到内存,再由操作系统异步刷盘。
- 高频计数场景: 对于文章浏览量、帖子点赞数这类允许短暂数据不一致、但写入极其频繁的场景,可以先在 Redis 中快速累加,再通过定时任务异步同步回数据库。
写在最后
如果内容对你有帮助的话,欢迎顺手给 JavaGuide 点一个免费的 Star 支持一下:GitHub | Gitee。
JavaGuide 已持续维护近七年,累计 6100+ 次提交,来自 620+ 位贡献者共同完善。你的 Star、反馈和 PR,都是这个项目继续更新的动力。
如果你正在准备后端/AI 应用开发面试,也可以了解一下我的知识星球,里面包括后端和 AI 实战项目、简历优化、一对一提问和高频考点资料,已经持续维护六年。