这份 高性能系统知识体系 面向后端学习、系统设计和面试复习,围绕“减少延迟、提升吞吐、削峰填谷、降低数据库压力、优化数据访问路径”整理本站高性能相关文章。
2026/9/2大约 6 分钟
这份 高性能系统知识体系 面向后端学习、系统设计和面试复习,围绕“减少延迟、提升吞吐、削峰填谷、降低数据库压力、优化数据访问路径”整理本站高性能相关文章。
CDN 全称是 Content Delivery Network/Content Distribution Network,翻译过的意思是 内容分发网络 。
我们可以将内容分发网络拆开来看:
数据冷热分离是指根据数据的访问频率和业务重要性,将数据划分为冷数据和热数据,并分别存储在不同性能和成本的存储介质中的架构策略。
这种架构的核心目标有三个:
查询偏移量过大的场景我们称为深度分页,这会导致查询性能较低,例如:
# MySQL 在无法利用索引的情况下跳过1000000条记录后,再获取10条记录
SELECT * FROM t_order ORDER BY id LIMIT 1000000, 10
高性能系统面试通常从一个具体症状开始:接口变慢、数据库 CPU 升高、消息开始积压,或者大促流量超过了现有容量。回答时先确认 QPS、P99、数据量和读写比例,再沿着请求链查入口、应用、缓存、数据库和消息队列,直接报出“加缓存、上 MQ、分库分表”很容易被继续追问。
负载均衡 指的是将用户请求分摊到不同的服务器上处理,以提高系统整体的并发处理能力以及可靠性。负载均衡服务可以有由专门的软件或者硬件来完成,一般情况下,硬件的性能更好,软件的价格更便宜(后文会详细介绍到)。
下图是《Java 面试指北》 「高并发篇」中的一篇文章的配图,从图中可以看出,系统的商品服务部署了多份在不同的服务器上,为了实现访问商品服务请求的分流,我们用到了负载均衡。
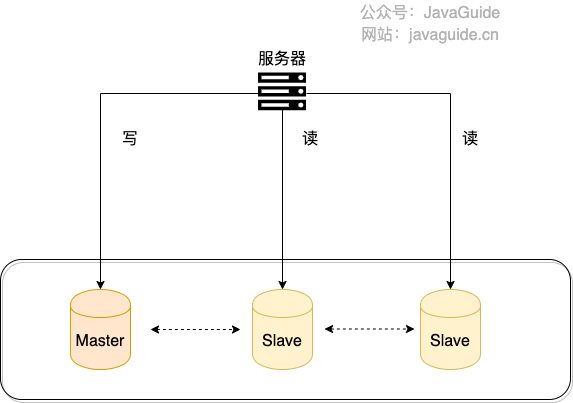
读写分离主要是为了将数据库的读操作和写操作分散到不同的数据库节点上。 写请求仍然进入主库,读请求分摊到一个或多个只读副本,因此它主要提升的是数据库读扩展能力。只有当主库原本被大量读请求拖慢时,读流量迁出后,写入链路才可能间接受益。
我简单画了一张图来帮助不太清楚读写分离的小伙伴理解。
SQL 慢了,不要一上来就套“加索引”“不要 SELECT *”这类规则。先把慢 SQL 找出来,看它慢在扫描行数、排序、回表、锁等待,还是调用频次太高。执行计划和业务访问方式对上之后,再决定是改索引、改 SQL、改表结构,还是把查询挪到缓存、搜索引擎或离线报表里。
排查时可以按这个顺序来:
type、key、rows、filtered、Extra,确认有没有全表扫描、回表过多、临时表或文件排序。消息队列是高性能和高可用系统里都非常常见的中间件,主要用于异步处理、应用解耦、削峰填谷和流量缓冲。学习消息队列时,不能只背 Kafka、RocketMQ、RabbitMQ 的特性,更要理解消息可靠性、顺序性、幂等性、积压处理和技术选型。
如果你准备面试,建议先看 消息队列面试题总结,把 MQ 问题放进生产、存储、消费、确认和补偿链路中复习,再根据项目使用的中间件深入对应专题文章。
Disruptor 是一个相对冷门一些的知识点,不过,如果你的项目经历中用到了 Disruptor 的话,那面试中就很可能会被问到。
一位球友之前投稿的面经(社招)中就涉及一些 Disruptor 的问题,文章传送门:圆梦!顺利拿到字节、淘宝、拼多多等大厂 offer! 。
