什么是 Model Context Protocol (MCP)?和 Function Calling、Agent 什么关系?
同一个 Git 工具接到 Claude Desktop、Cursor 和自建 Agent 时,往往要各写一层适配。工具参数、鉴权方式或版本一变,接入它的多个客户端都得跟着改。
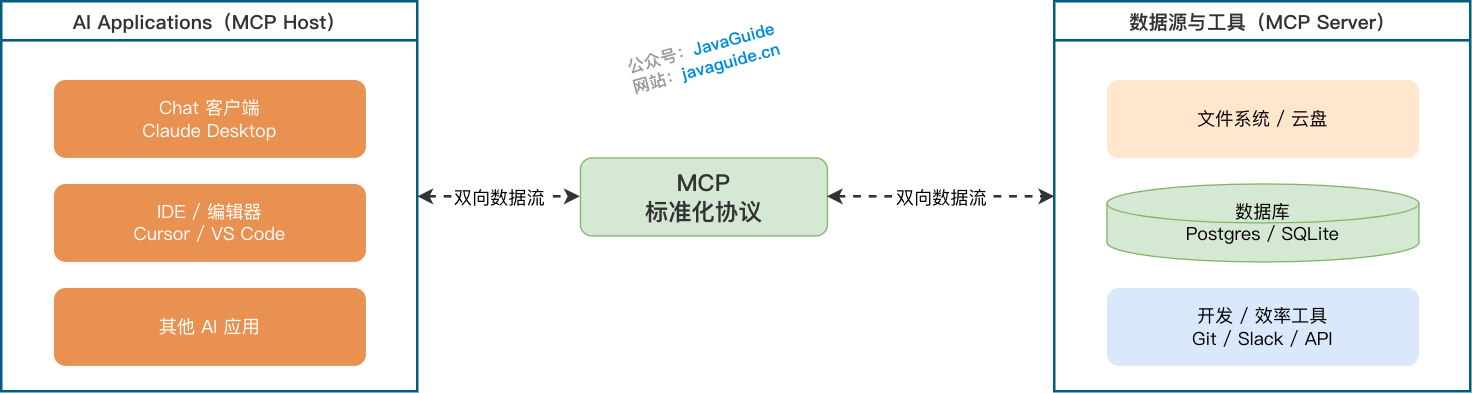
MCP 约定外部系统以 Server 形式暴露能力,支持该协议的 Host 通过 Client 发现并调用这些能力。它处理的是工具和数据源的接入;模型如何决定调用、任务如何编排,仍属于 Function Calling 和 Agent 的职责。
本文以当前稳定的 2026-07-28 revision 为主。上一代
2025-11-25revision 使用初始化握手和传输层会话;2026-07-28改为无状态、自描述请求,移除了initialize/initialized握手和Mcp-Session-Id,并将 Tasks 移至io.modelcontextprotocol/tasks扩展。兼容旧版的客户端和 SDK 可能仍使用2025-11-25,接入前要同时确认协议 revision、SDK 版本和 Host 能力。
MCP 到底是什么?
MCP 全称是 Model Context Protocol,中文一般叫“模型上下文协议”。
把 MCP 的全称拆开来看,其实就很清晰了:
- Model:面向大模型应用;
- Context:把外部上下文、工具和数据源带给模型;
- Protocol:用一套标准协议把交互方式定下来。
不过,也不要把 MCP 理解成给模型加插件这么简单。之前在星球群里看大家讨论 MCP 的时候,有不少同学都是这样认为的。
更准确一点说,MCP 是 MCP Client 和 MCP Server 之间的通信协议。Host 负责承载用户交互和模型调用,Client 负责和 Server 说话,Server 负责把具体能力暴露出来。
举个很常见的场景。
G 友问:“帮我看看这个项目最近一次提交改了什么。”
你用的模型或者 Agent 当然不知道你本地 Git 仓库的提交记录。它得借助外部能力读取 Git 日志。
没有 MCP 时,每个 AI 应用都得自己定义一套“怎么连 Git 工具、怎么传参数、怎么拿结果”的方式。
有了 MCP 之后,Git 相关能力可以被封装成一个 MCP Server。Host 里的 MCP Client 连上它,先发现有哪些工具,再按协议调用工具,最后把结果交给模型继续分析。
Git 工具的协议适配集中在 Server 一侧,Agent 或 AI 应用只需理解用户问题、选择工具并组织结果。两边不必为每个客户端重新约定一套私有接口。
MCP、Function Calling、Agent 到底是什么关系?
一次“读取仓库最新提交”的任务,Function Calling、MCP 和 Agent 可能同时出现,但分别卡在不同位置:模型先给出结构化的调用意图,Host 再把它送到实际工具,Agent 则根据返回结果决定要不要继续。
以模型输出的调用意图为例:
{
  "name": "read_file",
  "arguments": {
    "path": "/repo/README.md"
  }
}
OpenAI 把这类机制称为 Function Calling,Anthropic 称为 Tool Use。模型借它输出“调用 read_file,参数是这个路径”这样的结构化数据。
MCP 负责把这个意图接到外部系统:工具从哪个 Server 发现、请求如何传输、结果如何返回。
Agent 关心任务的下一步。它会读取工具结果,继续调用、结束任务,或等待人工确认;规划、记忆和循环也属于这一层。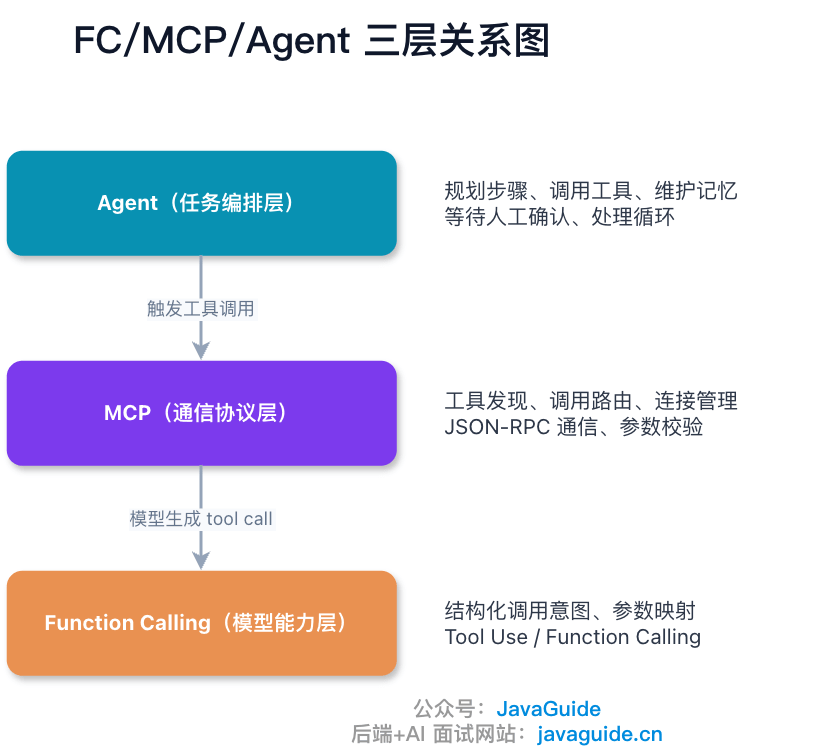
把三者放在一条请求链路里看更直观:Function Calling 产生命令,MCP 传递命令并连接工具,Agent 决定这条链路何时继续、何时结束。
不同场景的关注重点如下:
| 场景 | 更关键的东西 | 原因 |
|---|---|---|
| 让模型判断要不要查天气 | Function Calling | 重点是模型把意图转成结构化参数 |
| 让 Claude Desktop 读取本地文件 | MCP | 重点是宿主和本地文件系统之间有标准接口 |
| 让 AI 自动排查线上故障 | Agent | 重点是多步决策、工具调用和结果反馈 |
实际项目里三者通常会一起出现,表格只是用来区分主要责任边界。
MCP 里到底有哪些东西?
MCP 的通信链路由 Host、Client 和 Server 组成。
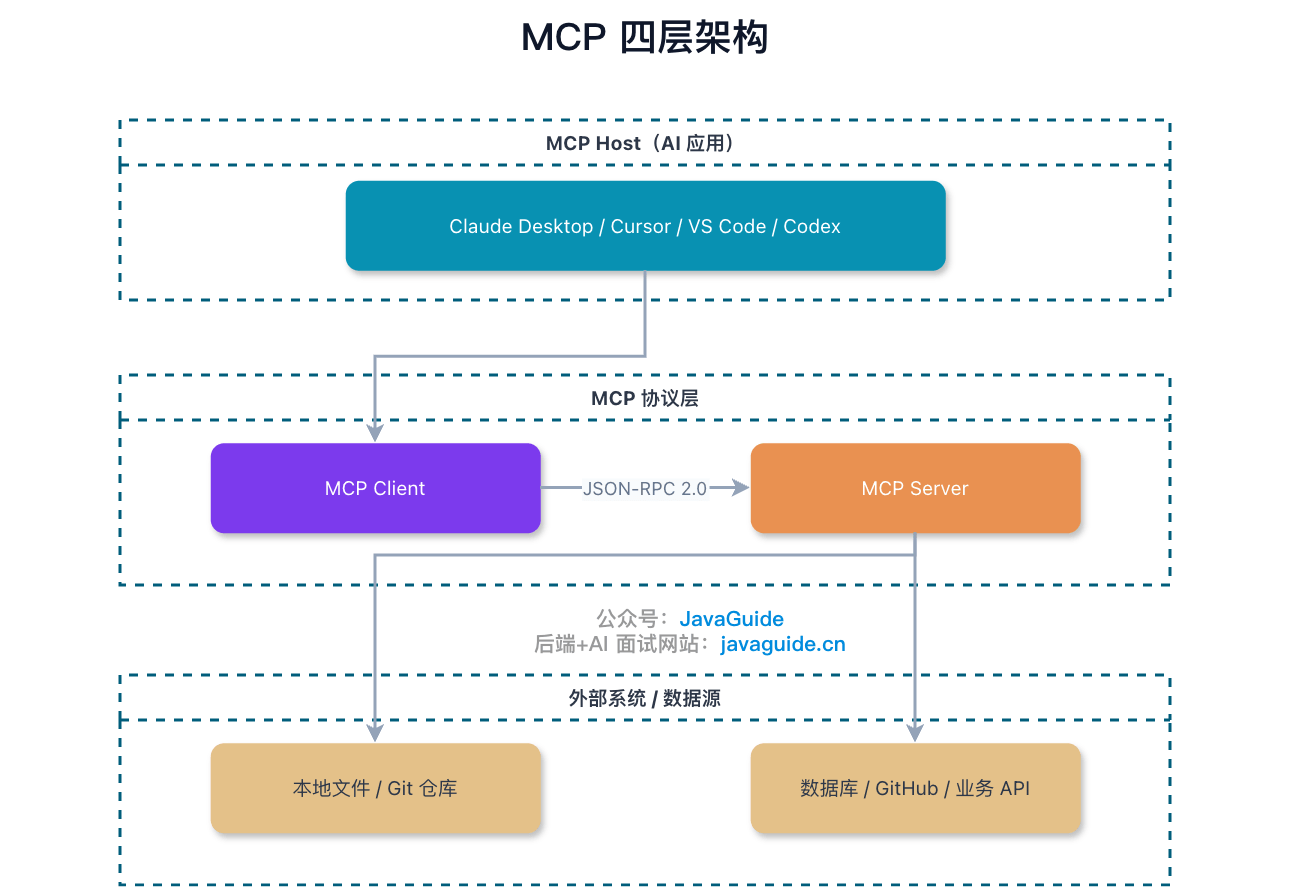
Host 是用户使用的 AI 应用,例如 Claude Desktop、Cursor、VS Code 中的 AI 插件或自建 Agent 平台。
Client 位于 Host 内部,负责与 MCP Server 交换协议消息。对于 2025-11-25 及更早 revision,Client 通过初始化握手建立会话;2026-07-28 则使用无状态请求,不再建立 MCP 传输会话。一个 Host 可以连接多个 Server,通常每个 Server 对应一个 Client。
开发者主要编写 Server。文件读取、SQL 查询、GitHub Issue 查询和内部工单查询等能力,都可以由它向 Host 暴露。
Server 后面才是实际的数据源:本地文件、数据库、内部平台、GitHub 或第三方 API。它们不属于 MCP 的协议角色。Host 只通过 Client 调用 Server;查库、请求 API 等底层实现留在 Server 内部处理。
一次 MCP 调用大概怎么走?
还是拿“分析这个仓库的最新提交”举例。
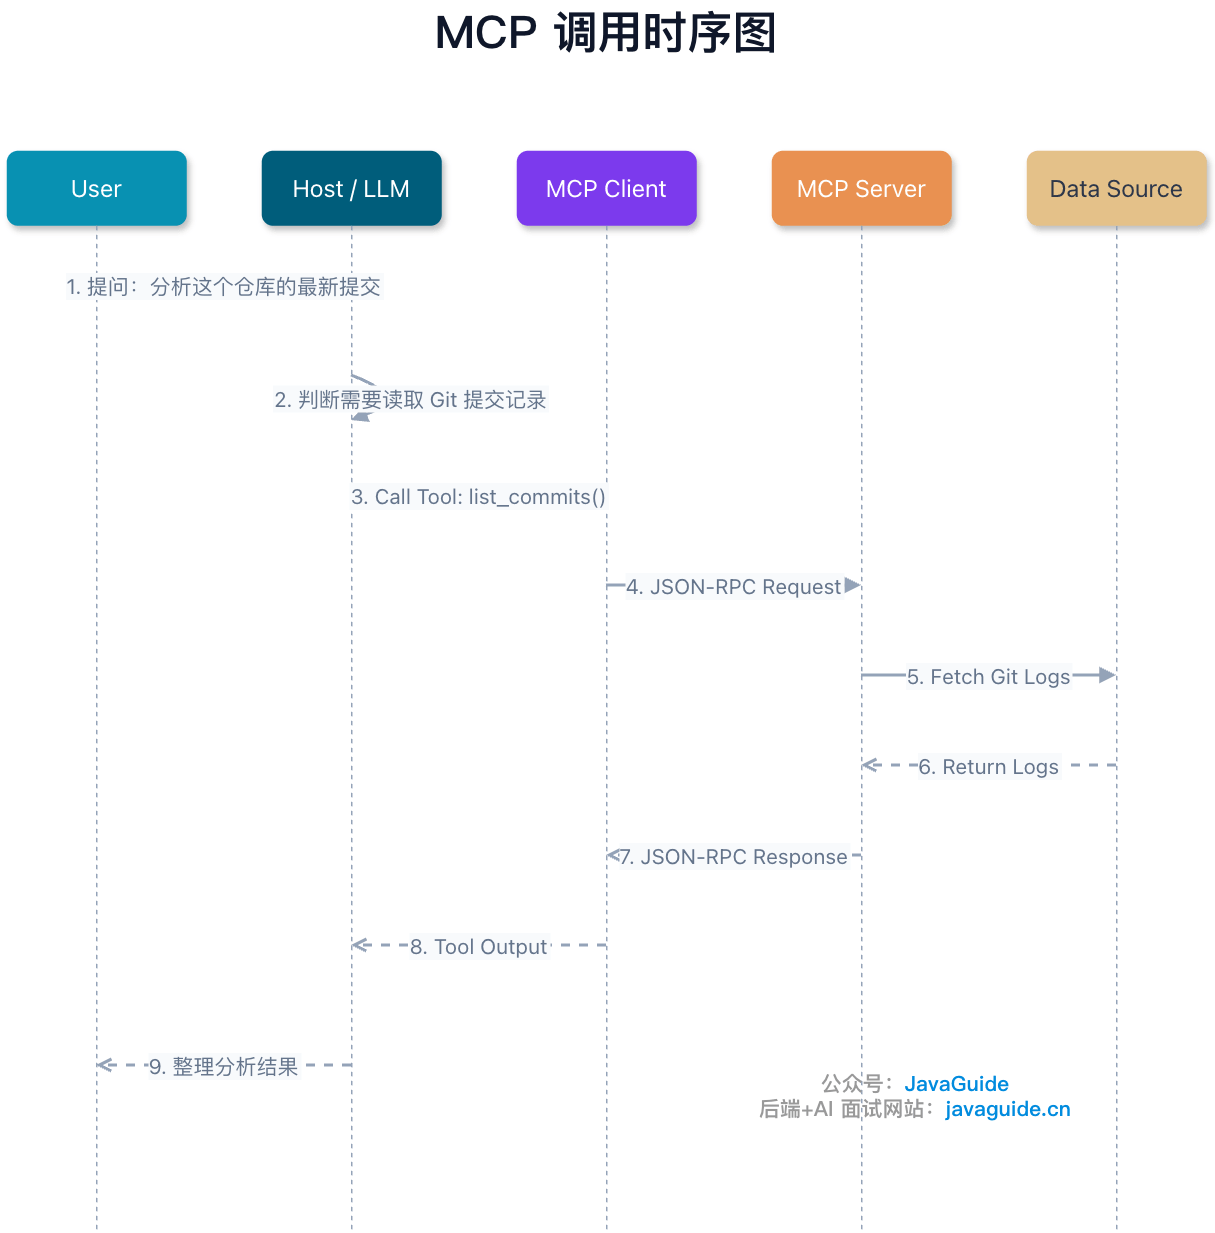
模型发现自己缺少 Git 日志后,先生成工具调用。Host 把调用交给 MCP Client,Client 通过 JSON-RPC 请求 Server;Server 查询 Git,再把结果沿原路径返回,模型据此组织回答。
工具的名称、description、参数说明和禁用场景会直接影响模型的选择。Server 接收到的参数也必须视为不可信输入:文件读取要限制目录,SQL 要参数化,高危操作要审批,返回数据要脱敏。
在 2026-07-28 revision 中,MCP 不再要求 initialize/initialized 握手或 Mcp-Session-Id。每个请求都自包含协议版本和客户端能力;如果 Client 希望先获取 Server 能力,可以调用可选的 server/discover。使用 2025-11-25 或更早 revision 的兼容客户端仍会执行初始化握手。排查工具未出现时,先确认 Client 和 Server 选用的 revision,再检查现代请求的能力元数据或旧版握手结果。
MCP 暴露的能力只有 Tools 吗?
技术群里很多读者聊 MCP 时只讲 Tools,这也正常,因为工具调用最直观。但 MCP 里不只有工具。
Resources、Tools 和 Prompts
Server 可以提供 Resources、Tools 和 Prompts 三类能力。
Resources 用于提供只读上下文,例如本地文件、日志片段、数据库 Schema 或配置记录。
Tools 用于执行动作,例如查询数据库、发送消息、创建工单或调用业务接口。会主动执行逻辑、可能改变外部状态的能力,应当放在 Tools 中。
Prompts 是可复用的提示词模板,例如“按团队规范做代码审查”或“把接口文档整理成测试用例”。
Tools 通常由模型选择并调用;Resources 和 Prompts 的展示、选择方式还可以由 Host、用户界面或应用逻辑决定。
用一个生活例子理解 Resources、Tools、Prompts。
G 友说:“我想吃凉拌黄瓜。”
LLM 扮演厨师,它知道凉拌黄瓜大概怎么做,但它还需要外部条件:
- Resources 像食材和菜谱,比如冰箱里有什么、家里有没有黄瓜、调料放在哪里;
- Tools 像具体动作,比如切菜、拌料、开火、下单买菜;
- Prompts 像家里的固定偏好,比如少放辣、必须放香菜、不能放蒜。
如果工具描述写错了,比如把“黄瓜”描述成“西红柿”,模型就可能选错东西。
落到生产环境,工具名、参数描述和返回结构都直接影响 Agent 的选择和后续判断。Server 能启动只是开始,能力边界还要让模型能准确理解。
Roots、Sampling 和 Elicitation
除了 Server 侧能力,Client 侧也可以提供一些能力给 Server 使用,比如 Roots、Sampling、Elicitation。2026-07-28 将 Roots、Sampling 和 Logging 标记为 deprecated(仍会保留至少十二个月);Tasks 则移至 io.modelcontextprotocol/tasks 扩展。新实现应先确认目标 Client/Host 对这些能力或扩展的支持情况。
Roots 由 Host 通过 Client 告诉 Server:当前工作范围预期在哪些文件系统根目录内。例如,Host 可以只公布当前项目目录,不公布用户主目录。它是能力协商和范围提示,不会自动形成文件系统沙箱;Server 仍要做路径规范化、越界检查和操作系统级权限隔离。
Sampling 比较特殊,它允许 Server 请求 Host 侧的 LLM 做一次生成。比如 Server 读取到一段日志后,希望借助模型做摘要或分类。
Elicitation 则是 Server 在执行过程中向用户补充询问信息的能力。比如参数不完整、选项有歧义、执行前需要用户确认,就可以由 Host 侧展示交互。
这些能力要按场景选择。大多数 MCP Server 可以先只提供 Tools;需要只读上下文或可复用任务入口时,再考虑 Resources、Prompts。Roots、Sampling、Elicitation 以及 Tasks 扩展都取决于对应 Client/Host 是否实现,不能只看 Server SDK 有无接口。
为什么 MCP 用 JSON-RPC?
MCP 底层通信使用 JSON-RPC 2.0。
REST 更偏资源,比如 /users/1、/orders/100。JSON-RPC 更偏方法调用,比如 tools/call、resources/read。AI 工具调用天然就是“我要执行某个动作”,所以 JSON-RPC 和 MCP 的使用场景比较贴。
一个工具调用请求大概长这样:
{
  "jsonrpc": "2.0",
  "method": "tools/call",
  "params": {
    "name": "read_file",
    "arguments": {
      "path": "/path/to/file.txt"
    }
  },
  "id": 1
}
响应可能是这样:
{
  "jsonrpc": "2.0",
  "id": 1,
  "result": {
    "content": [
      {
        "type": "text",
        "text": "文件内容..."
      }
    ]
  }
}
失败时才返回 error:
{
  "jsonrpc": "2.0",
  "id": 1,
  "error": {
    "code": -32602,
    "message": "Invalid params"
  }
}
成功响应只返回 result,失败响应才返回 error;不要在成功响应中再附上 error: null。
JSON-RPC 的消息是文本格式,便于记录日志,也不绑定具体传输方式。代价是它没有 gRPC 那样的强 IDL 和编译期类型约束。MCP 虽然能用 JSON Schema 描述工具参数,但 Schema 既是运行时校验规则,也是给模型的提示;Server 仍需对所有参数做严格校验。
stdio 和 Streamable HTTP 怎么选?
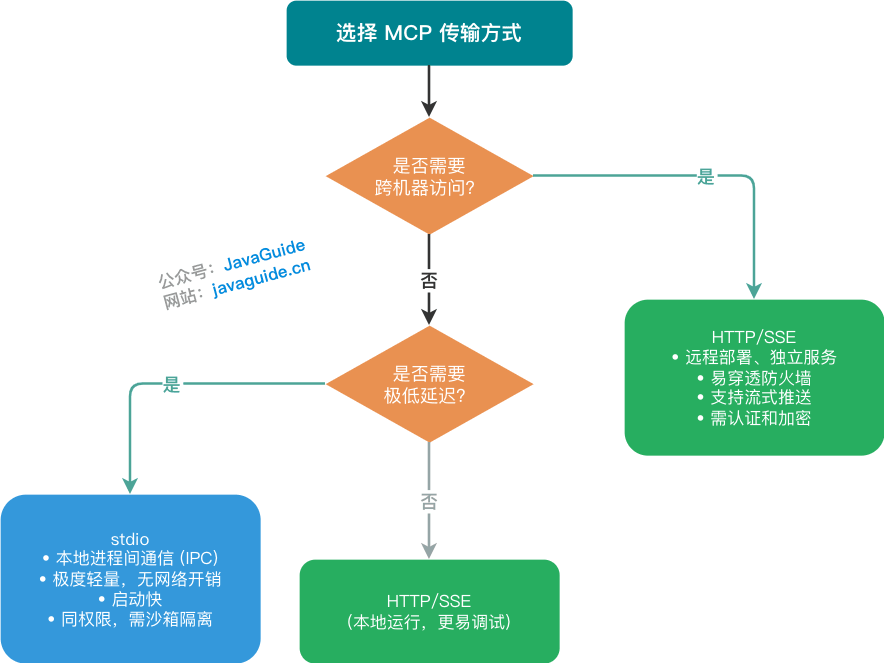
本地 Server 通常使用 stdio。Host 将它作为子进程启动,再通过 stdin/stdout 交换消息;Claude Desktop 中的很多本地 Server 都采用这种方式。它没有额外的网络部署成本,但 Server 运行在本机,文件、Shell 和数据库权限要单独收紧。
如果是第三方 Server,最好别直接裸跑。至少先看源码,或者用 Docker、cgroups、namespace 这类方式隔离一下。尤其是文件系统、Shell、数据库相关的 Server,权限一旦给大,后面很难补。
stdio 模式下,stdout 是 JSON-RPC 消息通道,不能用于打印调试日志。一行 print() 输出就可能破坏消息格式,导致 Host 解析失败或 Server 断连。调试日志应写入 stderr 或文件;排查“Server 启动失败”时,也要确认 stdout 中没有混入日志。
远程 Server 更适合使用 Streamable HTTP。MCP 早期远程传输常见 HTTP + SSE,后来转向 Streamable HTTP;旧版 HTTP+SSE 已被标记为 deprecated。2026-07-28 继续使用 Streamable HTTP,但采用无状态请求,并要求请求携带 Mcp-Method 和 Mcp-Name 头,认证、负载均衡和网关接入可以沿用普通 HTTP 服务的运维方式。
POST /mcp
Authorization: Bearer xxx
响应可能是普通 JSON,也可能是 SSE 流,取决于请求类型。
选择传输方式时,可以按部署位置和访问范围判断:
- 本地工具、本地文件、个人使用,优先 stdio。
- 团队服务、远程 API、多用户访问,优先 Streamable HTTP。
- 涉及写操作和敏感数据时,不管哪种传输方式,都要额外做鉴权、限流和审计。
MCP 的意义只是让模型会调接口吗?
Function Calling 已经可以让模型表达“调用哪个接口”。MCP 解决的是同一个工具交付给多个 Host 时的重复集成。
例如,内部工单系统接入一个 Agent 后,换成另一个 Host 往往还要重写连接、参数和结果处理。将能力封装为 MCP Server 后,支持 MCP Client 的应用可以按同一套发现和调用方式接入。
这个边界和前后端通过接口契约协作相似:Agent 开发关注任务和交互,工具开发关注能力实现、数据权限和操作边界。
团队里的操作手册、值班文档、故障复盘和排查脚本常分散在文档库、Wiki 或脚本仓库中。把可授权的查询和排查能力整理成 Server 后,Agent 才能在既定范围内查文档、读配置或运行工具,而不是只给出一段泛泛的说明。
MCP 接进来之后,就能直接上生产吗?
不能。Demo 中“装一个 Server,问一句话,拿到结果”的链路很短;生产环境要补齐接口约束、审计和运行治理。
时间字段是 ISO-8601 还是时间戳、金额单位是元还是分、分页默认值是什么,都要写进 Schema、字段说明和示例。Server 要据此校验参数,并返回模型能够据以修正请求的错误信息。
一条 Agent 回答可能经过多个 Server 和工具。Trace ID、结构化日志和调用链需要记录调用参数、耗时、结果摘要与错误码,才能定位哪一步影响了最终回答。
本地 stdio 可能获得用户机器上的文件权限,远程 Server 可能连到内部系统。文件目录、可查询的表、是否可写生产 API、是否允许发送邮件都应明确授权。删除、修改、发送和生产调用等写操作还需要二次确认、审计和回滚预案。
Server 的 description、Prompt 模板和返回内容同样需要审核:恶意或粗糙的内容可能夹带提示词注入,引导模型读取更多文件或外传信息。Server 来源、依赖包、权限范围和更新记录都属于上线审查范围。
模型 Token、向量检索、第三方 API 和云资源都会产生费用。调用应能关联到用户、业务线和工具,否则费用上升时无法判断成本来自哪里。
工具接口的字段、枚举或返回结构发生不兼容变更,也会改变模型的判断。工具级版本、灰度、旧版本保留和自动化兼容性测试应与 Server 一起维护。
企业落地 MCP 前,应该先检查哪些问题?
Schema 和版本
- 每个工具是否有明确输入输出 Schema?
- 字段单位、时间格式、枚举值、默认值是否写清楚?
- 工具接口是否有版本号?
- 不兼容变更有没有灰度和回滚方案?
- 是否能基于 Schema 做自动化校验?
权限和安全
- Server 能访问哪些文件、目录、数据库和 API?
- 是否区分只读工具和写操作工具?
- 高危操作是否需要人工确认?
- 返回结果是否做了脱敏?
- 是否防路径遍历、SQL 注入、命令注入?
- 第三方 MCP Server 是否经过源码、依赖和权限审核?
可观测性
- 每次用户请求是否有 Trace ID?
- 工具调用参数、耗时、结果摘要、错误码是否有结构化日志?
- 是否能还原一次 Agent 回答背后的完整工具调用链?
- 是否有超时、限流、熔断和重试策略?
成本归因
- 每次调用是否能关联到用户、业务线、工具和会话?
- Token 成本、API 成本、云资源成本是否能拆分统计?
- 是否有配额和预算告警?
- 模型循环调用工具时,是否有调用次数上限?
依赖治理
- MCP SDK、第三方库、第三方 Server 是否有维护者和更新记录?
- 安全漏洞谁负责跟进?
- Server 升级是否有测试环境和回滚策略?
- 是否避免把核心能力押在无人维护的三方扩展上?
这些检查项和普通后端服务没有本质区别。MCP 改变了工具接入方式,不会替代鉴权、审计、日志、版本和限流。
写 MCP Server 时,有什么需要注意的?
别先追求大而全
一个 Server 常见的错误,是用少量“万能工具”承载所有操作:
execute_sql(sql)
file_operation(op, path, data)
call_api(url, method, body)execute_sql、file_operation 这类接口把操作范围和权限都交给模型猜,参数越多,误用和越权的空间越大。按业务动作拆分后,Schema、权限和审计规则才能分别落到具体工具上:
get_user_by_id(id)
list_active_orders(user_id)
read_file(path)
write_report(path, content)工具名可以采用动词加名词,description 则说明适用条件、必填参数和禁用场景。
例如,查慢 SQL 的工具除了“查询慢 SQL 日志”,还应写明:服务响应慢、数据库超时、CPU 飙升且怀疑与数据库相关时使用;用户询问网络或内存问题时不要调用它。这样的约束能减少模型把相近问题送到错误工具的情况。
大文件和长文本要小心
日志、Markdown 文档、网页 HTML 和 CSV 文件可能远超模型上下文。资源接口可以先返回文件名、大小、更新时间、摘要和可读取范围;需要内容时再按 chunk 读取。
单个 chunk 可以控制在约 100KB,资源超过 10MB 时只返回说明和可选读取方式,不直接返回全文。这样既避免一次请求塞满上下文,也能防止 Server 因大文件消耗过多内存或网络资源。
不要把限制绑定到某个模型的 tokenizer。不同模型的 token 计算不同,Server 用字符数或字节数做粗粒度控制即可;上下文裁剪由 Host 或上层应用负责。
安全问题不能靠相信模型解决
文件读取要在路径规范化后检查目录边界,不能让 ../ 越出允许范围。SQL 查询使用参数化语句,不能将模型生成的字符串直接执行。
手机号、邮箱、Token、密钥和内部链接等返回数据需要脱敏。删除文件、修改数据库、发送邮件和调用生产接口等写操作默认收紧权限,并设置人工确认与审计。
模型进入循环时可能反复调用同一工具。限速、超时、熔断和配额要由 Server 自身落实,不能假设 Host 一定会兜底。
Prompt Injection、Token Passthrough、资源级鉴权、本地 Server 隔离和第三方 Skill/MCP 供应链的完整链路,可以继续看 LLM/Agent 安全实战。
MCP Server 最小示例:先跑通一个工具
用官方 Python SDK 写一个天气 Server,大概是这样:
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("weather-server")

@mcp.tool()
def get_weather(city: str) -> str:
    """获取指定城市的天气信息"""
    return f"{city} 今天晴天,温度 25°C"

@mcp.resource("weather://forecast")
def weather_forecast() -> str:
    """返回未来一周天气预报"""
    return "未来七天天气预报..."

if __name__ == "__main__":
    mcp.run()
Claude Desktop 里可以这样配:
{
  "mcpServers": {
    "weather-server": {
      "command": "uv",
      "args": ["run", "--with", "mcp", "/path/to/weather_server.py"]
    }
  }
}
本地调试建议直接用 MCP Inspector:
# Python Server
npx @modelcontextprotocol/inspector uv run --with mcp /path/to/weather_server.py

# Node Server
npx @modelcontextprotocol/inspector node build/index.js
它可以模拟 Host 发请求。Server 是否能连接、工具能不能被发现、参数校验有没有报错,基本都能先在这里看出来。
生产环境别依赖全局 python 里刚好装了 mcp。用虚拟环境解释器,或者像上面这样用 uv run --with mcp ... 显式声明依赖,会稳一点。如果 Claude Desktop 启动失败,先看 mcp.log,别一上来怀疑协议有问题,很多时候只是路径或依赖没配对。
用 Inspector 验证远程 Server
上面的例子通过 stdio 启动本地进程。要观察远程 Server 的连接协商、工具发现和调用,可以继续用 MCP Inspector,换成 Streamable HTTP 连接。
这里以 Parallel Search MCP 为例。它提供网页搜索 web_search 和网页内容提取 web_fetch,匿名入口是 https://search.parallel.ai/mcp,不需要 Parallel 账号或 API Key,免费访问有速率限制。
下面使用 Inspector 2.5.0,需要 Node.js 22.19.0 或更高版本。在终端先列出工具:
npx --yes @modelcontextprotocol/inspector@2.5.0 --cli \
  https://search.parallel.ai/mcp --transport http --method tools/list
--transport http 指定 Streamable HTTP。Inspector 会根据 Server 支持的协议 revision 选择现代无状态流程或兼容的旧版初始化流程,然后发送 tools/list;返回结果中应能看到 web_search、web_fetch 及其参数 Schema。这个匿名示例不传 Authorization 请求头。
接着调用一次搜索工具,查找 Java 虚拟线程的官方资料:
npx --yes @modelcontextprotocol/inspector@2.5.0 --cli \
  https://search.parallel.ai/mcp --transport http \
  --method tools/call --tool-name web_search \
  --tool-arg 'objective=查找 OpenJDK 关于 Java 虚拟线程的官方说明' \
  --tool-arg 'search_queries=["OpenJDK JEP 444 virtual threads"]'
objective 和 search_queries 都是必填参数,后者是 JSON 数组。工具结果会包含来源 URL 和内容摘录,可以沿着链接核对答案。排查时要区分连接失败、JSON-RPC 错误和工具返回的 isError: true;仅收到 HTTP 200 不代表工具执行成功。
执行搜索或提取时,查询词、目标 URL 和传入的目标描述等上下文会发送给 Parallel,请只使用适合交给第三方处理的内容。这里的 CLI 命令执行完会断开连接,不会给其他 Host 安装服务;如果之后在 Agent 中启用这些工具,Agent 也可能按任务需要自行调用,用完可在对应 Host 中禁用或移除连接。
接入时记录协议 revision
MCP 统一了 Host 与外部工具、数据源之间的发现和调用方式,但不会替代业务鉴权、数据权限和执行审计。一个 Server 在某个 Host 中可用,也不代表换到另一个 Host 后仍支持 Sampling、Elicitation、Tasks 等可选能力。
实现最小 Server 时,先固定协议 revision 和 SDK 版本,使用 Inspector 验证连接协商、能力发现、参数校验和错误响应。准备接入远程服务后,再补 OAuth、限流、Trace、版本兼容和回滚;文件与命令工具还要在 Server 侧落实目录校验和沙箱。
总结
MCP 为 Host、Client 和 Server 建立了统一的能力发现与调用方式,解决的是外部工具和数据源的接入问题。模型如何决定调用、业务如何编排、请求是否被授权,仍分别由 Function Calling、Agent/Workflow 和业务安全策略负责。
接入时先确认协议 revision、SDK 与 Host 的能力协商结果,用最小 Server 验证连接、Schema 和错误处理。进入生产环境后,工具权限、数据脱敏、目录或 SQL 校验、限流、审计和版本兼容都需要由 Server 与宿主共同落实。